<?xml version="1.0" encoding="utf-8"?>
<feed xmlns="http://www.w3.org/2005/Atom" xmlns:webfeeds="http://webfeeds.org/rss/1.0">
  <title>フューチャー技術ブログ</title>
  <subtitle>フューチャーの開発者による公式技術ブログです。業務で利用している技術を幅広く紹介します。</subtitle>
  <icon>https://future-architect.github.io/feed_icon.png</icon>
  <logo>https://future-architect.github.io/apple-touch-icon.png</logo>
  <webfeeds:icon>https://future-architect.github.io/apple-touch-icon.png</webfeeds:icon>
  <webfeeds:accentColor>258fb8</webfeeds:accentColor>
  <link href="https://future-architect.github.io/atom.xml" rel="self"/>
  <link href="https://future-architect.github.io/"/>
  <updated>2026-10-15T15:00:00.000Z</updated>
  <id>https://future-architect.github.io/</id>
  <generator uri="https://hexo.io/">Hexo</generator>
  <entry>
    <title>E2E テストのフィードバックループを小さくするためのプラクティス</title>
    <link href="https://future-architect.github.io/articles/20261016a/"/>
    <id>https://future-architect.github.io/articles/20261016a/</id>
    <published>2026-10-15T15:00:00.000Z</published>
    <updated>2026-10-15T15:00:00.000Z</updated>
    <author><name>武田大輝</name></author>
    <content type="html"><![CDATA[<h2 id="はじめに">はじめに</h2><p>従来より E2E テストはテストピラミッドの頂点に置かれ、テストケース数は必要最低限にする（ユニットテストやインテグレーションテストよりも少なくする）というのがセオリーでした。しかしながら昨今、コーディングエージェントの進化により、これまでのユニットテスト中心のテスト戦略から E2E テスト中心の戦略へとシフトする考え方<sup id="fnref:1">1</sup>が広がりつつあります。</p>
<p>そのような変化にかかわらず、テストのフィードバックループを小さくすることはこれまでと変わらず重要です。相対的にフィードバックループが大きいとされている E2E テストの重要度が上がっていくならこれはなおさらです。</p>
<p>言わずもがな、コーディングエージェントや Playwright などのテスト自動化ツールの登場で、E2E テストの実装にかかる時間は劇的に短くなりました。フィードバックループの中にはこれらも含まれますが、この記事で扱うのはテスト基盤にフォーカスしたプラクティスです。具体的には、次の 4 つの取り組みを紹介します。</p>
<ul>
<li>デプロイレスのテスト実行</li>
<li>テストの並列化</li>
<li>自己完結型のテストレポート</li>
<li>分散トレーシング</li>
</ul>
<h2 id="E2E-テストの定義">E2E テストの定義</h2><p>E2E テストという言葉は、人によって解釈が違うので言葉を定義するところからはじめましょう。この記事が前提としているのは、Web ブラウザを操作して画面から入力し、サーバを経由してデータベースにアクセスする、Web フロントエンドの E2E テストです。Web API のエンドポイントを直接コールするテストやモバイルアプリケーションのテストではありません。</p>
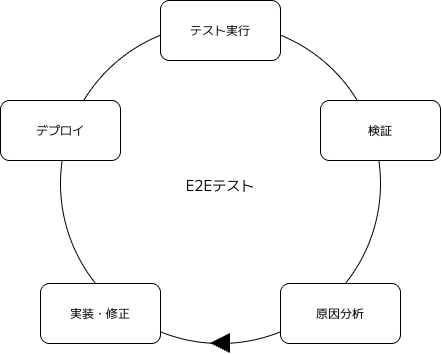
<h2 id="フィードバックループとは">フィードバックループとは</h2><img fetchpriority="high" class="bordered" src="/images/2026/20261016a/フィードバックループ.png" alt="" width="442" height="354">

<p>テストによるフィードバックループとは、コードの実装からテストの実行と結果の確認を経て、失敗していれば原因を調べて修正し、もう一度実行するまでの一連の流れのことです。このループが小さいほど、1 回のテストで確かめる変更を小さく刻むことができ、リグレッションにすぐ気付けます。</p>
<p>このうち、テストコードを作成する時間はコーディングエージェントによって劇的に短くなりました。その結果、フィードバックループの大部分を占めるものは、コードの実装から次のような部分へシフトしつつあります。</p>
<ul>
<li><p><strong>テストが動作する環境を用意する時間</strong><br>E2E テストは、アプリケーションや認証基盤、データベースなどをそろえた環境で動作することが前提となります。これらはクラウド上に用意されるため、変更のたびにデプロイし、反映を待ってからでないとテストを実行できません。</p>
</li>
<li><p><strong>テストを実行する時間</strong><br>E2E テストはブラウザで画面を操作し、サーバやデータベースの応答を待ちながら進むため、ユニットテストに比べて 1 件あたりの実行時間が長くなります。ケース数が増えるほど、全件の実行にかかる時間も延びます。</p>
</li>
<li><p><strong>実行結果を見て品質の確からしさを人が判断する時間</strong><br>E2E テストのコードをコーディングエージェントが実装する場合、単純に実行をパスしただけで本当に品質が担保できるのでしょうか。そもそも期待するアサーションが記述されているか、E2E の操作として表示される画面の見た目や文言は想定どおりか、テストの実行前後でデータベースの状態は期待どおりに変わっているか、といった人間によるゲートチェックは多かれ少なかれ必要です。</p>
</li>
<li><p><strong>不具合の原因を特定する時間</strong><br>E2E テストの失敗は、クライアントサイドアプリケーション、オンラインサービス、データベースのどの階層で発生したとしても、テスト結果としては失敗として現れます。原因を特定するにはそれぞれのログや状態を突き合わせる必要があります。</p>
</li>
</ul>
<p>ユニットテストであれば秒単位ですが、E2E テストではこれが分単位、時間単位になります。</p>
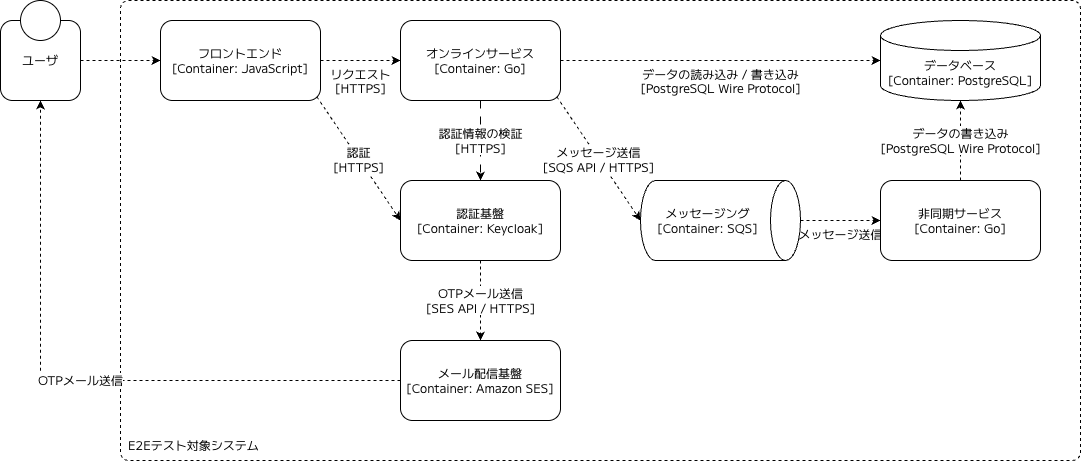
<h2 id="システム概要">システム概要</h2><p>今回取り上げるプラクティスは特定のシステム構成に依存しませんが、具体的に話をイメージしやすいよう E2E テストの対象となるシステムについて目線を合わせておきます。これは実際の現場で取り扱ったシステムを簡略化した C4 コンテナ図です。</p>
<img class="bordered" src="/images/2026/20261016a/C4_コンテナ図.png" alt="" width="1082" height="462" loading="lazy">

<p>システムは、図に示す 7 つの要素で構成されます。ログインにおいて二要素認証（パスワード認証 + ワンタイムパスワード（OTP）認証）を必要とし、書き込みの一部を非同期で実施する、ごく一般的な Web アプリケーションです。</p>
<h2 id="1-デプロイレスのテスト実行">1. デプロイレスのテスト実行</h2><p>E2E テストを、アプリケーションがデプロイされるクラウド環境だけでなく、ローカル環境でも実行できるようにするのは有効なアプローチです。開発者とコーディングエージェントのどちらも、コードを修正すると同時に E2E テストを実行できるので、アプリケーションをデプロイして反映を待つ時間がループから消えます。</p>
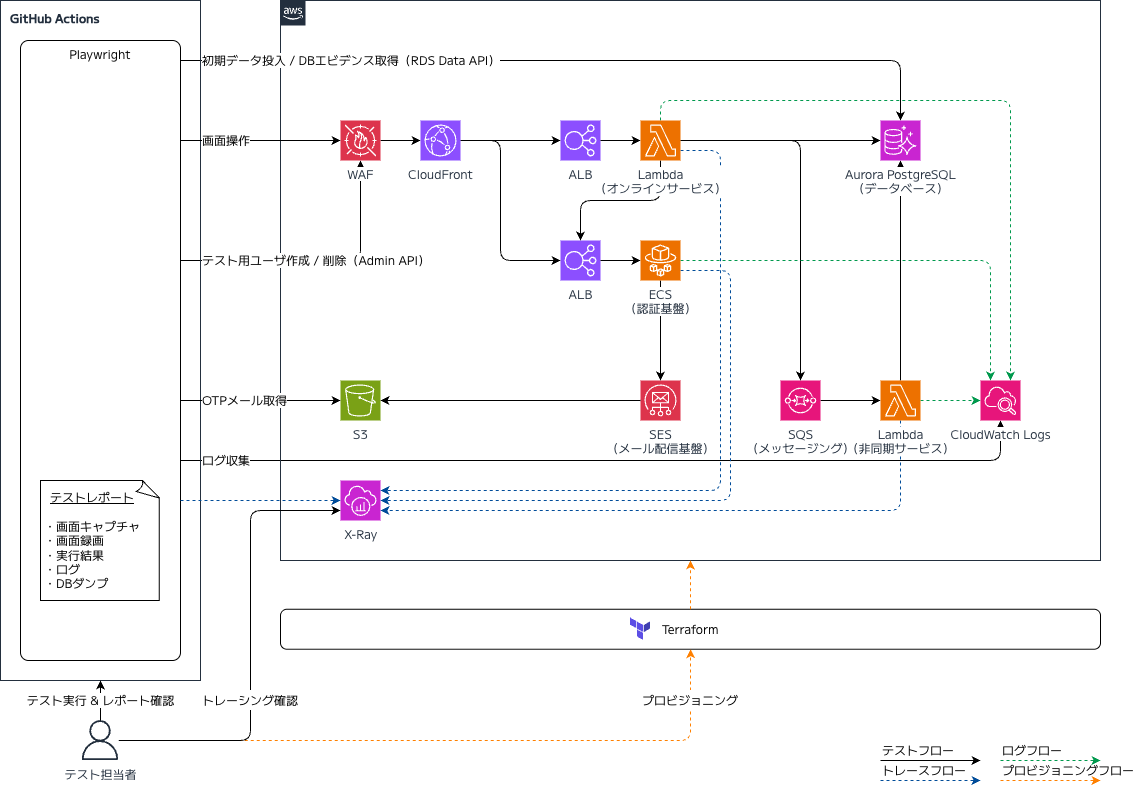
<h3 id="クラウド環境">クラウド環境</h3><p>これは GitHub Actions のランナーから、クラウド環境にデプロイされたさきほどのシステムに対して、Playwright を利用して E2E テストを実行する構成です。</p>
<img src="/images/2026/20261016a/クラウド環境の構成.png" alt="" width="1135" height="790" loading="lazy">

<p>ブラウザからのリクエストは WAF, CloudFront, ALB を経由して Lambda（オンラインサービス）に到達し、Aurora（データベース）の読み書きやメッセージング（SQS）へのイベント送信を実施します。テストに必要なデータは、前処理として Keycloak（認証基盤）の Admin API と RDS Data API 経由で投入しています。</p>
<p>この環境はプロダクション環境とほぼ同じですが、OTP メールの扱いだけが特殊です。Playwright のテストコードから OTP を読めるよう、テスト用ドメイン宛てのメールを SES の受信ルールで S3 のバケットに保存しています。</p>
<p>このようなテスト用の環境があれば E2E テストの自動化は実現できます。ただし、テストを実行するたびにアプリケーションをクラウド環境へデプロイしなければなりません。</p>
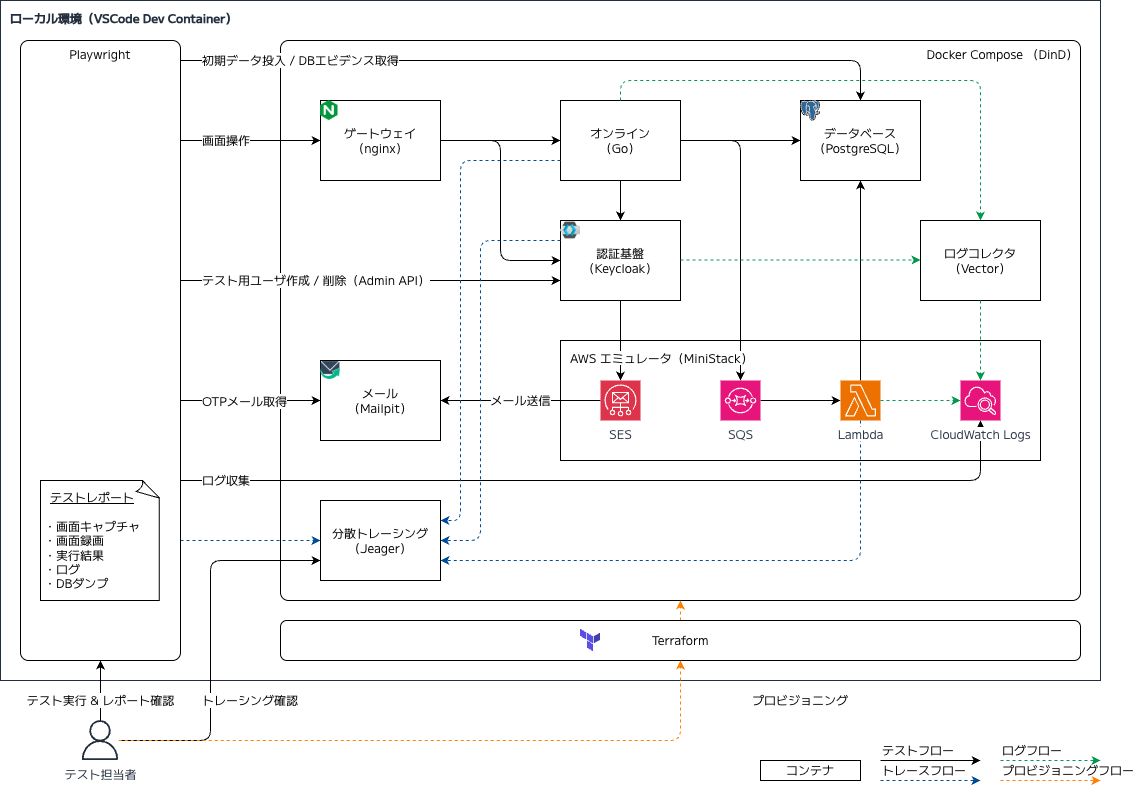
<h3 id="ローカル環境">ローカル環境</h3><p>デプロイレスで E2E テストを実行するために、ローカル環境はクラウド環境と同じ構成を Docker Compose で再現しています。</p>
<img src="/images/2026/20261016a/ローカル環境の構成.png" alt="" width="1135" height="790" loading="lazy">

<p>クラウド環境のコンポーネントとローカル環境のコンポーネントとの対応関係は次の通りです。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 構成要素 / クラウド環境 / ローカル環境"><table>
<thead>
<tr>
<th>構成要素</th>
<th>クラウド環境</th>
<th>ローカル環境</th>
</tr>
</thead>
<tbody><tr>
<td>ゲートウェイ</td>
<td>AWS WAF + Amazon CloudFront + ALB</td>
<td>nginx コンテナ</td>
</tr>
<tr>
<td>オンラインサービス</td>
<td>AWS Lambda</td>
<td>Go コンテナ</td>
</tr>
<tr>
<td>データベース</td>
<td>Amazon Aurora（PostgreSQL）</td>
<td>PostgreSQL コンテナ</td>
</tr>
<tr>
<td>認証基盤</td>
<td>Amazon ECS（Keycloak）</td>
<td>Keycloak コンテナ</td>
</tr>
<tr>
<td>メッセージング</td>
<td>Amazon SQS</td>
<td>MiniStack</td>
</tr>
<tr>
<td>非同期サービス</td>
<td>AWS Lambda</td>
<td>MiniStack</td>
</tr>
<tr>
<td>メール配信基盤</td>
<td>Amazon SES + Amazon S3</td>
<td>mailpit コンテナ</td>
</tr>
<tr>
<td>ログ</td>
<td>Amazon CloudWatch Logs</td>
<td>Vector コンテナ + MiniStack</td>
</tr>
<tr>
<td>トレーシング</td>
<td>AWS X-Ray</td>
<td>Jaeger コンテナ</td>
</tr>
</tbody></table></div>
<p>AWS のエミュレータには MiniStack を使っています。この用途では長らく LocalStack が代表的でしたが、2026 年 3 月に無償の Community 版の提供がおわり、無償プランは非商用に限定されました（LocalStack のお知らせ）。MiniStack は MIT ライセンスで公開されている代替ツールです。SQS から Lambda へのイベントソースマッピングや CloudWatch Logs へのログ連携など細かい再現ができ、Terraform によるプロビジョニングも可能です。</p>
<p>テストコード自体はクラウド環境&#x2F;ローカル環境の両方において共通で、接続先の切り替えは環境変数で制御します。ローカル環境で E2E テストが動くので、コーディングエージェントに実装を任せる場合も、エージェント自身が実装の中で E2E テストを実行できます。失敗すれば原因を自分で特定し、修正してテストを再実行し、自力で直せないときだけ人間に報告するという制御が可能です。</p>
<h3 id="テストのワークフロー">テストのワークフロー</h3><p>ローカル環境とクラウド環境の両方で E2E テストが動くことを前提に、実際にどのようなワークフローでテストを進めていたか紹介します。レーンは、テスト担当者、コーディングエージェント、GitHub Actions の 3 つです。</p>
<img src="/images/2026/20261016a/E2E_テストのワークフロー（BPMN）.png" alt="" width="1200" height="398" loading="lazy">

<p>あくまで主要な部分のみをピックアップしていますが、全体の流れは次の通りです。</p>
<ol>
<li>テスト担当者の指示で、コーディングエージェントが仕様書の規約に従ってテスト仕様書（Markdown 形式）を作成し、担当者がレビューする</li>
<li>テスト担当者の指示で、コーディングエージェントが仕様書と実装規約をもとにテストコードを実装し、ローカル環境で E2E テストを実行する</li>
<li>失敗していればその場で不具合を修正（もしくは Issue を起票してスキップ）して、テストがパスするまで繰り返し、完了したら PR を作成する</li>
<li>PR をトリガに GitHub Actions がランナー上でローカル環境を構築（Docker Compose）して E2E テストを全件実行し、テストレポートを作成する</li>
<li>担当者はテストレポートを見ながら PR をレビューし、不備があれば修正してマージする</li>
<li>毎晩 02:00 に、GitHub Actions がマージ済みの develop ブランチからクラウド環境へ向けて全件 E2E テストを実行する</li>
</ol>
<p>E2E テストが実行されるタイミングは 3 つです。開発時および PR 時は、よりフィードバックループの小さいローカル環境の E2E テストを実行することで、即時に不具合を検知します。忠実性が高い（ただし実行時間もかかる）クラウド環境での E2E テストは日次で実行し、実際のインフラを通じて全体の動作を最終確認します。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 実行場所 / トリガ / ブランチ"><table>
<thead>
<tr>
<th align="left">実行場所</th>
<th align="left">トリガ</th>
<th align="left">ブランチ</th>
</tr>
</thead>
<tbody><tr>
<td align="left">コーディングエージェントのローカル環境</td>
<td align="left">実装中随時</td>
<td align="left">機能ブランチ（feature）</td>
</tr>
<tr>
<td align="left">GitHub Actions ランナーのローカル環境</td>
<td align="left">PR</td>
<td align="left">機能ブランチ（feature）</td>
</tr>
<tr>
<td align="left">GitHub Actions ランナーからクラウド環境</td>
<td align="left">日次</td>
<td align="left">デフォルトブランチ（develop）</td>
</tr>
</tbody></table></div>
<p>検出した不具合の数を比べると、ローカル環境の E2E テストがクラウド環境の E2E テストを大きく上回っていたため、多くの不具合を早期に検知し、修正できる結果となりました。</p>
<h2 id="2-テストの並列化">2. テストの並列化</h2><p>E2E テストを並列に実行することで、テストケースが増えても実行時間の増加を抑えられます。Playwright は <code>workers</code> と <code>fullyParallel</code> の設定だけで、ファイルをまたいでもファイル内でもケースを並列に動かせます。</p>
<p>ただし並列化するには、同時に走るテストどうしでデータがコンフリクトしないようにしなければなりません。ここはシステムの特性によって細かい設計が必要になるところです。今回のようにデータがユーザに紐づくシステムであれば、テストごとに前処理でユーザを作成し、後処理でそのユーザと、そのユーザに関連するデータを削除する運用がベースになるでしょう。</p>
<p>実測値としては GitHub Actions の 4 コアのランナーで約 160 件のテストを 13 分程度の処理時間で実行できています。ただし、ランナーの環境構築に半分以上の時間がかかっているなど、まだ改善の余地はあります。実行時間をさらに突き詰めた事例としては、「E2Eテストをユニットテスト並みの実行時間に」が参考になります。</p>
<h2 id="3-自己完結型のテストレポート">3. 自己完結型のテストレポート</h2><p>テストの実行結果やエビデンスを Playwright の HTML レポートに集約することで、テストの確からしさを人が判断する時間を短縮できます。いわゆる Human-in-the-Loop のためのアウトプットとなるものです。</p>
<p>レポートで確認できる情報は次の 6 種類です。担当者の確認は、このレポートで完結します。アサーションが期待どおりか、画面の見た目や文言が想定どおりか、データベースの状態が期待どおりに変わったかを、レポートの中で順に見ていきます。ステークホルダに対してテストのエビデンスの提出が求められる場合も、このレポートをそのまま渡すだけで、別途エビデンスを集める必要はありません。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 情報 / Playwright 標準 / 説明"><table>
<thead>
<tr>
<th>情報</th>
<th align="center">Playwright 標準</th>
<th>説明</th>
</tr>
</thead>
<tbody><tr>
<td>実行結果</td>
<td align="center">〇</td>
<td>テストごとの合否、所要時間、テストステップ、失敗した検証</td>
</tr>
<tr>
<td>画面キャプチャ</td>
<td align="center">〇</td>
<td>検証した画面ごとのスクリーンショット</td>
</tr>
<tr>
<td>画面動画</td>
<td align="center">〇</td>
<td>テスト全体の操作の録画</td>
</tr>
<tr>
<td>操作記録</td>
<td align="center">〇</td>
<td>操作ごとの DOM とネットワークの記録（失敗したテストのみ）</td>
</tr>
<tr>
<td>データベースレコード</td>
<td align="center"></td>
<td>テストで状態が変わるテーブルの実行前後のレコード</td>
</tr>
<tr>
<td>コンテナのログ</td>
<td align="center"></td>
<td>テストごとに集めた各コンテナのログ</td>
</tr>
</tbody></table></div>
<p>Playwright 標準で提供されないデータベースレコードの添付やコンテナログの添付は、カスタムレポーターを作り込んで実現しています。</p>
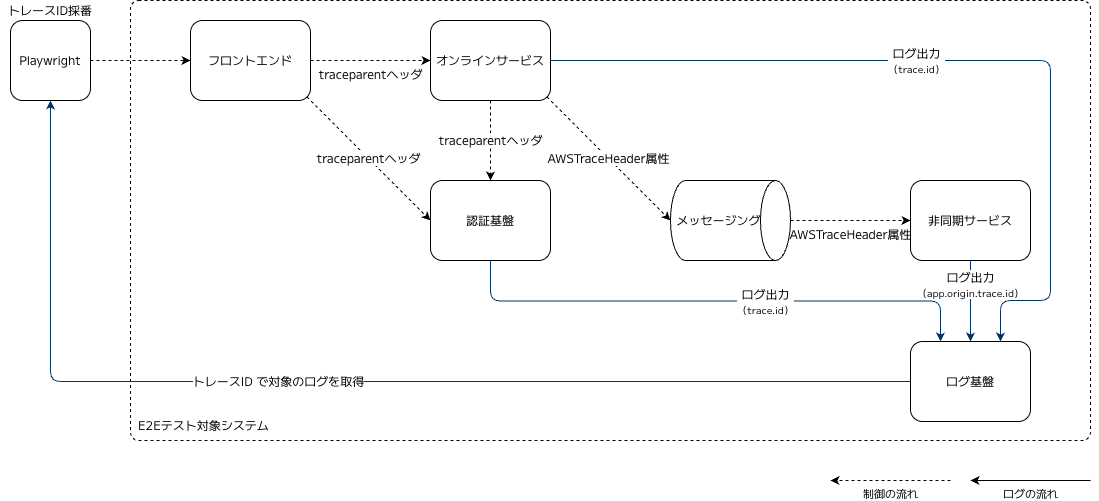
<p>ログの集約には、このあと説明する分散トレーシングの伝播のしくみを利用しています。Playwright はテストごとに一意なトレース ID を払い出し、ブラウザから送るリクエストの <code>traceparent</code> ヘッダに載せます。受け取った値は、オンラインサービスから認証基盤、メッセージング、非同期サービスへと伝播し、各コンテナのログに出力されます。ログはすべて CloudWatch Logs に集約される<sup id="fnref:2">2</sup>ので、テストの終了後に Playwright がトレース ID をキーにログを検索し、テストごとにレポートへ添付します。</p>
<img class="bordered" src="/images/2026/20261016a/トレース_ID_の伝播.png" alt="" width="1099" height="501" loading="lazy">

<p>「The birth of the Software Verification Engineer」では、エージェントがコードとテストを書く時代には人の役割が検証のしくみ作りに移り、証拠は UI の変更なら操作の録画のように人がレビューしやすい形にまとめるべきだと述べています。このテストレポートも、その考え方に沿ったものです。</p>
<h2 id="4-分散トレーシング">4. 分散トレーシング</h2><img src="/images/2026/20261016a/分散トレーシング_UI.png" alt="" width="1200" height="664" loading="lazy">

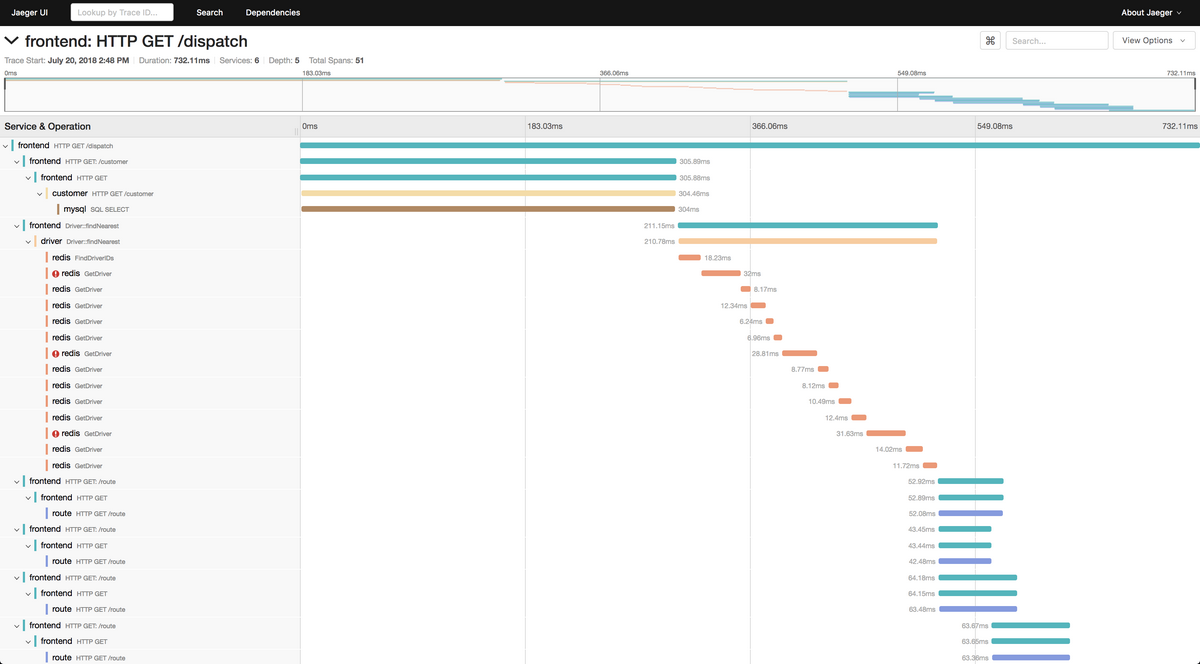
<p>テスト 1 件の処理の流れを、ブラウザの操作からオンラインサービス、認証基盤、メッセージングに至るまで 1 本のトレースとして可視化することで、不具合の原因を特定する時間を短縮できます（画像は 公式サイト から引用）。トレースとは、処理の 1 区間を開始と終了の時刻、親子関係、属性とともに記録したスパンの集まりです。E2E テストの失敗原因を特定するには、どの区間で時間がかかり、どの呼び出しで失敗したかを把握しなければなりませんが、スパンの所要時間と親子関係を見ればその両方が分かります。</p>
<p>今回のシステムにおいてスパンを送っているのは次の 4 つです。</p>
<ul>
<li><p><strong>Playwright</strong><br>テストの開始時にルートスパンを作成し、終了時にテスト名と実行結果（成功&#x2F;失敗）を付けて送ります。各サービスのスパンはこのルートスパンの子になります。</p>
</li>
<li><p><strong>オンラインサービス</strong><br>リクエストごとにスパンを作成し、認証基盤の呼び出し、AWS サービスの呼び出し、データベースアクセスを子スパンとして記録します。</p>
</li>
<li><p><strong>認証基盤</strong><br>リクエストごとにスパンを作成し、認証処理の内容を記録します。</p>
</li>
<li><p><strong>非同期サービス</strong><br>起動ごとにスパンを作成し、AWS サービスの呼び出しとデータベースアクセスを子スパンとして記録します。</p>
</li>
</ul>
<p>ローカル環境では、これらのスパンを OSS の分散トレーシング基盤である Jaeger に送ります。Jaeger は受け取ったスパンをトレース ID ごとに 1 本のトレースとして組み立てるので、テスト名を検索すると、ブラウザの操作からオンラインサービスの処理、認証基盤への呼び出し、イベントの送信までが 1 本のトレースとして並びます<sup id="fnref:3">3</sup>。失敗したテストのトレース ID はテストレポートに出力されるので、テストレポートからそのまま Jaeger の画面に遷移してトレースの詳細を確認できます。</p>
<p>クラウド環境では、スパンの送り先を CloudWatch の Transaction Search（X-Ray の OTLP エンドポイント）にしています。Lambda はコンテナイメージに同梱した OpenTelemetry Collector を、Keycloak は同じ ECS タスクのサイドカーとして動く ADOT Collector を経由して、X-Ray へ送ります。X-Ray はスパンを CloudWatch Logs のロググループ <code>aws/spans</code> に書き込むので、ログと同じ Logs Insights でトレースとログを突き合わせられます。</p>
<h2 id="おわりに">おわりに</h2><p>E2E テストのフィードバックループを小さくするためのプラクティスとして、デプロイレスのテスト実行、テストの並列化、自己完結型のテストレポート、分散トレーシングの 4 つを紹介しました。コーディングエージェントの普及で E2E テストの自動化はこれからますます広がっていくと思われるので、今回紹介したようなアプローチはより重要になっていくでしょう。</p>
<div id="footnotes"><hr><div id="footnotelist"><ol style="list-style:none; padding-inline-start: 0;"><li id="fn:1"><span style="vertical-align: top; padding-inline-end: 10px;">1.</span><span style="vertical-align: top;">この考え方をめぐる議論は、2026 年 9 月末に X の トレンド になりました。</span> ↩</li><li id="fn:2"><span style="vertical-align: top; padding-inline-end: 10px;">2.</span><span style="vertical-align: top;">ローカル環境では Vector を利用してコンテナのログを MiniStack の CloudWatch Logs に集約しています。</span> ↩</li><li id="fn:3"><span style="vertical-align: top; padding-inline-end: 10px;">3.</span><span style="vertical-align: top;">非同期サービスのスパンはテストのトレースには含めず、別のトレースとして作成したうえでテストのトレースへリンクを張っています。OpenTelemetry のメッセージングのセマンティック規約では、キューから取り出したメッセージを処理するスパンは送信側のトレースの子にせず、リンクで結ぶことが 推奨 されているためです。非同期サービスのログで、Playwright が採番したトレース ID を <code>trace.id</code> ではなく <code>app.origin.trace.id</code> という別の属性として出力しているのもこのためです。</span> ↩</li></ol></div></div>]]></content>
    <summary type="html">コーディングエージェントの普及で E2E テストの比重が上がるなか、テスト基盤の側でフィードバックループを小さくする4つのプラクティス（デプロイレスのテスト実行・テストの並列化・自己完結型のテストレポート・分散トレーシング）を紹介します。</summary>
    <category term="DevOps" scheme="https://future-architect.github.io/categories/DevOps/"/>
    <category term="DockerCompose" scheme="https://future-architect.github.io/tags/DockerCompose/"/>
    <category term="E2Eテスト" scheme="https://future-architect.github.io/tags/E2E%E3%83%86%E3%82%B9%E3%83%88/"/>
    <category term="OpenTelemetry" scheme="https://future-architect.github.io/tags/OpenTelemetry/"/>
    <category term="Playwright" scheme="https://future-architect.github.io/tags/Playwright/"/>
  </entry>
  <entry>
    <title>E2Eテストを爆速にする: オンメモリPostgreSQLのpgmem</title>
    <link href="https://future-architect.github.io/articles/20261015a/"/>
    <id>https://future-architect.github.io/articles/20261015a/</id>
    <published>2026-10-14T15:00:00.000Z</published>
    <updated>2026-10-14T15:00:00.000Z</updated>
    <author><name>澁川喜規</name></author>
    <content type="html"><![CDATA[<h1 id="はじめに">はじめに</h1><p>古来よりDBにモックを使うとか使わないとか話題になるのは、DBというものをプログラムからコントロールするのに制約が多かったからではないかと思います。で、オンメモリのDBのH2を使うなり、SQLiteを使うなどしようとしても、今度は使うDBMSとの差が出てしまってテストとしての品質が上がらないと。</p>
<p>トランザクションを使って戻す、みたいな方法もありますが、トランザクション自体をネストはできないし、セーブポイントを使うのも色々大変です。どうしてもDBを使うとテストが遅くなる、というイメージがつきまといます。</p>
<p>じゃあ完全にオンメモリで動いてテストケース分スケールさせるPostgreSQLを作ってみたら良さそうでは？と作ってみました。</p>
<ul>
<li>pgmem</li>
</ul>
<h2 id="テストダブル">テストダブル</h2><p>テストダブルという言葉を聞き慣れない人もいるとおもいます。テストしたい対象がいろいろ気軽な実行が難しい部品に依存している場合にそれを置き換えるものの相性です。おおまかに「モック」と呼ばれることも多いのですが、マーチン・ファウラーの提唱する細かい分類があります。Androidのテストダブルの説明を@ymotongpooさんに教えてもらいましたが、よくまとまっていますね。</p>
<p>この記事の注釈にもありますが、テストダブルのフレームワークによって用語や機能が変わることが多いです。本物っぽく振る舞うが検証はしないものでも「モック」を名乗ってたり。</p>
<ul>
<li>フェイク<ul>
<li>クラスの「機能する」実装を持つテストダブルであるものの、本番環境には適さないテスト用のもの</li>
<li>本物っぽく振る舞う既製品。検証はしない</li>
</ul>
</li>
<li>モック<ul>
<li>プログラムされたとおりに動作し、インタラクションに関する期待値を持つテストダブル</li>
<li>本物っぽく振る舞うようにコーディングをする。検証もする</li>
</ul>
</li>
<li>スタブ<ul>
<li>プログラムどおりに動作させるが、そのインタラクションについては期待しないテストダブル</li>
<li>本物っぽく振る舞うようにコーディングをする。検証はしない</li>
</ul>
</li>
<li>ダミー<ul>
<li>渡されるが使用されないテストダブル（パラメータとして指定する必要がある場合など）</li>
<li>穴埋め</li>
</ul>
</li>
<li>スパイ<ul>
<li>実際のオブジェクトをラップし、モックと同様に追加情報を追跡する</li>
<li>本物とのやりとり記録をもとに検証する</li>
</ul>
</li>
<li>シャドウ<ul>
<li>アプリケーションコードに触れずに外部から依存のプログラムを差し替える</li>
<li>設定部分の自動化。検証はしない</li>
</ul>
</li>
</ul>
<p>このブログでもたまに話題に上がるのが「モックよりもフェイク」というあたりですね。モックはそのテストのための手作りされた部品で、高速には実行できるものの、モックそのものが間違っていた場合のセーフティネットがない、本家側が後から動作変更しても気づけないあたり、大きな問題があります。「テストしたつもり」になりがち。通常では起きえない異常ケースの再現(BeOSの今パソコンが火事で燃えているか返すAPIとか)などモックでしかやりづらいケースはありますが、フェイクが使えるならそちらの方が確実です。</p>
<p>今回作ったのはPostgreSQLのデータベースをまるごとテスト用に改造してライブラリ化するということでフェイクです。プラスアルファで、本体コードに手を加えずに接続先をテスト用のデータベースに変えるシャドウ機能もテスト用APIとして提供しています。</p>
<p>なお、シャドウは今回初めて知りましたが、Python製のAWSエミュレータのmotoが提供していて、前から良いなと思っていました。</p>
<div class="code-block"><figure class="highlight python"><input type="checkbox" id="code-wrap-10h99e2-1" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-10h99e2-1" title="コードの折り返しを切り替える"></label><figcaption><span>参考にしたmotoが提供するS3のシャドウ機能</span></figcaption><table><tr><td class="code"><pre><span class="line"><span class="keyword">import</span> boto3</span><br><span class="line"><span class="keyword">from</span> moto <span class="keyword">import</span> mock_aws</span><br><span class="line"><span class="keyword">from</span> mymodule <span class="keyword">import</span> MyModel</span><br><span class="line"></span><br><span class="line"><span class="comment">## このデコレータをつけるとAWS SDKのbotoがローカルエミュレータに向くようになる</span></span><br><span class="line"><span class="meta">@mock_aws</span></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">test_my_model_save</span>():</span><br><span class="line">    <span class="comment"># 以下のロジックはAWS_ENDPOINTなどを変更したりせずに</span></span><br><span class="line">    <span class="comment"># テスト環境向けに動く</span></span><br><span class="line">    conn = boto3.resource(<span class="string">&quot;s3&quot;</span>, region_name=<span class="string">&quot;us-east-1&quot;</span>)</span><br><span class="line">    conn.create_bucket(Bucket=<span class="string">&quot;mybucket&quot;</span>)</span><br><span class="line">    model_instance = MyModel(<span class="string">&quot;steve&quot;</span>, <span class="string">&quot;is awesome&quot;</span>)</span><br><span class="line">    model_instance.save()</span><br><span class="line">    body = conn.Object(<span class="string">&quot;mybucket&quot;</span>, <span class="string">&quot;steve&quot;</span>).get()[<span class="string">&quot;Body&quot;</span>].read().decode(<span class="string">&quot;utf-8&quot;</span>)</span><br><span class="line">    <span class="keyword">assert</span> body == <span class="string">&quot;is awesome&quot;</span></span><br></pre></td></tr></table></figure></div>

<h2 id="アーキテクチャ">アーキテクチャ</h2><p>PGLiteというWASMでビルドされているPostgreSQLがあります。基本的にはその延長です。WASMのランタイムはGoなどでも使えますが、そのままだとネイティブと比べるとパフォーマンスが出ないので、wasm2goを使ってGoに変換してビルドしています。また、crypto系アルゴリズムなどGoネイティブロジックが使えるものはなるべく寄せるようにしてパフォーマンスとサイズを最適化するようにしています。</p>
<ul>
<li>ワイヤプロトコルはネイティブのPostgreSQLと同じなので、マイグレーションツールとかいろいろ既存のものが流用可能</li>
<li>Pure GoなのでGoユーザーにはビルドが簡単<ul>
<li>Java, Python, Node.jsのパッケージも公開中。Goで作ったバイナリのサーバーを起動してstdioで指令して使う方式</li>
</ul>
</li>
<li>オンメモリのみ対応でとにかく起動が高速だし、クエリーなども遅くない</li>
<li>初期化が終わったストレージを丸ごとフォークして使うのに対応<ul>
<li>スキーマ投入と初期データを入れた後に、そこからフォークして書き込みのテストを並列で走らせたりが自由にできる</li>
</ul>
</li>
<li>PGLiteはシングルユーザーモードしか対応していないが、通常のマルチユーザーモードにも対応させているので複数のセッションからデッドロックのテストもできる</li>
<li>https://www.pgextensions.org などを参考に、よく利用される拡張機能は組み込み済み</li>
</ul>
<h2 id="テスト用API">テスト用API</h2><p>DBを起動すると、localhostでポートを開いてPostgreSQLのエンドポイントが作られるのでどんなフレームワークなどでも接続さえすれば動きます。ただ、テストのための準備とかそのためのバックドアを作るとかは本来やりたくないことですので、一部フレームワーク限定になるかもしれませんが、ショートカットのテスト用APIも作っています。これがテストシャドウ。</p>
<p>DBを使ったテストは大きく3種類に分かれるかなと思います。</p>
<ul>
<li>ユニットテスト: DB読み書きのクラスやモジュールのテスト</li>
<li>APIテスト: HTTPのWebAPIを使う</li>
<li>フロントエンドのE2Eテスト: Playwrightを使う</li>
</ul>
<p>それぞれのケースごとのテストが短く書けるようなAPIを入れています。</p>
<div class="code-block"><figure class="highlight go"><input type="checkbox" id="code-wrap-10h99e2-2" class="code-wrap-input" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-10h99e2-2" title="コードの折り返しを切り替える"></label><figcaption><span>Goのユニットテスト</span></figcaption><table><tr><td class="code"><pre><span class="line"><span class="function"><span class="keyword">func</span> <span class="title">TestCreateUser</span><span class="params">(t *testing.T)</span></span> &#123;</span><br><span class="line">	fx.ShadowPG(t) <span class="comment">// テスト専用フォーク準備</span></span><br><span class="line">	repo, err := NewUserRepository()</span><br><span class="line">	<span class="keyword">if</span> err != <span class="literal">nil</span> &#123; t.Fatal(err) &#125;</span><br><span class="line">	t.Cleanup(<span class="function"><span class="keyword">func</span><span class="params">()</span></span> &#123; repo.Close() &#125;)</span><br><span class="line"></span><br><span class="line">	<span class="keyword">if</span> err := repo.Create(t.Context(), <span class="string">&quot;ada@example.com&quot;</span>); err != <span class="literal">nil</span> &#123; t.Fatal(err) &#125;</span><br><span class="line">	<span class="keyword">if</span> got, err := repo.Count(t.Context()); err != <span class="literal">nil</span> || got != <span class="number">1</span> &#123;</span><br><span class="line">		t.Fatalf(<span class="string">&quot;count = %d, %v&quot;</span>, got, err)</span><br><span class="line">	&#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure></div>

<div class="code-block"><figure class="highlight python"><input type="checkbox" id="code-wrap-10h99e2-3" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-10h99e2-3" title="コードの折り返しを切り替える"></label><figcaption><span>PythonのAPIテスト</span></figcaption><table><tr><td class="code"><pre><span class="line"><span class="meta">@pytest.fixture</span></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">client</span>():</span><br><span class="line">    <span class="keyword">with</span> TestClient(create_app()) <span class="keyword">as</span> client:</span><br><span class="line">        <span class="keyword">yield</span> client</span><br><span class="line"></span><br><span class="line"><span class="meta">@shadow_pg(<span class="params">live=<span class="literal">True</span></span>)</span></span><br><span class="line"><span class="keyword">def</span> <span class="title function_">test_create_order</span>(<span class="params">client</span>):</span><br><span class="line">    response = client.post(<span class="string">&quot;/orders&quot;</span>, data=&#123;<span class="string">&quot;sku&quot;</span>: <span class="string">&quot;A&quot;</span>&#125;)</span><br><span class="line">    <span class="keyword">assert</span> response.status_code == <span class="number">201</span></span><br></pre></td></tr></table></figure></div>

<div class="code-block"><figure class="highlight java"><input type="checkbox" id="code-wrap-10h99e2-4" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-10h99e2-4" title="コードの折り返しを切り替える"></label><figcaption><span>MicronautのPlaywrightのE2Eテスト</span></figcaption><table><tr><td class="code"><pre><span class="line"><span class="meta">@UsePlaywright</span></span><br><span class="line"><span class="meta">@ShadowPg(schema = &quot;db/schema.sql&quot;)</span></span><br><span class="line"><span class="keyword">class</span> <span class="title class_">OrdersE2ETest</span> &#123;</span><br><span class="line">    <span class="meta">@Inject</span> EmbeddedServer app;</span><br><span class="line"></span><br><span class="line">    <span class="meta">@Test</span> <span class="keyword">void</span> <span class="title function_">createsAnOrder</span><span class="params">(Page page)</span> &#123;</span><br><span class="line">        page.navigate(app.getURI().resolve(<span class="string">&quot;/orders&quot;</span>).toString());</span><br><span class="line">        page.getByText(<span class="string">&quot;New order&quot;</span>).click();</span><br><span class="line">        assertThat(page.getByText(<span class="string">&quot;Order created&quot;</span>)).isVisible();</span><br><span class="line">    &#125;</span><br><span class="line"></span><br><span class="line">    <span class="meta">@Test</span> <span class="keyword">void</span> <span class="title function_">startsFromPreparedDataAgain</span><span class="params">(Page page)</span> &#123;</span><br><span class="line">        page.navigate(app.getURI().resolve(<span class="string">&quot;/orders&quot;</span>).toString());</span><br><span class="line">        assertThat(page.getByText(<span class="string">&quot;No orders&quot;</span>)).isVisible();</span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure></div>

<p>といっても、接続先の変更はやはりちょっとは手を加える必要があります。別プロセスで起動する場合は起動オプションなどでDB接続先が変更できるようにする必要があったりします。Go以外はDBドライバ周りに介入して接続先を動的に変えるのはできますが、Goは環境変数で接続先を渡す必要があります。overlay使えばドライバに介入できるかもしれません・・・eBPFとか使っちゃうのも手ですが、強い権限が必要に・・・</p>
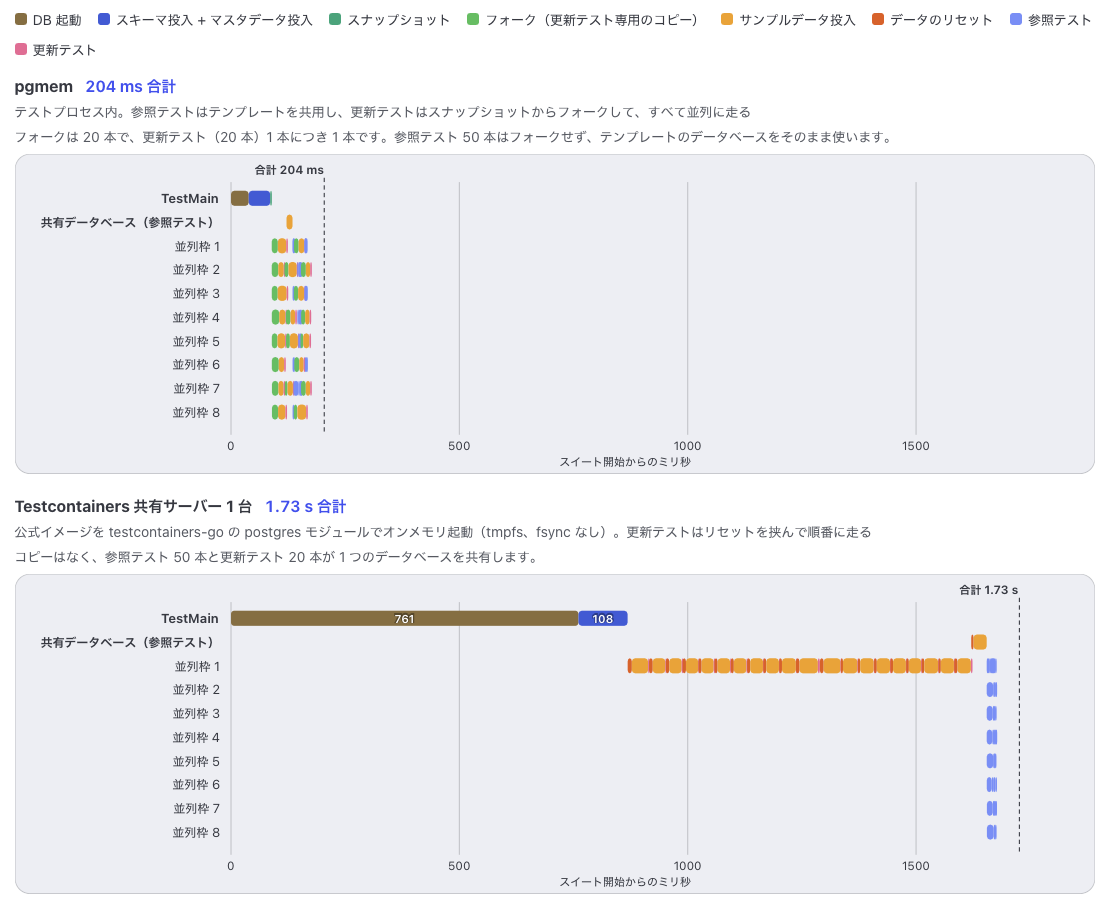
<h2 id="パフォーマンス">パフォーマンス</h2><p>以下のグラフを見ていただいたら一目瞭然ですが、8コアマシンで8コア綺麗に使い切って並列で高速に動いていることがわかります。知り合いが試してくれたところ、60秒かかっていたテストが5秒になったとか。TestContainersもreadのみのテストは並列で走らせたりもしていますが、フォークによるスケールは使いやすくてパフォーマンスもすごいでます。</p>
<p>ただ、このプログラム自体、互換性を重視してPostgreSQLのコードをそのまま使うという方針なのでストレージをオンメモリにする以外のチューニングはやっていません。最速を狙うなら方言を吸収しつつSQLiteに投げる方が早いと思います。最終的にCPUがボトルネックになるはずでvCPU 2個とかそういう環境で実行するとそこまで高速化はしないと思います。社内で他の人が試した所、vCPU 4個で6秒が4秒にはなったぐらいだったと(起動時間抜いて？)。その代わりストアドプロシージャも含めて全部動いたと聞きました。</p>
<img fetchpriority="high" class="bordered" src="/images/2026/20261015a/benchmark.png" alt="" width="1109" height="906">

<p>ちなみに、よくテストで使われる人気のTestcontainersですが、ストレージをメモリ上におくtmpfsモードがあるのにあまり知られていない気がします。Testcontainersを使われている方は、ぐぐってこれをオンにするだけで2倍早くなります。</p>
<p>ただ、シャドウAPIを使うと、並列性の制御を完全に行えるわけではない（動いているウェブサーバーの接続先をテストケースごとに置き換えるとかは難しいし、テストケースごとにウェブサーバー起動するのはオーバーヘッドが大きい）ので、ワーカーを分けてワーカー単位の並列にはなります。もちろん、1つのテストケースの高速化の恩恵はあるかと思います。</p>
<h2 id="実装">実装</h2><p>思いつきでClaude Codeに依頼したらさくっと動くところまでやってくれました。ただ、バイナリサイズをなるべく小さくしたり、性能を上げたり、gitの差分が出にくいようにwasm2goにパッチをあててみたり、拡張機能を追加したり、マルチユーザーモードの実現などいろいろ試行錯誤はしました。だいたいできることはやりきったかな、と思います。API周りはClaudeの週間の枠を使い切ったのでCodexにお願いしたりしていますが。</p>
<p>wasm2goはもともとはアドレスがむき出しの巨大なgoファイルいくつかを出力するスタイルとなっているのですが、それだとGitの差分がすごく出てしまうので元ファイル名を復元してファイル分割したりとか色々やったり、SIMD対応を入れたりしています。ただ、Go本体にSSE世代の命令を多用し、AVX世代の命令を使おうとすると命令セット切り替えでパフォーマンスが出ないという不具合があり、良い感じの実際動作確認できていないのでいつPRを出そうかなと考え中。あと、Go 1.27のAPIが安定しているsimdパッケージは対応している命令が少なく、simd&#x2F;simdarchは性能が良いもののAPIが安定しない。</p>
<h2 id="バージョンルール">バージョンルール</h2><p>単純なセマンティックバージョニングには従わない方針にしようと思っています。末尾がこのOSS自身のバージョンですが、依存しているPostgreSQLのバージョンごとに並列させる必要があるので以下のルールにしています。</p>
<ul>
<li>1.18.x: 18系のバージョン</li>
<li>1.19.x: 19系のバージョン</li>
</ul>
<p>.xの部分箱のパッケージにとっての唯一のバージョンなので、場合によっては後方互換性がなくなるかもしれないし、新機能が増えるかもしれません。まああまりないとは思いますが。</p>
<p>なお、まだ19はbeta4なので、0.19.xにしています。19が出たら1.19にあげようかと。</p>
<h2 id="まとめ">まとめ</h2><p>AIのおかげで、何かをやる片手間でどんどんアイディアが検証できて楽しいですね。作りたいものがたくさんあるけど、手をだす時間がないな、という人には今はボーナスタイムですね。</p>
<p>モックを使わずとも、うまくE2Eテストに埋め込んでE2Eテストも並列でやらせたりとか、より柔軟なシステム開発ができそうです。</p>
<h2 id="おまけ">おまけ</h2><p>オンメモリ版のPostgreSQLができたぜ、といって知人にお披露目したところ、MonotaroのmasahitoさんがMariaDB版を作ってくれました</p>
<ul>
<li>mariamem</li>
</ul>
<p>OpenSearchとValkeyも作成中です。コアはできたけど、使いやすいテストAPIとかはまだです。AI時代もコア部分は一瞬でできても、ベンチマークを取って改善したり、使いやすいAPIを作ったり、インストールしやすいように整備したりすると、だいたいその10倍以上は手間がかかりますね。</p>
]]></content>
    <summary type="html">完全にオンメモリで動き、テストケースごとにフォークしてスケールするPostgreSQL「pgmem」を作りました。テストダブルの分類からアーキテクチャ、テスト用API、パフォーマンスまでを紹介します。</summary>
    <category term="Programming" scheme="https://future-architect.github.io/categories/Programming/"/>
    <category term="E2Eテスト" scheme="https://future-architect.github.io/tags/E2E%E3%83%86%E3%82%B9%E3%83%88/"/>
    <category term="PostgreSQL" scheme="https://future-architect.github.io/tags/PostgreSQL/"/>
    <category term="WebAssembly" scheme="https://future-architect.github.io/tags/WebAssembly/"/>
  </entry>
  <entry>
    <title>技育祭2026秋で「“優秀な誰か”の下位互換にならないために」というタイトルで発表してきました</title>
    <link href="https://future-architect.github.io/articles/20261014a/"/>
    <id>https://future-architect.github.io/articles/20261014a/</id>
    <published>2026-10-13T15:00:00.000Z</published>
    <updated>2026-10-13T15:00:00.000Z</updated>
    <author><name>永井優斗</name></author>
    <content type="html"><![CDATA[<img fetchpriority="high" src="/images/2026/20261014a/top.jpg" alt="" class="bordered" width="960" height="540">

<p>Future Value Group（FVG）＆CodeCamp兼務出向中の永井です。</p>
<p>2026&#x2F;10&#x2F;10開催された「技育祭2026秋 Day1」（オンライン開催）に登壇しました。タイトルは「“優秀な誰か”の下位互換にならないために ※ただし”誰か”にはAIを含む」です。</p>
<p>ちょっと挑発的なタイトルでしたが、その結果なのか多くの方にご覧いただけたようです。</p>
<p>Zoom上で多くの質問をいただきましたが、時間の都合上一部しか回答できなかったので、この記事にて答えていきます。</p>
<iframe class="speakerdeck-iframe" frameborder="0" src="https://speakerdeck.com/player/bae745fa88aa4f0ea395b52c135ec6cc" title="“優秀な誰か”の下位互換にならないために ※ただし”誰か”にはAIを含む" allowfullscreen="true" style="border: 0px; background: padding-box padding-box rgba(0, 0, 0, 0.1); margin: 0px; padding: 0px; border-radius: 6px; box-shadow: rgba(0, 0, 0, 0.2) 0px 5px 40px; width: 100%; height: auto; aspect-ratio: 560 / 315;" data-ratio="1.7777777777777777"></iframe>

<h2 id="発表したこと">発表したこと</h2><p>キャリアは会社や環境によって変わるので、普遍的な正解は話せません。自分自身の社会人経験での失敗談も含めて、フューチャーで働く自分の実体験をもとに話しました。</p>
<p>今回は人材・エンジニアの「コモディティ化」の問題意識から開始しました。</p>
<p>単一の物差しで勝負すると、自分より優秀な誰かがいるだけで下位互換になる。そしてその「優秀な誰か」に今はAIも入ってくる。そのために、自分にしかできない、模倣されない価値をどう作っていくかをテーマにお話しています。自分自身の経験を掛け合わせて「この人に頼む理由」を作る話です。</p>
<p>自分の経験とともに、経営学の「VRIO分析」でキャリアの強みを整理しています（一応コンサルタント・中小企業診断士なので）。</p>
<p>学生のみなさんには、「あなたの人生は誰にも模倣できない」をキーワードに、これまでの経験を価値へと編集することをメッセージとしました。これまでの経験も、後から意外な形でつながるかもしれません。</p>
<h2 id="聴いてくださった方の感想">聴いてくださった方の感想</h2><p>ハッシュタグ「#技育祭 #ホールB」で、感想をいただきました。ありがとうございます！</p>
<blockquote class="twitter-tweet" data-lang="ja"><p lang="ja" dir="ltr">フューチャーアーキテクトのセッション<br>ものすごくためになった。<br>役職に囚われずに行動を言語化できるようになりたい。#技育祭 #ホールB</p>&mdash; どっかのT (@dokkanoT0403) 2026年10月10日</blockquote>

<blockquote class="twitter-tweet" data-lang="ja"><p lang="ja" dir="ltr">「エンジニアに関係ないようなものも含めて」掛け算のキャリアを設計していくようにしようと思った。#技育祭 #ホールB で<br>フューチャーアーキテクトのセッション<br>「“優秀な誰か”の下位互換にならないために」<br>を聴きました！<br><br>あなたの人生は誰にも模倣できない。</p>&mdash; SaKana (@SaKana_kyd0) 2026年10月10日</blockquote>

<blockquote class="twitter-tweet" data-lang="ja"><p lang="ja" dir="ltr">多少仕事が遅くなっても、好奇心に駆動される&quot;技術の筋トレ&quot;的な部分は欠かさずやっていきたいな〜などと思った<br>あとコーヒーとか、そういう自分の個性・キャラ付けみたいなところも含め大切にしたい#技育祭 #ホールB</p>&mdash; ひるげ@個人開発 (@Hiru_ge) 2026年10月10日</blockquote>

<blockquote class="twitter-tweet" data-lang="ja"><p lang="ja" dir="ltr">自分だからできるっていう固有の経験を大学生のうちにもっと増やしていきたい<br>LTとか登壇側にも挑戦していきたいな〜<br><br>イベントに参戦しまくる行動力、CTOをやっている経験っていうのはValueになりそう！#技育祭 #ホールB pic.twitter.com/ehyZLz2FFD</p>&mdash; 安田一惺【いち】 (@yasusudas) 2026年10月10日</blockquote> 

<h2 id="当日お答えできなかった質問">当日お答えできなかった質問</h2><p>下記の表に当日Zoomでいただいた質問を回答していきます。質問はZoomでのコメント記載ママとなります。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 質問 / 回答"><table>
<thead>
<tr>
<th>質問</th>
<th>回答</th>
</tr>
</thead>
<tbody><tr>
<td>どうやって人と会う場を作ればいいですか</td>
<td>まずは勉強会など既存の場にでていくのがいいんじゃないでしょうか。<br>まさに技育プロジェクトとかの現地イベントいいと思います。</td>
</tr>
<tr>
<td>今学生時代に戻ったらどういうキャリアプランを立てますか</td>
<td>あまり、学生時代の在り方に後悔している部分はなく、ディベート漬けの毎日を再現するんじゃないかなと。<br>自分の興味に従って「これだけは続ける」という1本だけは決めていて手札どうしのつながりは、後から意味づければ十分なんじゃないかなと思います。</td>
</tr>
<tr>
<td>人とあまり関わりたくない性分なのですが<br>どう変えればいいですか？</td>
<td>無理に性格を変える必要はないと思います。変えるべきなのは「関わり方」のほうです。<br>大人数の雑談が苦手でも、コードや文章などの成果物を通じた関わりや、テーマが決まった少人数の場なら負担が少なくなります。<br>自分に合う関わり方を選び、その中で少しずつ接点を増やしていけば十分です。ネット上でのコミュニケーションでもいいですし。<br>もし積極的に懇親会などで話しかけられない、みたいな話であれば、登壇しちゃえばいいと思います。<br>あっちから登壇内容質問してくれますし、その内容は事前に登壇のために準備した内容なので答えやすいです。</td>
</tr>
<tr>
<td>模倣されにくい価値を作るためには、<br>異なる分野のスキルや資格を複数取得するというのは最適な選択ですか？</td>
<td>有効な手段の一つですが、「数を集めること」が目的になると、ひとつひとつが薄くなります。（自戒を込めて。資格って取ると楽しくなっちゃうので、他のも取ろうってなっちゃうんですよね）<br>まず軸になる1本を持ち、そこに別の分野を掛け合わせると、自分にしか出せない価値になります。<br>資格は、その掛け合わせを説明しやすくするラベルみたいなイメージです。</td>
</tr>
<tr>
<td>手札を増やそうにも、仕事につかえそうという考えで手札を増やしに行くと、<br>ありきたりなスキルしかつかない気がします。<br>使えると思っていないことが思わぬ形でつながる時があると思うので、<br>どういう意思決定をもっていろんなことに挑戦したのでしょうか？</td>
<td>まさにその通りで、「仕事に使えそうか」で選んだことは少ないです。基準は「面白そうか」「自分の心が動くか」でした。<br>つながりは、やっている最中ではなく後から見えてきて、後から意味づけしてきた、というのが実感です。</td>
</tr>
<tr>
<td>なにか1本を決めてやるのが大変そう<br>どう選ぶのがいいでしょうか？</td>
<td>最初から「正解の1本」を選ぶ必要はなく、今すでに続けていることや、苦にならずに続けられることから選べばと思います。<br>まず期間を決めてやり切ってみて、合わなければ変えて構わないと思います。</td>
</tr>
<tr>
<td>フューチャーは研究開発系のPJもあると聞きましたが、<br>その場合でもグランドデザインから経営まで行き来するのでしょうか？</td>
<td>研究開発のPJ経験がないので、他部門を外からみた観点でお答えします。<br>自分の観測範囲ですが社内の研究開発というと<br>①大学や研究機関との共同研究、<br>②将来の顧客へのプロダクト開発（既存プロジェクトのノウハウの集約や他業界へのスピンオフも含む）、<br>③社内外で利用する共通プロダクトやフレームワークやツール、OSSの開発<br>となります。<br>②、③は（想定の）ユーザー企業やユーザーの要件や業務を理解することはとても大切ですし、経営視点からも「課題」が解決できるものを作る必要があります。<br>①研究だと「経営」視点は少ないかもしれませんが、その研究の目指しているモノによっては経営的視点がはいることもあるんじゃないかと。</td>
</tr>
<tr>
<td>自分は突き抜けるタイプだと思っていますがどうやって行けばいいですか</td>
<td>こういうタイプと自覚している場合はすでにもう戦う軸が見えているはずです。それを徹底的に伸ばせばいいだけで、迷うことはないかと。<br>そのうえで、伸ばした成果を外に出しつづける（発表・OSS・ブログなど）と、「〇〇といえばこの人」と認識されるようになります。<br>ただ、厳しい言い方になりますが、本当に突き抜けられる人は、どうやって行けばいいか悩むことなくすでにその軸を磨き続けているんじゃないかなと。</td>
</tr>
<tr>
<td>どういうスキル、技術を持っていると長い目線で見ても、<br>AIと同じものさしで比較されにくいのでしょうか？</td>
<td>メインメッセージになりますが、あなたの人生は模倣できない、それはもちろんAIにも模倣されない。<br>単品ではAIと同じものさしで負けるものでも、複数の経験をつなぎ編集することでAIとは比較されない価値が作れます。<br>具体的なことはその人自身や環境などで大きく変わるものだと思います。</td>
</tr>
</tbody></table></div>
<h2 id="おわりに">おわりに</h2><p>今回のセッションは、（失敗談などの恥もさらしつつ、）自分のキャリアの歩み、人生の歩みを詰め込んだものになりました。多くの方にXやDay2の会場で「面白かった」と言っていただき光栄です。</p>
<p>本セッションがみなさんのキャリアにとって何かしらの指針になったのなら幸いです。</p>
<p>最後になりますが、Day1当日に参加してくださった皆様、Day2の出展ブースに足を運んでくださった皆様、毎回楽しい「祭」を運営している技育祭運営のサポーターズの皆様、ありがとうございました。</p>
]]></content>
    <summary type="html">技育祭2026秋 Day1 で「“優秀な誰か”の下位互換にならないために ※ただし”誰か”にはAIを含む」というタイトルで登壇しました。単一の物差しで勝負すると下位互換になるという問題意識から、経験を掛け合わせて模倣されない価値を作る話をし、当日答えきれなかった質問にもこの記事で回答します。</summary>
    <category term="Culture" scheme="https://future-architect.github.io/categories/Culture/"/>
    <category term="キャリア" scheme="https://future-architect.github.io/tags/%E3%82%AD%E3%83%A3%E3%83%AA%E3%82%A2/"/>
    <category term="技育祭" scheme="https://future-architect.github.io/tags/%E6%8A%80%E8%82%B2%E7%A5%AD/"/>
    <category term="登壇レポート" scheme="https://future-architect.github.io/tags/%E7%99%BB%E5%A3%87%E3%83%AC%E3%83%9D%E3%83%BC%E3%83%88/"/>
  </entry>
  <entry>
    <title>AWS Certified AI Business Strategist 合格体験記 - 公式問題とGemini Notebookでベータ試験に合格</title>
    <link href="https://future-architect.github.io/articles/20261013a/"/>
    <id>https://future-architect.github.io/articles/20261013a/</id>
    <published>2026-10-12T15:00:00.000Z</published>
    <updated>2026-10-12T15:00:00.000Z</updated>
    <author><name>棚井龍之介</name></author>
    <content type="html"><![CDATA[<img fetchpriority="high" src="/images/2026/20261013a/aws-certified-ai-business-strategist.png" alt="" width="300" height="300">

<p>FutureVulsチームの棚井です。2026年10月3日（土）に、AWS Certified AI Business Strategist（AIB-C01）のベータ試験を日本語で受験し、合格しました。</p>
<p>私は2026年8月31日にAWS認定の全冠を達成しました。その経緯は、前回の記事にまとめています。ところが、その翌日の9月1日に、AWS Certified AI Business Strategistが発表されました。9月29日から日本語でもベータ試験を受けられるようになったので、早速受験しました。</p>
<p>この記事では、試験の概要と、約4時間で行った準備、受験した感想を紹介します。</p>
<h2 id="試験の概要">試験の概要</h2><p>AWS Certified AI Business Strategistは、AIへの投資の評価、ビジネスケースの構築、ガバナンスの設計、組織全体への導入拡大といった判断を扱う認定です。カテゴリーは「Business」で、事業部門のリーダーやコンサルタント、プロダクトマネージャーなどが対象に挙げられています。</p>
<p>ベータ試験の概要は、次のとおりです（2026年10月4日時点）。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 項目 / 内容"><table>
<thead>
<tr>
<th>項目</th>
<th>内容</th>
</tr>
</thead>
<tbody><tr>
<td>試験コード</td>
<td>AIB-C01</td>
</tr>
<tr>
<td>ベータ試験の受験可能期間</td>
<td>2026年9月29日から。終了日は公式情報で確認できず</td>
</tr>
<tr>
<td>対応言語</td>
<td>英語・日本語</td>
</tr>
<tr>
<td>試験時間</td>
<td>170分</td>
</tr>
<tr>
<td>問題数</td>
<td>85問</td>
</tr>
<tr>
<td>出題形式</td>
<td>択一選択問題・複数選択問題</td>
</tr>
</tbody></table></div>
<p>提供開始日はAWSの発表、試験時間や問題数は公式ページのベータ試験の概要に基づいています。これから受験する方は、受験時点の条件を確認してください。</p>
<h2 id="勉強に使った教材と時間">勉強に使った教材と時間</h2><p>勉強時間は前日に約3時間、当日に約1時間で、合計約4時間でした。全冠取得までに学んだ知識を前提に、今回の対策に追加で使った時間です。</p>
<p>利用したのは、AWS Skill Builderの練習問題と、AWSの公式資料です。</p>
<h3 id="Skill-Builderの公式練習問題20問">Skill Builderの公式練習問題20問</h3><p>Official Practice Question Set: AWS Certified AI Business Strategist（AIB-C01・日本語）の20問を解きました。</p>
<p>生成AIを使った事業推進の経験がある方でも、この20問は解いておくことをおすすめします。知識を確認し、問題で提示される状況や求められる判断に慣れておくためです。</p>
<h3 id="公式資料とGemini-Notebook">公式資料とGemini Notebook</h3><p>次の4つの資料をPDFで取得し、Gemini Notebook（旧NotebookLM）に読み込ませました。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 資料 / 主に扱う内容"><table>
<thead>
<tr>
<th>資料</th>
<th>主に扱う内容</th>
</tr>
</thead>
<tbody><tr>
<td>AWS Certified AI Business Strategist 試験ガイド</td>
<td>出題範囲と求められる知識・スキル</td>
</tr>
<tr>
<td>AWS CAF-AI</td>
<td>AI導入を進めるための組織の能力や戦略</td>
</tr>
<tr>
<td>Responsible AI Lens</td>
<td>AIの便益とリスクを踏まえた設計・運用の考え方</td>
</tr>
<tr>
<td>生成AIを採用するための成熟度モデル</td>
<td>組織の成熟度に応じて生成AIの導入を進める考え方</td>
</tr>
</tbody></table></div>
<p>まず、Studioの「マインドマップ」と「レポート」で要約を読み、「フラッシュカード」で知識を確認しました。</p>
<img src="/images/2026/20261013a/studio.png" alt="" width="1200" height="447" loading="lazy">

<p>こうして概要をつかんでから、元の公式サイトを読み始めました。最初から公式資料を読み進めるよりも、この順序で学ぶ方が知識が定着しやすいと感じています。</p>
<h2 id="受験した感想">受験した感想</h2><p>実際に受験してみると、これまでのAWS認定とは問われる知識に違いを感じました。一方で、問題を解く感覚には覚えのある部分もありました。</p>
<h3 id="①-ビジネスでの活用を考え続ける試験">① ビジネスでの活用を考え続ける試験</h3><p>私が受験した範囲では、Amazon BedrockやAmazon SageMakerの個別の知識はほとんど必要ありませんでした。「機械学習」「深層学習」「生成AI」といった基礎的な概念の理解が中心です。</p>
<p>そのうえで、「ビジネスとして生成AIをどのように活用していくか」という視点が繰り返し問われる印象でした。生成AIを使った事業を推進した経験があれば、普段の仕事で行っている判断と重なる部分が多いと思います。</p>
<p>AWS全冠ホルダーでなくても、こうした事業推進の経験がある方なら、まとまった試験勉強をしなくても合格を狙えそうだと感じました。</p>
<h3 id="②-85問の現代文を解き続ける感覚">② 85問の現代文を解き続ける感覚</h3><p>ベータ試験は85問あります。文章に書かれた条件や目的を読み取り、選択肢を比較して妥当な判断を選ぶ問題が続きます。ひたすら現代文の問題を解き続けているような感覚になりました。</p>
<p>この感覚は、AWS Certified Advanced Networking - Specialtyを受験したときにも近いと感じました。問題数も多く、最後まで文章を読み続ける集中力が必要でした。</p>
<h3 id="③-すぐに仕事に役立つと感じた理由">③ すぐに仕事に役立つと感じた理由</h3><p>これまでに取得したAWS認定の中で、今回の試験がもっともすぐに仕事に役立つかもしれないと感じています。</p>
<p>生成AIをビジネスで活用する仕事は、しばらく続くと思います。その中で必要になるROI（投資収益率）の考え方や導入の進め方、他の部署や業務への横展開のノウハウは、そうすぐに陳腐化するものではないと思います。今回学んだ内容を、日々の仕事での判断に生かせると感じました。</p>
<h2 id="認定バッジとアーリーアドプターバッジ">認定バッジとアーリーアドプターバッジ</h2><p>今回は通常の認定バッジに加え、アーリーアドプターバッジも取得できました。</p>
<img src="/images/2026/20261013a/aws-certified-ai-business-strategist-early-adopter.png" alt="" width="300" height="300" loading="lazy">

<p>公式の案内では、2027年2月15日までにこの認定を取得すると、アーリーアドプターバッジも授与されるとされています。早い時期に受験すると、バッジが2つもらえるのもちょっとした楽しみです。</p>
<h2 id="おわりに">おわりに</h2><p>生成AIを使った事業推進に携わっている方なら、これまでの経験や判断の仕方を整理する機会として、受けてみてもよいと思います。</p>
]]></content>
    <summary type="html">AWS Certified AI Business Strategist（AIB-C01）のベータ試験に日本語で合格しました。試験の概要と、公式練習問題とGemini Notebookを使った約4時間の準備、受験した感想を紹介します。</summary>
    <category term="Cloud" scheme="https://future-architect.github.io/categories/Cloud/"/>
    <category term="AWS" scheme="https://future-architect.github.io/tags/AWS/"/>
    <category term="合格記" scheme="https://future-architect.github.io/tags/%E5%90%88%E6%A0%BC%E8%A8%98/"/>
    <category term="生成AI" scheme="https://future-architect.github.io/tags/%E7%94%9F%E6%88%90AI/"/>
  </entry>
  <entry>
    <title>bpmn.io で始める AI-Ready な業務フロー管理</title>
    <link href="https://future-architect.github.io/articles/20261009a/"/>
    <id>https://future-architect.github.io/articles/20261009a/</id>
    <published>2026-10-08T15:00:00.000Z</published>
    <updated>2026-10-08T15:00:00.000Z</updated>
    <author><name>武田大輝</name></author>
    <content type="html"><![CDATA[<h2 id="はじめに">はじめに</h2><p>みなさんは業務フローを書いたことはあるでしょうか。</p>
<p>業務フローは、ある業務を誰がどの順番で進めるかを図にしたものです。申請者が申請を登録し、承認者が承認し、購買担当が発注する、といった手順を担当者ごとのレーンに分け、矢印でつなぎます。システムの開発現場ではグランドデザインや要件定義などの工程で作られることが多い成果物です。</p>
<p>書く目的は、業務の手順を関係者の間でそろえることです。業務を担当する人とシステムを作る人とでは、同じ業務名から思い浮かべる手順が違います。業務フローとして描き出すと、どこで人が判断し、どこからシステムが処理するのかという境目について、双方の認識のずれが明らかになります。システム化の範囲を決める作業も機能を洗い出す作業も、この業務フローをインプットとして実施できます。</p>
<p>業務フローは、従来は Excel や PowerPoint をはじめとするオフィス系のツール、最近では draw.io の図として作られるのをよく目にします。しかし、生成 AI に業務フローを扱わせることを考えると、これらの形式がベストとはいえません。これらのファイルに保存されているのは図形の座標やスタイルの情報であり、その図形が業務フローとしてどういう意味を持つのか（たとえば、人の作業なのかシステムの処理なのか）は直接的には含まれていません。生成 AI に扱わせるには、凡例に相当する情報を別途コンテキストとして与えたり、座標やスタイルから推測させたりする必要があり、そのぶんトークンを消費します。生成 AI に読み書きさせるなら、要素の型や要素間の参照といった情報がスキーマに沿って記述され、座標やスタイルの情報によらず直接判断できる形式が望ましいと考えます。</p>
<p>この記事では、AI-Ready な業務フローの記述形式として BPMN 2.0 を採用し、bpmn.io エコシステムを利用して管理する方法を紹介します。取り上げるのはあくまで業務フローの管理の手段であり、業務フローはどうあるべきか、業務をどう改善するかといった部分は含みません。</p>
<h2 id="業務フローの記法に何を使うか">業務フローの記法に何を使うか</h2><p>業務フローは、これまで組織やプロジェクトごとに独自の形式で書かれることが一般的でした。角丸の四角は人の作業、四角はシステムの処理というように、図形に独自の凡例を定めて記述する形です。</p>
<p>しかしながら、こうした独自の記法を定めなくても、業務プロセスの記法には標準化されたものがあります。BPMN（Business Process Model and Notation）は OMG（Object Management Group）が策定した業務プロセスの記法で、現行版の 2.0.2 は2014年1月に採択され、ISO&#x2F;IEC 19510 として国際標準にもなっています。仕様は OMG の公式ページ で公開されています。</p>
<p>BPMN が定めているのは、図形だけではありません。仕様書は、業務フローを書くための各種要素の意味を定めたうえで、それをファイルに書くときの形式まで XML Schema で定めています。公式ページでは、仕様書の PDF と一緒に次の4つのスキーマファイル（.xsd）が配布されています。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 スキーマ / 接頭辞 / 定めるもの / 例"><table>
<thead>
<tr>
<th>スキーマ</th>
<th>接頭辞</th>
<th>定めるもの</th>
<th>例</th>
</tr>
</thead>
<tbody><tr>
<td>BPMN20.xsd</td>
<td>bpmn</td>
<td>プロセスの意味：タスク、イベント、ゲートウェイ、レーンなどの要素と、要素間のつながり</td>
<td><code>&lt;bpmn:sequenceFlow id=&quot;Flow_2&quot; sourceRef=&quot;Task_Register&quot; targetRef=&quot;Event_RequestSent&quot; /&gt;</code></td>
</tr>
<tr>
<td>BPMNDI.xsd</td>
<td>bpmndi</td>
<td>図の配置：BPMN20.xsd の各要素を、図のどこにどの図形や線として描くか</td>
<td><code>&lt;bpmndi:BPMNShape id=&quot;Task_Register_di&quot; bpmnElement=&quot;Task_Register&quot;&gt;</code></td>
</tr>
<tr>
<td>DC.xsd</td>
<td>dc</td>
<td>描画の基本型（Diagram Common）：矩形の位置と大きさ、点、フォントなど</td>
<td><code>&lt;dc:Bounds x=&quot;160&quot; y=&quot;20&quot; width=&quot;100&quot; height=&quot;80&quot; /&gt;</code></td>
</tr>
<tr>
<td>DI.xsd</td>
<td>di</td>
<td>図の基本構造（Diagram Interchange）：図形や線の抽象的な型と、線の折れ点</td>
<td><code>&lt;di:waypoint x=&quot;108&quot; y=&quot;60&quot; /&gt;</code></td>
</tr>
</tbody></table></div>
<p>BPMN 2.0 形式のファイル（.bpmn）では、この4つのスキーマに対応する名前空間を宣言します。</p>
<div class="code-block"><figure class="highlight xml"><input type="checkbox" id="code-wrap-1e6t7xq-1" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-1e6t7xq-1" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="tag">&lt;<span class="name">bpmn:definitions</span></span></span><br><span class="line"><span class="tag">  <span class="attr">xmlns:bpmn</span>=<span class="string">&quot;http://www.omg.org/spec/BPMN/20100524/MODEL&quot;</span></span></span><br><span class="line"><span class="tag">  <span class="attr">xmlns:bpmndi</span>=<span class="string">&quot;http://www.omg.org/spec/BPMN/20100524/DI&quot;</span></span></span><br><span class="line"><span class="tag">  <span class="attr">xmlns:dc</span>=<span class="string">&quot;http://www.omg.org/spec/DD/20100524/DC&quot;</span></span></span><br><span class="line"><span class="tag">  <span class="attr">xmlns:di</span>=<span class="string">&quot;http://www.omg.org/spec/DD/20100524/DI&quot;</span></span></span><br><span class="line"><span class="tag">  <span class="attr">id</span>=<span class="string">&quot;Definitions_1&quot;</span>&gt;</span></span><br></pre></td></tr></table></figure></div>

<p>このように仕様が細かく定められているため、BPMN に準拠したツールの間には互換性があり、エディタ、静的解析、画像変換といったツールのエコシステムも形成されています。</p>
<h2 id="BPMN-エディタは何を使うか">BPMN エディタは何を使うか</h2><p>BPMN に準拠した業務フローを描くためのエディタとしては draw.io と bpmn.io が代表的です。</p>
<p>draw.io には BPMN の図形ライブラリがあり、BPMN の記法で図をすぐに描けます。ただし、保存されるファイルは draw.io 独自の mxGraphModel 形式の XML で、図形の座標とスタイルが書かれているだけです。ユーザタスクとサービスタスクの区別や、メッセージを送るイベントと受けるイベントの区別といった BPMN としての意味情報は、スタイル文字列の中にしかありません。BPMN 2.0 形式でのエクスポート要望は GitHub Issue に上がっていますが、対応予定なしとしてクローズされています。</p>
<p>bpmn.io は Camunda が開発しているオープンソースの BPMN ツール群です。中心となる bpmn-js は、BPMN の図をブラウザで表示・編集するための JavaScript ライブラリで、保存されるファイルは BPMN 2.0 仕様に準拠した XML です。bpmn-js を組み込んだ VS Code 拡張も公式に用意されていて、.bpmn ファイルを VS Code 内で開いて GUI で編集できます。同じ組織が bpmnlint（静的解析）と bpmn-to-image（画像変換）も公開しています。</p>
<p>2つを比べると、次のようになります。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 観点 / draw.io / bpmn.io"><table>
<thead>
<tr>
<th>観点</th>
<th>draw.io</th>
<th>bpmn.io</th>
</tr>
</thead>
<tbody><tr>
<td>保存形式</td>
<td>独自形式（mxGraphModel）</td>
<td>BPMN 2.0 XML</td>
</tr>
<tr>
<td>VS Code 拡張</td>
<td>あり</td>
<td>あり</td>
</tr>
<tr>
<td>BPMN の意味情報</td>
<td>スタイル文字列に埋め込まれる</td>
<td>要素の型として保持される</td>
</tr>
<tr>
<td>静的解析</td>
<td>不可</td>
<td>可能（bpmnlint）</td>
</tr>
<tr>
<td>画像出力</td>
<td>可能</td>
<td>可能（bpmn-to-image）</td>
</tr>
<tr>
<td>エディタとしての使用感</td>
<td>描きやすい</td>
<td>draw.io にはやや劣る</td>
</tr>
<tr>
<td>生成 AI との親和性</td>
<td>意味を図形の配置から推測させる</td>
<td>意味を要素名からそのまま読める</td>
</tr>
</tbody></table></div>
<p>実際に両方を使用してみると、ページ設定やグリッドなどをはじめ作図エディタとしての使いやすさは draw.io のほうが上だと感じましたが、次の点で bpmn.io のメリットが大きいと判断しています。</p>
<ul>
<li><p><strong>BPMN 2.0 仕様準拠</strong><br>保存されるファイルが BPMN 2.0 の XML そのものであり、仕様に違反する操作の一部はエディタが受け付けません。たとえば、同じプールの中の要素どうしは、メッセージフローではつなげません。draw.io は汎用の作図ツールであり、BPMN として無効な図でも描けてしまいます。</p>
</li>
<li><p><strong>静的解析可能</strong><br>.bpmn ファイルは bpmnlint で検査でき、開始イベントの欠落やつながっていない要素を編集時やレビュー時に検出できます。CI への組込みも容易です。</p>
</li>
<li><p><strong>生成 AI フレンドリ</strong><br>業務の意味が <code>bpmn:userTask</code> や <code>bpmn:sequenceFlow</code> といった仕様上の要素名で書かれているので、生成 AI は図形の配置から推測しなくても、XML から業務フローの構造を読み取れます。誤りを指摘させるだけでなく、修正案を XML の差分として出力させることもできます。</p>
</li>
</ul>
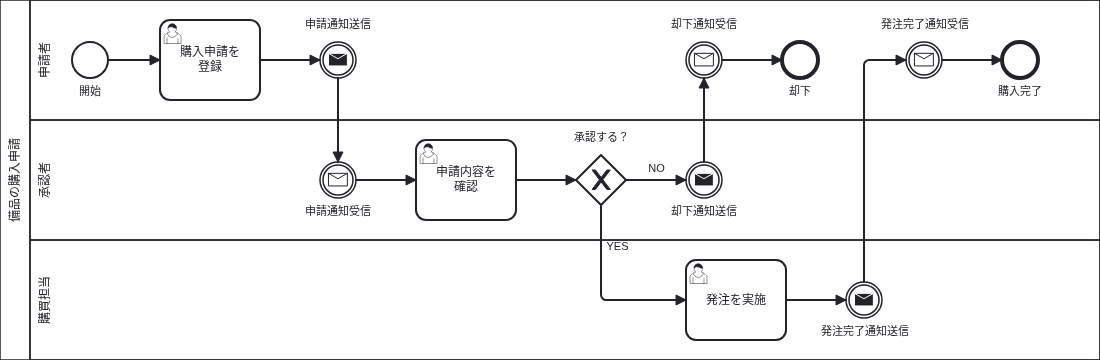
<h2 id="bpmn-ファイルの中身">.bpmn ファイルの中身</h2><p>bpmn.io で描いた業務フローは、次のような XML になります。この記事のサンプルとして用意した、備品の購入申請のフローから一部を抜き出して見てみましょう。</p>
<img fetchpriority="high" src="/images/2026/20261009a/purchase_request.png" alt="" width="1100" height="360">

<div class="code-block"><figure class="highlight xml"><input type="checkbox" id="code-wrap-1e6t7xq-2" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-1e6t7xq-2" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="tag">&lt;<span class="name">bpmn:userTask</span> <span class="attr">id</span>=<span class="string">&quot;Task_Register&quot;</span> <span class="attr">name</span>=<span class="string">&quot;購入申請を<span class="symbol">&amp;#10;</span>登録&quot;</span>&gt;</span></span><br><span class="line">  <span class="tag">&lt;<span class="name">bpmn:incoming</span>&gt;</span>Flow_1<span class="tag">&lt;/<span class="name">bpmn:incoming</span>&gt;</span></span><br><span class="line">  <span class="tag">&lt;<span class="name">bpmn:outgoing</span>&gt;</span>Flow_2<span class="tag">&lt;/<span class="name">bpmn:outgoing</span>&gt;</span></span><br><span class="line"><span class="tag">&lt;/<span class="name">bpmn:userTask</span>&gt;</span></span><br><span class="line"><span class="tag">&lt;<span class="name">bpmn:intermediateThrowEvent</span> <span class="attr">id</span>=<span class="string">&quot;Event_RequestSent&quot;</span> <span class="attr">name</span>=<span class="string">&quot;申請通知送信&quot;</span>&gt;</span></span><br><span class="line">  <span class="tag">&lt;<span class="name">bpmn:incoming</span>&gt;</span>Flow_2<span class="tag">&lt;/<span class="name">bpmn:incoming</span>&gt;</span></span><br><span class="line">  <span class="tag">&lt;<span class="name">bpmn:outgoing</span>&gt;</span>Flow_3<span class="tag">&lt;/<span class="name">bpmn:outgoing</span>&gt;</span></span><br><span class="line">  <span class="tag">&lt;<span class="name">bpmn:messageEventDefinition</span> <span class="attr">id</span>=<span class="string">&quot;MessageEventDefinition_1&quot;</span> /&gt;</span></span><br><span class="line"><span class="tag">&lt;/<span class="name">bpmn:intermediateThrowEvent</span>&gt;</span></span><br><span class="line"><span class="tag">&lt;<span class="name">bpmn:intermediateCatchEvent</span> <span class="attr">id</span>=<span class="string">&quot;Event_RequestReceived&quot;</span> <span class="attr">name</span>=<span class="string">&quot;申請通知受信&quot;</span>&gt;</span></span><br><span class="line">  <span class="tag">&lt;<span class="name">bpmn:incoming</span>&gt;</span>Flow_3<span class="tag">&lt;/<span class="name">bpmn:incoming</span>&gt;</span></span><br><span class="line">  <span class="tag">&lt;<span class="name">bpmn:outgoing</span>&gt;</span>Flow_4<span class="tag">&lt;/<span class="name">bpmn:outgoing</span>&gt;</span></span><br><span class="line">  <span class="tag">&lt;<span class="name">bpmn:messageEventDefinition</span> <span class="attr">id</span>=<span class="string">&quot;MessageEventDefinition_2&quot;</span> /&gt;</span></span><br><span class="line"><span class="tag">&lt;/<span class="name">bpmn:intermediateCatchEvent</span>&gt;</span></span><br></pre></td></tr></table></figure></div>

<p>要素名を読むと、「購入申請を登録」がユーザタスク（人がシステムを操作して行う作業）で、「申請通知送信」はメッセージを送る側の中間イベント、「申請通知受信」は受ける側だと分かります。</p>
<p>図としての見え方は、同じファイルの後半に BPMN DI（Diagram Interchange）として書かれます。</p>
<div class="code-block"><figure class="highlight xml"><input type="checkbox" id="code-wrap-1e6t7xq-3" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-1e6t7xq-3" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="tag">&lt;<span class="name">bpmndi:BPMNShape</span> <span class="attr">id</span>=<span class="string">&quot;Task_Register_di&quot;</span> <span class="attr">bpmnElement</span>=<span class="string">&quot;Task_Register&quot;</span>&gt;</span></span><br><span class="line">  <span class="tag">&lt;<span class="name">dc:Bounds</span> <span class="attr">x</span>=<span class="string">&quot;160&quot;</span> <span class="attr">y</span>=<span class="string">&quot;20&quot;</span> <span class="attr">width</span>=<span class="string">&quot;100&quot;</span> <span class="attr">height</span>=<span class="string">&quot;80&quot;</span> /&gt;</span></span><br><span class="line"><span class="tag">&lt;/<span class="name">bpmndi:BPMNShape</span>&gt;</span></span><br></pre></td></tr></table></figure></div>

<p>意味と座標が別の要素に分かれ、それぞれ仕様に定められた形で書かれているので、bpmnlint と生成 AI はどちらも座標を読み飛ばして意味の部分だけを扱えます。</p>
<h2 id="ガイドラインとして定めるべきこと">ガイドラインとして定めるべきこと</h2><p>記法やツールを決めても、業務フローとして何を書くか（たとえば、どの粒度でタスクを切るか、レーンに何を並べるか）が決まるわけではありません。最低限、業務フローを書く前に定めておくべきポイントを3つ取り上げます。</p>
<h3 id="記法のレベル">記法のレベル</h3><p>1つめは、どの種類の記号まで使うかという記法のレベルです。BPMN 2.0 仕様は、使える要素に応じて Descriptive（記述）、Analytic（分析）、Common Executable（実行可能）の3つの適合サブクラスを定めています。業務担当者との合意に使うのか、例外まで含めて分析するのか、ワークフローエンジンで実行するのかといった目的に応じて、どのサブクラスの範囲で描くかを選びます。</p>
<h3 id="タスクの粒度">タスクの粒度</h3><p>2つめは、1つのタスクで業務のどの大きさを表すかというタスクの粒度です。粒度のフレームワークとしては、企業情報化協会（BPM-J）が公開している 機能階層（FL: Function Layer） を利用できます。具体的には、次のような階層が目安とともに定義されており、目的に応じてどの階層の粒度で業務フローを作成するかを決めます。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 階層 / 名称 / 具体的目安 / 目安&#x2F;例"><table>
<thead>
<tr>
<th align="left">階層</th>
<th align="left">名称</th>
<th align="left">具体的目安</th>
<th align="left">目安&#x2F;例</th>
</tr>
</thead>
<tbody><tr>
<td align="left">FL0</td>
<td align="left">事業単位</td>
<td align="left">事業単位または全社管理</td>
<td align="left">-</td>
</tr>
<tr>
<td align="left">FL1</td>
<td align="left">事業機能</td>
<td align="left">事業の基本機能</td>
<td align="left">商品開発や営業などバリューチェーン機能区分が粒度の目安</td>
</tr>
<tr>
<td align="left">FL2</td>
<td align="left">詳細事業機能</td>
<td align="left">事業機能の構成要素</td>
<td align="left">商品やサービスの開発区分、チャネル区分、営業方式、サービスメニューなどが粒度の目安</td>
</tr>
<tr>
<td align="left">FL3</td>
<td align="left">業務機能</td>
<td align="left">詳細事業機能の実行単位</td>
<td align="left">オーダーサイクル（受付、計画、実行、報告）、管理、企画の区分などカウンタブルな（数えられる）仕事が粒度の目安</td>
</tr>
<tr>
<td align="left">FL4</td>
<td align="left">詳細業務機能</td>
<td align="left">詳細事業機能の構成要素</td>
<td align="left">業務機能のマイルストーン、中間成果物確定単位、組織間のハンドオフが粒度の目安</td>
</tr>
<tr>
<td align="left">FL5</td>
<td align="left">単位作業</td>
<td align="left">担当レベルの役割単位</td>
<td align="left">担当レベルの役割単位でのハンドオフが粒度の目安（タスクリストに表示される一件）</td>
</tr>
<tr>
<td align="left">FL6</td>
<td align="left">要素作業</td>
<td align="left">単位作業の作業ステップ</td>
<td align="left">「何を使って何をする」をツール・メディアに着目して区分した連続する操作・動作の塊が粒度の目安（作業分析の時間計測単位）</td>
</tr>
<tr>
<td align="left">FL7</td>
<td align="left">単位操作</td>
<td align="left">要素作業を分解した機能の区分</td>
<td align="left">ファイルを開く、選ぶ、コピー&amp;ペーストするなど</td>
</tr>
<tr>
<td align="left">FL8</td>
<td align="left">要素操作</td>
<td align="left">単位操作を行う人や RPA の動きを特定するための最も詳細な操作・動作</td>
<td align="left">クリックする、マウスをドラッグする、○秒待つなど</td>
</tr>
</tbody></table></div>
<p>システム化を前提に詳細化する場合は、1つの業務フローを FL4-5、FL5-6 の粒度で描くことが多くなります。</p>
<h3 id="記述ルール">記述ルール</h3><p>3つめは記述ルールそのものです。まず使えるのは BPMN 仕様の規定で、「開始イベントは流入シーケンスフローを持てない（§10.5.2）」というようなものが挙げられます。</p>
<p>ただし、仕様が定めるのは BPMN として正しいかどうかであり、読みやすい図にするためのルールは定めていません。そこを補うのが Bruce Silver の「BPMN Method and Style」（M&amp;S）のスタイルルールです。M&amp;S は、図だけを見て業務の流れが読み取れる BPMN を描くためのメソッドで、「アクティビティ名は目的語と動詞で書く」「ゲートウェイのラベルは問いの形にする」といったルールをまとめています。なお、M&amp;S は書籍として出版されているものであり、オープンに公開されてはいない点に注意が必要です。</p>
<p>仕様と M&amp;S で足りない部分は、独自に定めておくのが望ましいでしょう。たとえば bpmn.io にはページ設定がないので、複数のフローの見た目と出力サイズをそろえるには、次のようにレイアウトを数値で決めておくことになります。</p>
<ul>
<li>プールは起点 (0, 0)、横幅1820で描く</li>
<li>レーン1本の高さは120とする</li>
<li>タスク間の水平間隔は60とする</li>
<li>主フローは左から右へ流し、分岐と合流は上下に展開する</li>
</ul>
<p>ルールごとに出典（仕様、M&amp;S、独自）を明記しておくと、レビューで根拠を示しやすくなります。</p>
<h2 id="bpmnlint-による静的解析">bpmnlint による静的解析</h2><p>bpmnlint は、.bpmn ファイルを検査するコマンドラインツールです。ESLint と同じ作法で、設定ファイル <code>.bpmnlintrc</code> に <code>extends</code> でルールセットを継承し、<code>rules</code> で個別に上書きします。</p>
<figure class="highlight json"><table><tr><td class="code"><pre><span class="line"><span class="punctuation">&#123;</span></span><br><span class="line">  <span class="attr">&quot;extends&quot;</span><span class="punctuation">:</span> <span class="string">&quot;bpmnlint:recommended&quot;</span></span><br><span class="line"><span class="punctuation">&#125;</span></span><br></pre></td></tr></table></figure>

<p><code>bpmnlint:recommended</code> には25のルールが入っています。開始イベントと終了イベントがあるか、すべての要素にラベルがあるか、どこにもつながっていない要素がないか、排他ゲートウェイから出る複数のフローに条件が付いているか、といった検査です。</p>
<p>購入申請フローを規約違反のある状態にして実行してみます。「発注を実施」タスクの名前を入れ忘れ、その先の「発注完了通知送信」につなぐ矢印も引いていない状態で bpmnlint を実行すると次のような出力が得られます。</p>
<div class="code-block"><figure class="highlight console"><input type="checkbox" id="code-wrap-1e6t7xq-4" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-1e6t7xq-4" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="meta prompt_">$ </span><span class="language-bash">npx bpmnlint docs/purchase_request_draft/purchase_request_draft.bpmn</span></span><br><span class="line"></span><br><span class="line">./docs/purchase_request_draft/purchase_request_draft.bpmn</span><br><span class="line">  Task_Order         error  Element is missing label/name  label-required</span><br><span class="line">  Task_Order         error  Element is an implicit end     no-implicit-end</span><br><span class="line">  Event_OrderedSent  error  Element is an implicit start   no-implicit-start</span><br><span class="line"></span><br><span class="line">✖ 3 problems (3 errors, 0 warnings)</span><br></pre></td></tr></table></figure></div>

<p>図を見れば分かる誤りですが、こうした記法や構造の誤りを人がレビューで1つずつ確認するのは時間の無駄です。機械的に検出できるものは lint に任せ、レビュアーは業務フローが実際の業務を正しく表しているかという本質的な部分に集中できます。</p>
<p>業務フローの CI というのはあまり耳馴染みがないかもしれませんが、bpmnlint はコマンドラインで動くので、GitHub Actions などの CI に組み込んで Pull Request ごとに検査することも簡単に実現できます。</p>
<h2 id="静的解析では検出できないもの">静的解析では検出できないもの</h2><p>bpmnlint が見ているのは構造です。要素がつながっているか、ラベルがあるか、ゲートウェイの使い方が作法どおりか。フローが業務として正しいかは判定できません。</p>
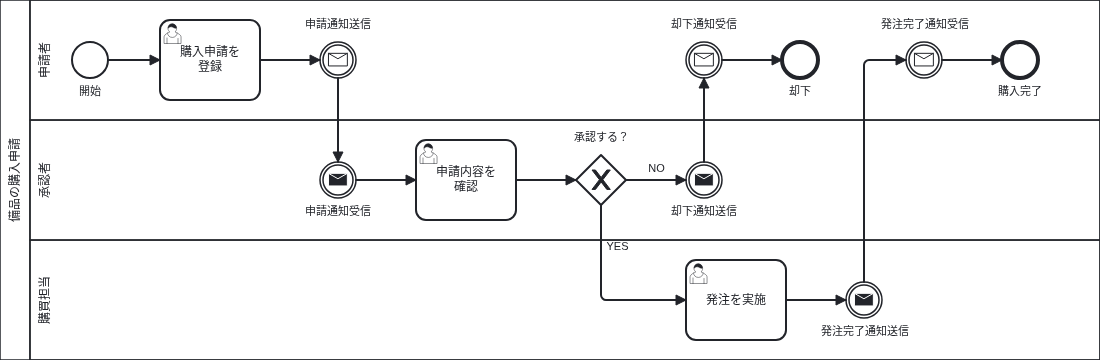
<p>購入申請フローで、申請通知の送信側と受信側を逆にしてみます。申請者のレーンの「申請通知送信」を受信（キャッチ）イベントに、承認者のレーンの「申請通知受信」を送信（スロー）イベントに変えた版です。図では、手紙のアイコンが塗りつぶしか白抜きかの違いしかありません。</p>
<img src="/images/2026/20261009a/purchase_request_swapped.png" alt="" width="1100" height="360" loading="lazy">

<div class="code-block"><figure class="highlight console"><input type="checkbox" id="code-wrap-1e6t7xq-5" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-1e6t7xq-5" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="meta prompt_">$ </span><span class="language-bash">npx bpmnlint docs/purchase_request_swapped/purchase_request_swapped.bpmn</span></span><br><span class="line">（出力なし、終了コード 0）</span><br></pre></td></tr></table></figure></div>

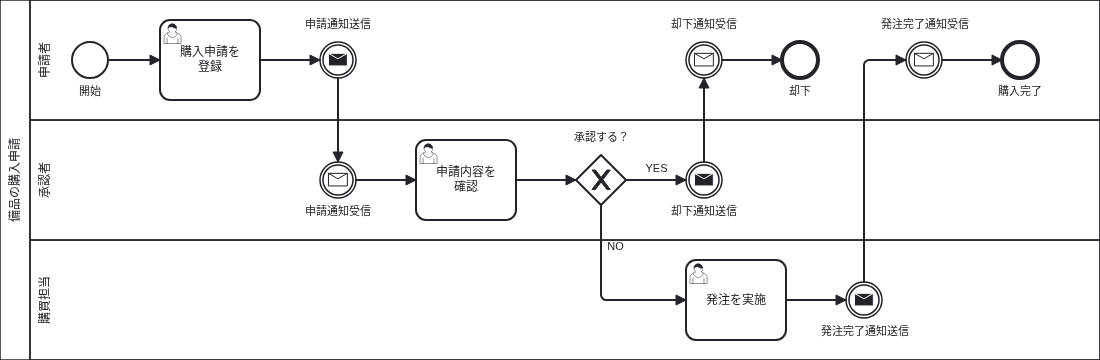
<p>矢印はすべてつながり、ラベルも開始と終了もあるので、構造としては正しく、bpmnlint は何もエラーを出力しません。この誤りはカスタムルールを書けば検出できますが、カスタムルールだけでは検出できない誤りもあります。たとえば承認の可否で分岐するゲートウェイから出る YES と NO を入れ違えてしまったケースです。</p>
<img src="/images/2026/20261009a/purchase_request_inverted.png" alt="" width="1100" height="360" loading="lazy">

<div class="code-block"><figure class="highlight console"><input type="checkbox" id="code-wrap-1e6t7xq-6" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-1e6t7xq-6" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="meta prompt_">$ </span><span class="language-bash">npx bpmnlint docs/purchase_request_inverted/purchase_request_inverted.bpmn</span></span><br><span class="line">（出力なし、終了コード 0）</span><br></pre></td></tr></table></figure></div>

<p>承認すると却下通知が送られ、却下すると発注されるという逆のフローですが、当然これも bpmnlint で検出できません。YES の先に何があるべきかは、「承認」と「却下通知」「発注」という語の関係を理解しないと判断できません。</p>
<h2 id="生成-AI-によるレビュー">生成 AI によるレビュー</h2><p>ガイドラインとして定めた内容は、そのまま Claude Code の rules などにできます。先ほどの記法のレベル、タスクの粒度、記述ルールの3つを反映した次のルールを <code>.claude/rules/bpmn.md</code> に置いておくと、生成 AI は業務フローを扱うたびにこの規約を読み込みます。</p>
<div class="code-block"><figure class="highlight markdown"><input type="checkbox" id="code-wrap-1e6t7xq-7" class="code-wrap-input" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-1e6t7xq-7" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line">---</span><br><span class="line">paths:</span><br><span class="line"><span class="bullet">  -</span> &quot;docs/<span class="strong">**/<span class="emphasis">*.bpmn&quot;</span></span></span><br><span class="line"><span class="emphasis"><span class="strong">  - &quot;docs/*</span><span class="emphasis">*/*</span>.md&quot;</span></span><br><span class="line"><span class="strong">---</span></span><br><span class="line"><span class="strong"></span></span><br><span class="line"><span class="strong"># 業務フロー記述規約</span></span><br><span class="line"><span class="strong"></span></span><br><span class="line"><span class="strong">（中略）</span></span><br><span class="line"><span class="strong"></span></span><br><span class="line"><span class="strong">## 記法のレベル</span></span><br><span class="line"><span class="strong"></span></span><br><span class="line"><span class="strong">- 使用する要素は Analytic 適合サブクラスの範囲に限る（BPMN §2.2.2）</span></span><br><span class="line"><span class="strong"></span></span><br><span class="line"><span class="strong">## タスクの粒度</span></span><br><span class="line"><span class="strong"></span></span><br><span class="line"><span class="strong">- 業務フローは業務（FL4）ごとに1つの BPMN プロセスで表す（FL）</span></span><br><span class="line"><span class="strong">- アクティビティは要素作業（FL6）を目安とする（FL）</span></span><br><span class="line"><span class="strong">- 画面遷移、入力チェックなどのシステム上の条件分岐、クリックなどの操作レベルの動作は描かない（独自）</span></span><br><span class="line"><span class="strong"></span></span><br><span class="line"><span class="strong">## 記述ルール</span></span><br><span class="line"><span class="strong"></span></span><br><span class="line"><span class="strong">### イベント</span></span><br><span class="line"><span class="strong"></span></span><br><span class="line"><span class="strong">- メッセージを送る側は送信（スロー）イベント、受け取る側は受信（キャッチ）イベントで描く（BPMN §10.5.4）</span></span><br><span class="line"><span class="strong">- メッセージイベントのラベルは「〜送信」「〜受信」とし、ラベルと要素の型を一致させる（独自）</span></span><br><span class="line"><span class="strong"></span></span><br><span class="line"><span class="strong">### ゲートウェイ</span></span><br><span class="line"><span class="strong"></span></span><br><span class="line"><span class="strong">- 質問ラベルを使う場合は、流出するシーケンスフローを YES と NO の2つにそろえる（M&amp;S）</span></span><br><span class="line"><span class="strong">- YES と NO の行き先は、業務として答えの意味と整合させる（独自）</span></span><br><span class="line"><span class="strong"></span></span><br><span class="line"><span class="strong">（後略）</span></span><br></pre></td></tr></table></figure></div>

<p>ガイドラインと同じく項目ごとに出典を添えておくと、生成 AI が指摘するときに、仕様の条番号やスタイルルールといった根拠まで示せます。先ほど説明した2つの誤りも、このルールの「ラベルと要素の型を一致させる」「YES と NO の行き先は、業務として答えの意味と整合させる」に照らせば指摘できます。</p>
<p>このサンプルとは別ですが、実際に書いた業務フローのリポジトリにも同じようなルールを置き、.bpmn ファイルを Claude Code にレビューさせたところ、次のような点が指摘されました。</p>
<ul>
<li>メッセージイベントの送受信が逆になっている</li>
<li>同じ担当者を指すレーン名の表記が、業務フローによって揺れている</li>
<li>要素のない空のレーンが存在する</li>
</ul>
<p>どれも bpmnlint では検出できなかった点です。</p>
<h2 id="画像変換">画像変換</h2><p>.bpmn ファイルは bpmn.io の拡張がないと図として見えません。レビュアーやビジネスサイドの人にそれを求められないケースもあるため、画像にして Markdown から参照する形でドキュメント化するなどのアプローチが考えられます。</p>
<p>画像化には bpmn-to-image を利用できます。内部的には Puppeteer でヘッドレスの Chromium を起動し、bpmn-js でレンダリングした結果を SVG、PNG、PDF に書き出します。</p>
<div class="code-block"><figure class="highlight bash"><input type="checkbox" id="code-wrap-1e6t7xq-8" class="code-wrap-input" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-1e6t7xq-8" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line">npx bpmn-to-image --no-footer --min-dimensions=1123x794 /path/to/file.bpmn:/path/to/file.svg</span><br></pre></td></tr></table></figure></div>

<p><code>--no-footer</code> は bpmn.io のロゴとタイトルを消すオプション、<code>--min-dimensions=1123x794</code> は最小サイズを指定するオプションです<sup id="fnref:1">1</sup>。VS Code をエディタとして利用している場合は VS Code のタスクとして変換作業を登録し、.bpmn ファイルを描き終えたらタスクを実行して SVG をコミットするような運用が考えられます。</p>
<h2 id="運用してみて">運用してみて</h2><p>ガイドラインと bpmnlint で単純な指摘は少なくなり、人によるレビューでは業務の中身が中心になりました。そもそも TO-BE の業務フローとしてどういう姿があるべきか、といった議論です。こうした判断は、BPMN の仕様を読んでも出てきません。</p>
<p>副次的な効果として、後続工程の成果物との整合性の確認にも使えました。DFD（データフロー図）を作成した段階で、業務フローと DFD を生成 AI に照合させたところ、業務フロー上のデータの受け渡しと DFD との食い違いが指摘されました。業務フローが BPMN の要素として構造化されていると、別の成果物との対応関係を生成 AI が追いやすくなります。</p>
<h2 id="おわりに">おわりに</h2><p>BPMN という記法そのものは以前から知っていたものの、BPMN 2.0 の XML で業務フローを管理したのは今回が初めてでした。導入してみると、人によるレビューで指摘する内容が記法の誤りから業務の中身へ移り、DFD との照合のように後続工程でも使える場面が見つかりました。</p>
<p>この記事で動かしたサンプルは GitHub で公開しています。</p>
<div id="footnotes"><hr><div id="footnotelist"><ol style="list-style:none; padding-inline-start: 0;"><li id="fn:1"><span style="vertical-align: top; padding-inline-end: 10px;">1.</span><span style="vertical-align: top;"><code>--min-dimensions</code> は PNG と PDF にだけ適用されます。SVG は bpmn-js が図の要素を囲む範囲で書き出すので、この指定は反映されません。</span> ↩</li></ol></div></div>]]></content>
    <summary type="html">業務フローの記述形式に BPMN 2.0 を採用し、bpmn.io のエディタ・bpmnlint による静的解析・生成 AI によるレビュー・bpmn-to-image での画像化で管理する方法を紹介します。</summary>
    <category term="AIDD" scheme="https://future-architect.github.io/categories/AIDD/"/>
    <category term="BPMN" scheme="https://future-architect.github.io/tags/BPMN/"/>
    <category term="生成AI" scheme="https://future-architect.github.io/tags/%E7%94%9F%E6%88%90AI/"/>
    <category term="静的解析" scheme="https://future-architect.github.io/tags/%E9%9D%99%E7%9A%84%E8%A7%A3%E6%9E%90/"/>
  </entry>
  <entry>
    <title>「ソフトウェアエンジニアリングの基礎」から見る読書マップ</title>
    <link href="https://future-architect.github.io/articles/20261008a/"/>
    <id>https://future-architect.github.io/articles/20261008a/</id>
    <published>2026-10-07T15:00:00.000Z</published>
    <updated>2026-10-07T15:00:00.000Z</updated>
    <author><name>武田大輝</name></author>
    <content type="html"><![CDATA[<p><img fetchpriority="high" src="/images/2026/20261008a/top.jpg" alt="ソフトウェアエンジニアリングの基礎（オライリー・ジャパン）" width="274" height="350"></p>
<h2 id="はじめに">はじめに</h2><p>『ソフトウェアエンジニアリングの基礎 ―コーダーからエンジニアになるための実践ガイド』（村上列訳、オライリー・ジャパン、2026年9月）を読了しました。</p>
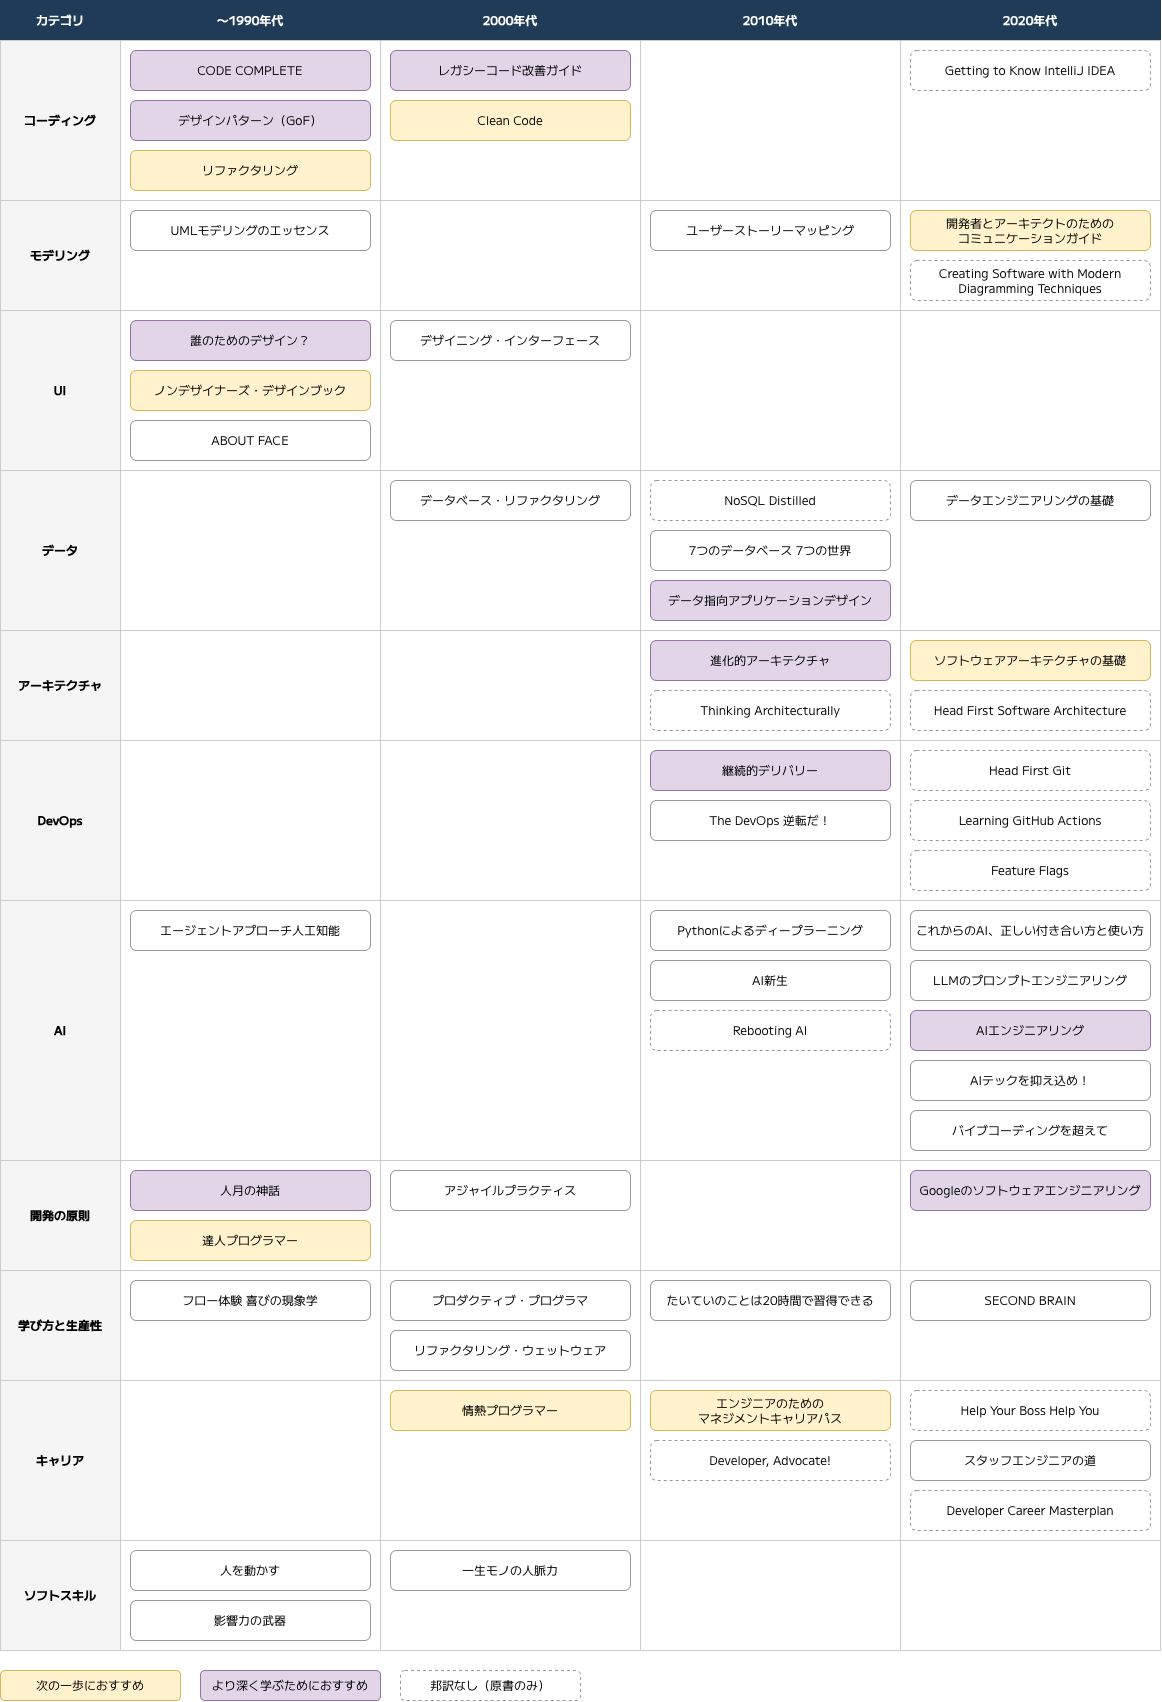
<p>ジュニアなエンジニアが成長するために知っておくべきことが非常によくまとまっており、共感する部分が多かったので、読んでみての感想を残しておきたいと思います。また、この書籍は各章の末尾で「関連リソース」として書籍をいくつか紹介しています。これだけよく整理された本なのでここから良質な読書マップが作れるのではないかと思い、整理してみました。</p>
<h2 id="書籍概要">書籍概要</h2><p>原書は O’Reilly Media の 『Fundamentals of Software Engineering: From Coder to Engineer』（2025年11月）で、著者は Nathaniel Schutta と Dan Vega の2人です。</p>
<p>序文によれば、想定読者は新人のソフトウェアエンジニアで、大学やブートキャンプで教わることと、現場で必要になることのギャップを埋める「オンボーディングガイド」として書かれています。私自身はエンジニアとしてのキャリアが約15年になりますが、まさに新人のころ（新人研修を終えて現場に出たばかりのころ）に読んでおきたかったなと思いながら読んでいました。</p>
<p>全体は4部構成の全15章です。第1部はコードを読む・書くといったコアスキル、第2部はモデリングやテストなどの技術的なプラクティス、第3部は UI、データ、アーキテクチャ、本番環境といった設計と開発、第4部は生産性、学び方、ソフトスキル、キャリア、AI というプロフェッショナルとしての能力開発と成長を扱います。</p>
<p>各章のページ数は次の通りです。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 章 / タイトル / ページ数"><table>
<thead>
<tr>
<th align="left">章</th>
<th align="left">タイトル</th>
<th align="left">ページ数</th>
</tr>
</thead>
<tbody><tr>
<td align="left">1章</td>
<td align="left">プログラマからエンジニアへ</td>
<td align="left">14</td>
</tr>
<tr>
<td align="left">2章</td>
<td align="left">コードを読む</td>
<td align="left">22</td>
</tr>
<tr>
<td align="left">3章</td>
<td align="left">コードを書く</td>
<td align="left">20</td>
</tr>
<tr>
<td align="left">4章</td>
<td align="left">モデル</td>
<td align="left">18</td>
</tr>
<tr>
<td align="left">5章</td>
<td align="left">自動テスト</td>
<td align="left">18</td>
</tr>
<tr>
<td align="left">6章</td>
<td align="left">初めて触れるシステムの調査と変更</td>
<td align="left">32</td>
</tr>
<tr>
<td align="left">7章</td>
<td align="left">ユーザーインターフェース設計</td>
<td align="left">30</td>
</tr>
<tr>
<td align="left">8章</td>
<td align="left">データの取り扱い</td>
<td align="left">48</td>
</tr>
<tr>
<td align="left">9章</td>
<td align="left">ソフトウェアアーキテクチャ</td>
<td align="left">20</td>
</tr>
<tr>
<td align="left">10章</td>
<td align="left">本番環境へ</td>
<td align="left">40</td>
</tr>
<tr>
<td align="left">11章</td>
<td align="left">生産性を向上させる</td>
<td align="left">14</td>
</tr>
<tr>
<td align="left">12章</td>
<td align="left">学び方を学ぶ</td>
<td align="left">18</td>
</tr>
<tr>
<td align="left">13章</td>
<td align="left">テクノロジー業界でソフトスキルを磨く</td>
<td align="left">20</td>
</tr>
<tr>
<td align="left">14章</td>
<td align="left">キャリアマネジメント</td>
<td align="left">38</td>
</tr>
<tr>
<td align="left">15章</td>
<td align="left">AI を駆使するソフトウェアエンジニア</td>
<td align="left">29</td>
</tr>
</tbody></table></div>
<p>ソフトウェアエンジニアリングという広いテーマを1冊にまとめるにあたって、何をどこまで書くかはかなり悩ましいと思います。そう考えると、ページ数が多い章ほど、著者が相対的に重要だと見ている章だと受け取ってよさそうです。中でも8章のデータと10章の本番環境は、ほかの章の2倍程度の分量があります。どちらもそれ単体で1冊の本が書けるトピックであり、重要な内容が多い領域なので納得です。</p>
<h2 id="読み終えた感想">読み終えた感想</h2><p>全体を通して良いなと思った点を紹介します。</p>
<ul>
<li><p>テーマの選び方とそれぞれに割く分量のバランスがすばらしい。<br>技術的なテーマのポイントの押さえ方（モデリング、テストピラミッド、トランザクション、キャッシュなど）もさることながら、ないがしろにされがちなソフトスキルまで丁寧に扱っている点が良い。ジュニアを育てる立場から読んでも、最低限押さえておいてほしいことのエッセンスが高い密度で詰まっている。</p>
</li>
<li><p>リアルな現場を前提として書かれている。<br>大学や新人研修で実施するようなゼロからの開発（グリーンフィールド開発）ではなく、既存のシステムに向き合うこと（ブラウンフィールド開発）を前提として書かれている。これに合わせて「コードを書く」より先に「コードを読む」の章を置いている点も良い。座学と現場のギャップがわかり、新人エンジニアの視野をぐっと広げてくれる一冊になっている。</p>
</li>
<li><p>なぜそれが必要なのかがわかる。<br>バージョン管理、自動テスト、CI&#x2F;CD など実際の現場では当たり前になっているプラクティスについて、なぜ必要なのかが明確に説明されている。私のように、なぜ必要かを教わらないまま、現場で言われるがままにいろいろなツールを入れさせられた人も少なくないはず。</p>
</li>
<li><p>あまり人から教わらないようなことを教えてくれる。<br>生産性の高め方（ショートカットを使う話とか）やナレッジの管理方法、コミュニケーションの取り方や学習方法といった細かい話ではあるが、かゆいところに手が届くようなトピックが盛り込まれている。新人のころにこれを知れたらどれだけ楽だっただろうかというネタが多い。</p>
</li>
</ul>
<h2 id="著者について">著者について</h2><p>読みながら共感するところが多かったので、著者の2人のキャリアについて調べてみました。</p>
<h3 id="Nathaniel-Schutta">Nathaniel Schutta</h3><p>ntschutta.io</p>
<p>Nathaniel Schutta は Thoughtworks のソフトウェアアーキテクトです。Ryan Asleson との共著 『Foundations of Ajax』（2005年）をはじめとし、Neal Ford と Matthew McCullough との共著 『Presentation Patterns』（2012年）があります。O’Reilly のレポートとしては 『Thinking Architecturally』（2018年）と 『Responsible Microservices』（2020年）を執筆しています。『Thinking Architecturally』は本書のさまざまな章で関連リソースとして挙げられています。2023年には Java Champion の称号を得ました。Java コミュニティへの貢献が認められた開発者に贈られるものです。講演の機会も多く、米国各地で開かれる開発者向けカンファレンス No Fluff Just Stuff の常連です。本業と並行して、ミネソタ大学の非常勤教授として「技術の変化を受け入れ、評価する姿勢」を学生に教えています。</p>
<h3 id="Dan-Vega">Dan Vega</h3><p>danvega.dev</p>
<p>Dan Vega は Broadcom の Spring Developer Advocate です。2000年に2年制の技術系カレッジを卒業しました。在学中から独学で Web アプリケーションを作り、仕事として請け負っていたそうです。卒業後はカリフォルニアのスタートアップ Five9 でテクニカルサポートとして働き、その後クリーブランドに戻って複数の企業で開発の仕事に就きました。途中、コーディングブートキャンプの Tech Elevator でカリキュラム開発を担当しています。2022年1月から VMware の Spring Developer Advocate を務め、Broadcom による買収後も同じ役割を続けています。2024年には Java Champion に選ばれました。YouTube チャンネル の登録者は2026年10月時点で約32万人、Udemy の受講者は約16万人で、週刊のニュースレターも発行しています。Spring Office Hours というポッドキャストでは共同ホストを務めています。</p>
<h3 id="2人の経歴をみて">2人の経歴をみて</h3><p>本書のコード例は Java が中心で、テストの例は JUnit と Mockito で書かれており、Spring Boot や Spring Data の話も何回か登場します。2人とも Java Champion だと知って、Java の例が多いことにも納得できました。</p>
<p>また、2人とも現役のエンジニアでありながら、人に教える立場にもいます。Schutta は大学で教え、Vega はブートキャンプでカリキュラムを作り、今は YouTube や講座で Spring を教えています。現場で手を動かし続けながら、人を育てる仕事にも長く関わってきたからこそ、若手にとって必要なことを解像度高く書けたのだと思います。</p>
<h2 id="関連する書籍">関連する書籍</h2><p>各章の「関連リソース」では、書籍のほかにブログ記事、講演、Web サイトなどが挙げられています。ここでは書籍だけをピックアップして一覧化してみます。</p>
<p>書籍は全部で55冊でした。なお、同じ本が複数の章で挙がることがあります。3つの章で挙がるのは『達人プログラマー』、『情熱プログラマー』、そして Schutta 自身の『Thinking Architecturally』の3冊でした。</p>
<h3 id="1章-プログラマからエンジニアへ">1章 プログラマからエンジニアへ</h3><ul>
<li><p>The Pragmatic Programmer（David Thomas、Andrew Hunt、20周年記念版 2019、初版 1999）<br>邦訳：達人プログラマー（オーム社、第2版 2020）<br>職業プログラマーの心構えと習慣を網羅した定番書（掲載章：1章・12章・14章）</p>
</li>
<li><p>The Mythical Man-Month（Fred Brooks、記念版 1995、初版 1975）<br>邦訳：人月の神話（丸善出版、新装版 2014）<br>人と月を交換できるとみなす『人月』の考え方を幻想だと指摘し、大規模開発の困難さを説いたソフトウェア開発の名著（掲載章：1章・3章）</p>
</li>
<li><p>Design Patterns（Erich Gamma ほか、1994）<br>邦訳：オブジェクト指向における再利用のためのデザインパターン（SBクリエイティブ、改訂版 1999）<br>オブジェクト指向設計で繰り返し現れる23の設計パターンを体系化したデザインパターンの原典、通称 GoF 本</p>
</li>
<li><p>Practices of an Agile Developer（Venkat Subramaniam、Andy Hunt、2006）<br>邦訳：アジャイルプラクティス（オーム社、2007）<br>アジャイルな開発者が日々実践したい45の習慣を悪い例と良い例の対比で紹介する実践書</p>
</li>
<li><p>The Productive Programmer（Neal Ford、2008）<br>邦訳：プロダクティブ・プログラマ（オライリー・ジャパン、2009）<br>コマンドライン、自動化、ショートカットなど、開発者個人の生産性を道具と習慣の両面から高める方法をまとめた本（掲載章：1章・11章）</p>
</li>
<li><p>Software Engineering at Google（Titus Winters ほか編、2020）<br>邦訳：Googleのソフトウェアエンジニアリング（オライリー・ジャパン、2021）<br>Google がソフトウェアを長期にわたって維持するための文化、プロセス、ツールを解説した、大規模開発の実践知</p>
</li>
<li><p>The Staff Engineer’s Path（Tanya Reilly、2022）<br>邦訳：スタッフエンジニアの道（オライリー・ジャパン、2024）<br>マネジメントに進まず技術職として上を目指すスタッフエンジニアの役割と、その仕事の進め方を解説したガイド</p>
</li>
<li><p>Code Complete（Steve McConnell、第2版 2004）<br>邦訳：CODE COMPLETE 上・下（日経BP、第2版 2005）<br>命名から設計、デバッグまで、コードを書く工程の実践を網羅したコーディングの古典的な教科書</p>
</li>
</ul>
<h3 id="4章-モデル">4章 モデル</h3><ul>
<li><p>User Story Mapping（Jeff Patton、2014）<br>邦訳：ユーザーストーリーマッピング（オライリー・ジャパン、2015）<br>ユーザの行動に沿ってストーリーを地図のように並べ、何をどの順で作るかを決める手法を、提唱者自身が解説した定番書</p>
</li>
<li><p>Communication Patterns（Jacqui Read、2023）<br>邦訳：開発者とアーキテクトのためのコミュニケーションガイド（オライリー・ジャパン、2025）<br>図、文書、会話で技術的な内容を伝えるためのパターンとアンチパターンをまとめた本（掲載章：4章・9章）</p>
</li>
<li><p>Creating Software with Modern Diagramming Techniques（Ashley Peacock、2023）<br>邦訳：なし<br>Mermaid などのツールで図をテキストとして書き、コードと一緒に管理する方法を解説した本（掲載章：4章・9章）</p>
</li>
<li><p>UML Distilled（Martin Fowler、第3版 2003）<br>邦訳：UMLモデリングのエッセンス（翔泳社、第3版 2005）<br>UML のうち実務でよく使う部分に絞って要点を解説した、薄くて読みやすい入門書（掲載章：4章・9章）</p>
</li>
</ul>
<h3 id="5章-自動テスト">5章 自動テスト</h3><ul>
<li>Clean Code（Robert C. Martin、2008）<br>邦訳：Clean Code（KADOKAWA、2017、初刊 2009）<br>命名、関数、コメント、テストなど、読みやすく保守しやすいコードを書くための規律をまとめた定番書</li>
</ul>
<h3 id="6章-初めて触れるシステムの調査と変更">6章 初めて触れるシステムの調査と変更</h3><ul>
<li><p>Refactoring（Martin Fowler、第2版 2018）<br>邦訳：リファクタリング（オーム社、第2版 2019）<br>振る舞いを変えずにコードの構造を改善する手法を手順付きのカタログとしてまとめたリファクタリングの原典</p>
</li>
<li><p>Working Effectively with Legacy Code（Michael Feathers、2004）<br>邦訳：レガシーコード改善ガイド（翔泳社、2009）<br>テストのない既存コードに安全に手を入れるため、依存を断ち切ってテストを追加する技法を解説した、レガシーコード対応の定番書</p>
</li>
<li><p>Getting to Know IntelliJ IDEA（Trisha Gee、Helen Scott、2022）<br>邦訳：なし<br>IntelliJ IDEA の機能と使いこなし方を、JetBrains のデベロッパーアドボケイト2人が体系的に解説した本</p>
</li>
</ul>
<h3 id="7章-ユーザーインターフェース設計">7章 ユーザーインターフェース設計</h3><ul>
<li><p>The Design of Everyday Things（Don Norman、増補改訂版 2013、初版 1988）<br>邦訳：誰のためのデザイン？（新曜社、増補・改訂版 2015）<br>使いやすいデザインとは何かを、アフォーダンスなど認知科学の観点から論じたデザインの古典</p>
</li>
<li><p>The Non-Designer’s Design Book（Robin Williams、第4版 2014）<br>邦訳：ノンデザイナーズ・デザインブック（マイナビ出版、第4版 2016）<br>近接、整列、反復、コントラストの4原則で、デザインの専門家でなくても見やすいレイアウトを作る方法を解説した定番の入門書</p>
</li>
<li><p>About Face（Alan Cooper ほか、第4版 2014）<br>邦訳：ABOUT FACE インタラクションデザインの本質（マイナビ出版、2024）<br>ユーザのゴールを起点にインタラクションを設計する、ゴール指向設計を体系化した大著</p>
</li>
<li><p>Designing Interfaces（Jenifer Tidwell ほか、第3版 2019）<br>邦訳：デザイニング・インターフェース（オライリー・ジャパン、第2版 2011）<br>ナビゲーションやフォームなど、UI 設計で繰り返し使われるパターンを集めたカタログ</p>
</li>
</ul>
<h3 id="8章-データの取り扱い">8章 データの取り扱い</h3><ul>
<li><p>Designing Data-Intensive Applications（Martin Kleppmann、Chris Riccomini、第2版 2026）<br>邦訳：データ指向アプリケーションデザイン（オライリー・ジャパン、初版 2019）。第2版 は2026年11月刊行予定<br>レプリケーション、パーティショニング、トランザクションなど、データを扱う分散システムの原理を解説した名著</p>
</li>
<li><p>Seven Databases in Seven Weeks（Luc Perkins ほか、第2版 2018）<br>邦訳：7つのデータベース 7つの世界（オーム社、初版 2013）<br>リレーショナル、key-value、ドキュメント、グラフなど7種のデータベースを、実際に動かしながら比較する本</p>
</li>
<li><p>Refactoring Databases（Scott Ambler、Pramod Sadalage、2006）<br>邦訳：データベース・リファクタリング（ピアソン・エデュケーション、2008）<br>稼働中のデータベースのスキーマを、移行期間を設けながら段階的に変更する手法をカタログ化した本</p>
</li>
<li><p>Fundamentals of Data Engineering（Joe Reis、Matt Housley、2022）<br>邦訳：データエンジニアリングの基礎（オライリー・ジャパン、2024）<br>データの生成から保存、変換、提供までのライフサイクル全体を見渡す、データエンジニアリングの入門書</p>
</li>
<li><p>NoSQL Distilled（Pramod Sadalage、Martin Fowler、2012）<br>邦訳：なし<br>key-value、ドキュメント、カラムファミリー、グラフといった NoSQL データベースの分類と使い分けを短くまとめた入門書</p>
</li>
</ul>
<h3 id="9章-ソフトウェアアーキテクチャ">9章 ソフトウェアアーキテクチャ</h3><ul>
<li><p>Thinking Architecturally（Nathaniel Schutta、2018）<br>邦訳：なし<br>本書の著者 Schutta による無料のレポート。次々に現れる新しい技術をどう評価し、どう取り入れるかを論じる（掲載章：9章・12章・13章）</p>
</li>
<li><p>Head First Software Architecture（Raju Gandhi、Mark Richards、Neal Ford、2024）<br>邦訳：なし<br>イラストやクイズを多用する Head First シリーズのソフトウェアアーキテクチャ入門書</p>
</li>
<li><p>Fundamentals of Software Architecture（Mark Richards、Neal Ford、2020）<br>邦訳：ソフトウェアアーキテクチャの基礎（オライリー・ジャパン、2022）。第2版の邦訳は 2026年3月<br>アーキテクチャ特性の洗い出し、トレードオフ分析、主要なアーキテクチャスタイルを体系的に解説した入門書</p>
</li>
<li><p>How to Win Friends and Influence People（Dale Carnegie、1936）<br>邦訳：人を動かす（創元社、改訂新装版 2023）<br>人に好かれ、人を動かすための原則をまとめた、対人関係の古典（掲載章：9章・13章）</p>
</li>
<li><p>Building Evolutionary Architectures（Neal Ford ほか、第2版 2022）<br>邦訳：進化的アーキテクチャ（オライリー・ジャパン、初版 2018）<br>適応度関数でアーキテクチャ特性を継続的に検証し、変化に耐えるアーキテクチャを作る方法を解説した本</p>
</li>
<li><p>Influence, New and Expanded（Robert Cialdini、2021）<br>邦訳：影響力の武器（誠信書房、新版 2023）<br>返報性や社会的証明など、人が説得に応じる心理的な原理を解説した、説得の心理学の古典（掲載章：9章・13章）</p>
</li>
</ul>
<h3 id="10章-本番環境へ">10章 本番環境へ</h3><ul>
<li><p>Continuous Delivery（Jez Humble、David Farley、2010）<br>邦訳：継続的デリバリー（KADOKAWA、2017、初刊 2012）<br>ビルド、テスト、デプロイを自動化するパイプラインを体系化した、継続的デリバリの原典</p>
</li>
<li><p>The Phoenix Project（Gene Kim ほか、2013）<br>邦訳：The DevOps 逆転だ！（日経BP、2014）<br>炎上中の IT 部門を舞台に、DevOps の考え方を小説仕立てで描いたベストセラー</p>
</li>
<li><p>Head First Git（Raju Gandhi、2022）<br>邦訳：なし<br>Git のしくみを図解とクイズで学ぶ、Head First シリーズの入門書</p>
</li>
<li><p>Learning GitHub Actions（Brent Laster、2023）<br>邦訳：なし<br>GitHub Actions でワークフローを組み、CI&#x2F;CD を自動化する方法を解説した入門書</p>
</li>
<li><p>Feature Flags（Ben Nadel、2024）<br>邦訳：なし<br>フィーチャーフラグの導入と運用に絞り、著者の実務経験をもとにまとめた自費出版の本</p>
</li>
</ul>
<h3 id="11章-生産性を向上させる">11章 生産性を向上させる</h3><ul>
<li><p>Flow（Mihaly Csikszentmihalyi、1990）<br>邦訳：フロー体験 喜びの現象学（世界思想社、1996）<br>時間を忘れて没頭する「フロー」状態を提唱した、心理学の古典</p>
</li>
<li><p>Building a Second Brain（Tiago Forte、2022）<br>邦訳：SECOND BRAIN（東洋経済新報社、2023）<br>デジタルのメモを整理して活用し、自分の外にもう1つの脳を作る、個人の知識管理の方法論</p>
</li>
<li><p>The Passionate Programmer（Chad Fowler、第2版 2009）<br>邦訳：情熱プログラマー（オーム社、2010）<br>開発者が自分のキャリアを主体的に築くための53の助言をまとめたエッセイ集（掲載章：11章・12章・14章）</p>
</li>
</ul>
<h3 id="12章-学び方を学ぶ">12章 学び方を学ぶ</h3><ul>
<li><p>The First 20 Hours（Josh Kaufman、2013）<br>邦訳：たいていのことは20時間で習得できる（日経BP、2014）<br>新しいスキルを最初の20時間で一定の水準まで身につけるための、練習の進め方を説いた本</p>
</li>
<li><p>Pragmatic Thinking and Learning（Andy Hunt、2008）<br>邦訳：リファクタリング・ウェットウェア（オライリー・ジャパン、2009）<br>脳のしくみや認知科学の知見をもとに、エンジニアの学習法と思考法を解説した本</p>
</li>
</ul>
<h3 id="14章-キャリアマネジメント">14章 キャリアマネジメント</h3><ul>
<li><p>Developer Career Masterplan（Heather VanCura、Bruno Souza、2023）<br>邦訳：なし<br>コミュニティへの参加や情報発信を軸に、開発者がキャリアを伸ばす方法を解説した本</p>
</li>
<li><p>The Manager’s Path（Camille Fournier、2017）<br>邦訳：エンジニアのためのマネジメントキャリアパス（オライリー・ジャパン、2018）<br>テックリードから CTO まで、エンジニアリングマネジメントの各段階で求められる役割を解説した定番書</p>
</li>
<li><p>Developer, Advocate!（Geertjan Wielenga、2019）<br>邦訳：なし<br>デベロッパーアドボケイトとして活躍する人たちへのインタビュー集</p>
</li>
<li><p>Help Your Boss Help You（Ken Kousen、2021）<br>邦訳：なし<br>上司との関係を自分から築き、うまく協力してもらうための方法を解説した本</p>
</li>
<li><p>Never Eat Alone（Keith Ferrazzi、Tahl Raz、2014、初版 2005）<br>邦訳（2005年版）：一生モノの人脈力（パンローリング、2012）<br>相手の役に立つことを起点に人脈を築く方法を説いた、人脈づくりの実用書</p>
</li>
</ul>
<h3 id="15章-AI-を駆使するソフトウェアエンジニア">15章 AI を駆使するソフトウェアエンジニア</h3><ul>
<li><p>AI Engineering（Chip Huyen、2024）<br>邦訳：AIエンジニアリング（オライリー・ジャパン、2025）<br>基盤モデルを使ったアプリケーションの開発、評価、運用を体系的に解説した本</p>
</li>
<li><p>Beyond Vibe Coding（Addy Osmani、2025）<br>邦訳：バイブコーディングを超えて（オライリー・ジャパン、2025）<br>AI を使ったコーディングの実践と、AI 時代のエンジニアの役割を論じた本</p>
</li>
<li><p>Prompt Engineering for LLMs（John Berryman、Albert Ziegler、2024）<br>邦訳：LLMのプロンプトエンジニアリング（オライリー・ジャパン、2025）<br>GitHub Copilot の開発に携わった著者による、LLM を組み込んだアプリケーションのプロンプト設計の解説書</p>
</li>
<li><p>Rebooting AI（Gary Marcus、Ernest Davis、2019）<br>邦訳：なし<br>深層学習だけでは信頼できる AI は作れないと論じ、常識や推論の必要性を説いた本</p>
</li>
<li><p>Co-Intelligence（Ethan Mollick、2024）<br>邦訳：これからのAI、正しい付き合い方と使い方（KADOKAWA、2024）<br>AI を「共同知能」として扱い、仕事や学びで協働するための4つの原則を示した本</p>
</li>
<li><p>Human Compatible（Stuart Russell、2019）<br>邦訳：AI新生（みすず書房、2021）<br>人間の価値観と両立する AI をどう設計し、制御するかを論じた本</p>
</li>
<li><p>Artificial Intelligence: A Modern Approach（Stuart Russell、Peter Norvig、第4版 2020）<br>邦訳：エージェントアプローチ人工知能（共立出版、原著第4版 2026）<br>探索、推論、機械学習まで AI 全体を網羅した、世界中の大学で使われる AI の教科書</p>
</li>
<li><p>Deep Learning with Python（François Chollet、第2版 2021）<br>邦訳：Pythonによるディープラーニング（マイナビ出版、2022）<br>Keras の作者自身による、Python で深層学習を実装しながら学ぶ入門書</p>
</li>
<li><p>Taming Silicon Valley（Gary Marcus、2024）<br>邦訳：AIテックを抑え込め！（日経BP、2025）<br>大手 AI 企業の問題点を指摘し、AI に必要な規制と市民の取り組みを論じた本</p>
</li>
</ul>
<h2 id="読書マップ">読書マップ</h2><p>55冊を一覧で見てもどこから手をつければよいかわかりづらいため、独自に再カテゴライズし、初版の年代別に分類してみました。そのうえで、独断と偏見により「次の一歩としてお勧めする書籍（黄色）」と「さらに深く学ぶためにお勧めする書籍（紫色）」を色付けしています。すべての書籍を読んでいるわけではないので、あくまで私が手に取ったり読んだりしたことがある書籍の中からよさそうと判断したものに対して色付けしている点はご了承ください。</p>
<img src="/images/2026/20261008a/reading_map.drawio.png" alt="" width="1162" height="1702" loading="lazy">

<p>全体を俯瞰してみると、1990年代以前の古い書籍も多く含まれています。ただ、その多くは、コーディングや開発の原則のような、技術の流行の影響を受けにくいカテゴリの本です。反対に、DevOps と AI の書籍はほとんどが2010年代以降で、変化の速い分野ほど新しい本が挙がっています。トレンドの書籍を読むことはもちろん重要ですが、それと同じくらい古典的名著に触れることも私としてはお勧めしたいです。</p>
<h2 id="おわりに">おわりに</h2><p>あらためて、『ソフトウェアエンジニアリングの基礎』は良書でした。現場に出たばかりの若手はもちろん、若手を育てる立場の人にもお勧めです。</p>
<p>読書マップに対するフィードバックもお待ちしています。次の1冊を選ぶ参考になれば幸いです。</p>
]]></content>
    <summary type="html">オライリー・ジャパンの『ソフトウェアエンジニアリングの基礎 ―コーダーからエンジニアになるための実践ガイド』を読んだ感想と、各章の「関連リソース」に挙がる書籍55冊を整理した読書マップを紹介します。</summary>
    <category term="Programming" scheme="https://future-architect.github.io/categories/Programming/"/>
    <category term="O'Reilly" scheme="https://future-architect.github.io/tags/O-Reilly/"/>
    <category term="ソフトウェアエンジニアリングの基礎" scheme="https://future-architect.github.io/tags/%E3%82%BD%E3%83%95%E3%83%88%E3%82%A6%E3%82%A7%E3%82%A2%E3%82%A8%E3%83%B3%E3%82%B8%E3%83%8B%E3%82%A2%E3%83%AA%E3%83%B3%E3%82%B0%E3%81%AE%E5%9F%BA%E7%A4%8E/"/>
    <category term="書評" scheme="https://future-architect.github.io/tags/%E6%9B%B8%E8%A9%95/"/>
  </entry>
  <entry>
    <title>フューチャー製 AIアクセラレータ「Mark-I」開発の紹介</title>
    <link href="https://future-architect.github.io/articles/20261007a/"/>
    <id>https://future-architect.github.io/articles/20261007a/</id>
    <published>2026-10-06T15:00:00.000Z</published>
    <updated>2026-10-06T15:00:00.000Z</updated>
    <author><name>宮下悠希</name></author>
    <content type="html"><![CDATA[<h2 id="はじめに">はじめに</h2><p>本記事では、なぜITコンサルを主軸とするフューチャーが独自のAIアクセラレータ開発に踏み出したのか、その背景と独自開発のハードウェア『Mark-I』の全貌についてご紹介します。</p>
<h2 id="なぜ、ITコンサルが「ハードウェアの自作」に挑むのか？">なぜ、ITコンサルが「ハードウェアの自作」に挑むのか？</h2><p>フューチャーの本業はITコンサルティングおよびシステムインテグレーション（SI）です。一般的なイメージであれば、「最先端のAIモデルをどうビジネスに適用するか」というソフトウェアやクラウドのレイヤーに終始するのが自然かもしれません。</p>
<p>しかし、私たちが「チップのアーキテクチャ設計」というハードウェアの領域にまで踏み込んだのには、実務上の課題に根ざした理由があります。</p>
<p>それは、<strong>「ソフトウェアだけの最適化では、間もなく限界が訪れる」</strong> という現実があるからです。今後、自動運転、ロボティクス、スマート工場といった物理世界（フィジカル空間）にAIが溶け込んでいく時代において、求められるのは「リアルタイムな処理」と「限られた電力での動作」です。</p>
<p>既存の汎用的なハードウェア（GPUなど）の上にソフトウェアを載せるだけでは、データ転送やOSのオーバーヘッドによる「遅延（レイテンシ）」を完全になくすことは困難です。私たちが目指すのは、フューチャーが培ってきた課題解決力に、<strong>「計算機そのものを自社でデザインし、低遅延を極限まで追求する力」</strong> を掛け合わせることです。</p>
<p>ビジネスの現場で真に必要とされる計算機を、ハードウェアの形から自作して届ける。このアプローチこそが、フューチャーが次世代のサービスやシステムを支えていくための重要なアプローチとなっています。</p>
<h2 id="なぜ、今「FPGAでAIアクセラレータ」なのか？">なぜ、今「FPGAでAIアクセラレータ」なのか？</h2><p>消費電力などのリソースが限られた環境において、いかに高速に推論するか。この難題を「ハードウェアから解決する」ために、私たちが選定したのが<strong>FPGA（Field Programmable Gate Array）</strong> です。</p>
<p>一般的なGPUは、あらかじめ用意された大量の小さな演算コア（回路）を使い、「ソフトウェアの命令」によって膨大なデータを並列に計算する構造です。同時に大量の演算ができる反面、命令コードを読み込まないと実行できないノイマンボトルネックと言われる遅延や電力消費を減らしにくい欠点を持ちます。一方で、FPGAは、回路の接続を直接プログラムすることで命令コードを使わずに計算を行える方式であるため、処理の遅延（レイテンシ）が極めて少なく、マイクロ秒単位の低レイテンシと低消費電力化を同時に実現できます。</p>
<p>必要な回路だけを作るため無駄がなく、CPU&#x2F;GPUのように複雑なOSやソフトウェアレイヤーを介さない「フルハードウェア制御」への落とし込みが可能です。そのため、処理の遅延（レイテンシ）を小さく抑えられるだけでなく、<strong>負荷による処理時間のばらつきが極めて少なく、「リアルタイム保証（デッドライン保証）」を満たすための予測可能性（確実性）が非常に高い</strong> という強みを持っています。</p>
<p>この「低遅延」と「優れたリアルタイム保証（デッドライン保証）のしやすさ」こそが、ミリ秒・マイクロ秒単位の応答が求められるエッジAI領域において、私たちがFPGAを採用する大きなメリットとなっています。</p>
<h2 id="自社開発AIアクセラレータ『Mark-I』の紹介">自社開発AIアクセラレータ『Mark-I』の紹介</h2><p>こうした思想のもと、フューチャーが独自にアーキテクチャ設計から手がけた初代AIアクセラレータが <strong>『Mark-I』</strong> です。</p>
<h3 id="Mark-I構成図">Mark-I構成図</h3><img fetchpriority="high" src="/images/2026/20261007a/Mark-I構成図.png" alt="" width="1200" height="752">

<h3 id="アーキテクチャと内部構成">アーキテクチャと内部構成</h3><p>『Mark-I』は、高負荷な積和演算の高速化と、データ転送のボトルネック解消を同時に実現するため、主に以下の3つのコンポーネントを軸に設計されています。</p>
<ol>
<li><strong>独自演算コア「SPU（Systolic Processing Unit）」</strong><br>ディープラーニングにおける膨大な行列乗算を効率化するため、<strong>16×16 の INT8 のシストリックアレイ</strong> を採用しています。データを一方向・格子状に効率よく流しながら積和演算を連続処理することで、メモリへのアクセス回数を劇的に減らしています。さらに、MaxPoolingやLeaky ReLUといった活性化関数回路もアレイの直後にハードウェアとして組み込んでおり、推論の一連のプロセスを止めることなくワンストップで高速処理します。</li>
<li><strong>高速データ転送ユニット「PINK（Parallel INterconnect Kernel）」</strong><br>どれだけ演算器が高速でも、外部メモリ（LPDDR4-SDRAM）とのデータ供給が追いつかなければ「待ち時間」が発生してしまいます。これを防ぐのが、独自に組み込んだ<strong>AXI4 512-bitのデータ転送ユニット「PINK」</strong> です。PINKは演算コアの裏側で完全に並列動作し、次の演算に必要なデータや重み情報をあらかじめローカルストアに先読みすることで、データ転送によるボトルネックを極限まで排除しています。</li>
<li><strong>内蔵「RISC-V コントローラ」とランタイムソフトウェア</strong><br>ハードウェア全体を統括し、柔軟な制御を担うのが<strong>内蔵されたRISC-Vコントローラ</strong>です。ハードウェア側から複雑な条件分岐や制御ロジックを排除し、少ないリソース（低消費電力）で高クロックでも安定して動作する回路設計を両立するため、本アーキテクチャでは<strong>内蔵のRISC-Vコントローラに制御の複雑性を担当させる設計</strong>を採用しています。モデル開発、量子化、チューニングなども独自に行っており、出来上がったAIモデルの演算フローをソフトウェア側で緻密にコントロールし、ハードウェアの演算リソースを最大限に引き出せるようにしています。</li>
</ol>
<h3 id="主要スペック（2026年2月時点仕様）">主要スペック（2026年2月時点仕様）</h3><p>※詳細については、フューチャー株式会社 プレスリリース（2026年2月27日発表） をあわせてご参照ください。なお、さらなる高速化・高性能化に向けて現在も開発を進めています。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 項目 / 仕様 / Item / Specification"><table>
<thead>
<tr>
<th align="left">項目</th>
<th align="left">仕様</th>
<th align="left">Item</th>
<th align="left">Specification</th>
</tr>
</thead>
<tbody><tr>
<td align="left">対応FPGA</td>
<td align="left">Efinix Ti375</td>
<td align="left">FPGA Platform</td>
<td align="left">Efinix Ti375</td>
</tr>
<tr>
<td align="left">演算性能</td>
<td align="left">1.36TOP&#x2F;s(INT8)</td>
<td align="left">Compute Performance</td>
<td align="left">1.36TOP&#x2F;s(INT8)</td>
</tr>
<tr>
<td align="left">コア周波数</td>
<td align="left">333MHz</td>
<td align="left">Core Frequency</td>
<td align="left">333MHz</td>
</tr>
<tr>
<td align="left">演算アーキテクチャ</td>
<td align="left">SPU 8×16×16 シストリックアレイ</td>
<td align="left">Compute Architecture</td>
<td align="left">SPU 8×16×16 systolic array units</td>
</tr>
<tr>
<td align="left">ローカルメモリ</td>
<td align="left">合計 18.8Mbit(各SPU：2.3Mbit)</td>
<td align="left">Local Store</td>
<td align="left">18.8Mbit total(2.3Mbit per SPU)</td>
</tr>
<tr>
<td align="left">データ転送</td>
<td align="left">PINK：AXI4 512-bit データ転送ユニット (演算と並列動作)</td>
<td align="left">Data Transfer Engine</td>
<td align="left">PINK：AXI4 512-bit data transfer unit (operating in parallel with computation)</td>
</tr>
<tr>
<td align="left">対応畳み込みサイズ</td>
<td align="left">1×1, 3×3</td>
<td align="left">Supported Conv Sizes</td>
<td align="left">1×1, 3×3</td>
</tr>
<tr>
<td align="left">プーリング</td>
<td align="left">なし、2×2 Max Pooling</td>
<td align="left">Pooling</td>
<td align="left">None, 2×2 Max Pooling</td>
</tr>
<tr>
<td align="left">活性化関数</td>
<td align="left">なし、ReLU、Leaky ReLU</td>
<td align="left">Activation Functions</td>
<td align="left">None, ReLU, Leaky ReLU</td>
</tr>
<tr>
<td align="left">処理単位</td>
<td align="left">入出力とも16チャネル単位で処理 (不足分はゼロ埋め)</td>
<td align="left">Processing Unit</td>
<td align="left">Processed in 16-channel blocks (zero-padded when not aligned)</td>
</tr>
</tbody></table></div>
<h3 id="実証デモによる動作比較">実証デモによる動作比較</h3><p>ここでは、実際にMark-Iを用いたリアルタイム顔認識のデモ動画を紹介します。</p>
<iframe width="560" height="315" src="https://www.youtube.com/embed/J8yytQ_VZJA" title="face detection demo cap" frameborder="0" allow="accelerometer; autoplay; clipboard-write; encrypted-media; gyroscope; picture-in-picture; web-share" referrerpolicy="strict-origin-when-cross-origin" allowfullscreen></iframe>

<p>画面左側の <strong>『CPU上でのソフトウェア実行』</strong> では、アクセラレータなどの専用ハードウェアを用いずに処理させているため、演算負荷の高さから動作が追いつかず、フレームレートが<strong>1 FPS</strong>にとどまっています。一方で、画面右側の <strong>『Mark-IによるFPGA実行』</strong> では、専用に設計されたハードウェア回路の特性を活かすことで、フレームレートが <strong>15 FPS</strong>へと向上（約<strong>15倍</strong>の処理効率）しています。</p>
<p>カメラが捉えた対象を遅延なく認識・追従し続ける様子から、特定の用途に向けて構成された専用回路による処理がエッジAI処理においてどのような効果をもたらすか、その挙動の違いが確認できます。</p>
<h3 id="リアルタイムジェスチャー認識（パンチゲーム）デモ">リアルタイムジェスチャー認識（パンチゲーム）デモ</h3><p>続いて、Mark-Iの応答性を応用した、リアルタイムでのジェスチャー認識によるゲーム形式のデモ動画を紹介します。</p>
<iframe width="560" height="315" src="https://www.youtube.com/embed/hqiidpnaNxA" title="フルーツストライカーデモ動画" frameborder="0" allow="accelerometer; autoplay; clipboard-write; encrypted-media; gyroscope; picture-in-picture; web-share" referrerpolicy="strict-origin-when-cross-origin" allowfullscreen></iframe>

<p>このデモでは、カメラを通じて入力される画像から「手のこぶし」をリアルタイムに検出し、特定のジェスチャー（パンチ動作）をトリガーにして得点が加算されるシステムを構築しています。</p>
<p>遅延の発生しやすい環境ではユーザーの素早い動きと画面上の判定にズレが生じてしまいますが、FPGAを用いた低遅延処理によって、繰り出されたパンチの瞬間を捉え、即座にゲームスコアへ反映させています。</p>
<h4 id="デモシステムの全体構成">デモシステムの全体構成</h4><figure><img src="/images/2026/20261007a/Mark-Iシステム構成.jpg" alt="" width="1920" height="1440" loading="lazy"><figcaption>▲Mark-Iを使用したリアルタイムジェスチャー認識（パンチゲーム）のデモ環境</figcaption></figure>
<p>本デモ環境は、グループ会社である <strong>ネイロ株式会社</strong> との連携によって構築されています。</p>
<ol>
<li><strong>カメラ入力</strong>：USBカメラがプレイヤーの手の動作をキャプチャします。</li>
<li><strong>Mark-I（FPGAボード）による推論処理</strong>：カメラ映像のフレームデータを「Ti375 C529 Development Kit」上の『Mark-I』へと入力し、事前に学習させた「手のこぶし（パンチ動作）」の物体検出・認識処理を実行します。</li>
<li><strong>ゲームアプリケーション（ネイロ社開発）</strong>：Mark-Iから出力されたリアルタイムの検出結果をPC側のゲームアプリへ高速フィードバックし、プレイヤーが繰り出すパンチの動きに合わせて画面上のターゲットへヒット判定を発生させます。</li>
</ol>
<p>一般的に、画像認識を用いたインタラクティブなゲームでは、推論遅延が数フレーム発生するだけでも「プレイヤーの入力と画面の反応がズレる」という違和感につながります。</p>
<p>しかし、本構成ではMark-Iの高速な処理能力によって、プレイヤーの素早いパンチ動作を滞りなく検出し、実用的なレスポンスでスコア化できるスムーズな処理を実現しています。</p>
<h2 id="未来への挑戦：研究機関としての知見を深める産学連携体制">未来への挑戦：研究機関としての知見を深める産学連携体制</h2><p>最先端の計算機科学を探求し、より深い知見を社内に蓄積・還元するため、私たちは大学との強力な産学連携体制を敷いています。フューチャーのメンバー自らが「客員研究員」や「受託研究員」として各大学の研究活動へ参画し、最先端技術の共同研究を強力に推進しています。現在、以下の3名の専門研究員を中心に、次世代アーキテクチャの種まきを進めています。</p>
<ul>
<li><strong>東京科学大学 受託研究員</strong><br>スピントロニクス技術とインメモリコンピューティング（IMC）を融合させた、次世代ハードウェアアーキテクチャ開発を推進しています。（2026年4月〜）</li>
<li><strong>千葉工業大学 客員研究員</strong><br>リアルタイムAIを支える次世代シーケンス処理コアの研究、およびSSM-FPGAによるリアルタイム音楽生成アクセラレータの開発を担っています。（2025年9月〜）</li>
<li><strong>千葉工業大学 客員研究員</strong><br>FPGAの上限に挑むための超高密度な回路実装や、演算リソースを限界まで引き出す超並列計算アーキテクチャの最適化を研究しています。（2025年9月〜）</li>
</ul>
<p>既存のシリコンアーキテクチャの枠を超え、学術界の知見と融合しながら自社メンバーが深く技術を探究することで、エッジAI領域におけるハードウェアの可能性を一歩先へと押し進めています。</p>
<h2 id="まとめ">まとめ</h2><p>私たちが手掛けているAIアクセラレータの開発は、単なるコア技術の実験にとどまりません。ここで蓄積された知見や成果は、将来的にフューチャーグループが提供する多様なITソリューションにおいて、エッジ領域での課題解決や新たな価値提案を支えるための技術的選択肢を広げることにつながっています。</p>
<p>ソフトウェアとハードウェアの両面からアプローチすることで、これまでアプローチが難しかった低遅延推論や効率化の可能性が見えてきます。フューチャーはこれからも、既存の枠組みにとらわれず、次世代のコンピューティング技術を先駆けて探究・実証し、社会やビジネスへ新たな可能性を還元できるよう、研究開発を進めていきます。</p>
]]></content>
    <summary type="html">ITコンサルを本業とするフューチャーが、FPGA を使った AI アクセラレータ『Mark-I』を独自開発した背景と、SPU・PINK・RISC-V コントローラからなるアーキテクチャ、主要スペック、リアルタイム顔認識とジェスチャー認識のデモ動画を紹介します。</summary>
    <category term="フィジカルAI" scheme="https://future-architect.github.io/categories/%E3%83%95%E3%82%A3%E3%82%B8%E3%82%AB%E3%83%ABAI/"/>
    <category term="FPGA" scheme="https://future-architect.github.io/tags/FPGA/"/>
    <category term="RISC-V" scheme="https://future-architect.github.io/tags/RISC-V/"/>
    <category term="エッジAI" scheme="https://future-architect.github.io/tags/%E3%82%A8%E3%83%83%E3%82%B8AI/"/>
  </entry>
  <entry>
    <title>非ITエンジニアの元医療従事者と事業企画推進が体感したAI駆動開発研修の全貌</title>
    <link href="https://future-architect.github.io/articles/20261006a/"/>
    <id>https://future-architect.github.io/articles/20261006a/</id>
    <published>2026-10-05T15:00:00.000Z</published>
    <updated>2026-10-05T15:00:00.000Z</updated>
    <author><name>野村恵一</name></author>
    <content type="html"><![CDATA[<img fetchpriority="high" src="/images/2026/20261006a/top.jpg" alt="" width="1200" height="630">

<h2 id="はじめに">はじめに</h2><p>こんにちは、Healthcare Innovation Group（以下、HIG）の野村・久保です。</p>
<p>私たちが所属するHIGは、ITとAIの知見を活用し、次世代型医療サービスの創出とヘルスケア領域全体の革新に挑む専門組織です。エンジニア集団と思われがちな私たちのチームには、臨床現場の空気感を知り尽くした医療のプロフェッショナルと、事業やプロダクトを力強く推進してきた人材が共存しています。</p>
<p>私たちがこの体制をとる理由はシンプルです。医療現場の課題は単なるIT化では解決できず、泥臭くリアルな現場の課題を正しく解釈して初めて意味のある社会実装が可能になります。この現場の解像度を爆速で価値に変える武器が、全社で推進するAI駆動開発です。フューチャーは2026年4月に発表した「AI社会実装 No.1カンパニーを目指す」AIステートメントのもと、生成AIを開発の共創パートナーとして活用しています。HIGでは現場の知見とAI駆動開発を組み合わせ、アイデアから社会実装までのスピードを極限まで縮めています。</p>
<p>本記事では、非ITエンジニアである元医療従事者（診療放射線技師）の野村と、元開発PMで事業企画推進（BizDev）の久保の2人が参加したHIGにおけるAI駆動開発研修の様子をお届けします。</p>
<p>本研修の大きな特徴は、与えられたお題をこなすのではなく、受講者が自らのドメイン知識を活かして開発テーマを設定する点にあります。今回、私たちが挑んだテーマは以下の通りです。</p>
<p><strong>【画像診断医療機器の保守管理をスマートに】</strong></p>
<p>病院では数多くの医療機器が稼働していますが、現場を支える裏方の保守管理業務は未だに紙ベースの記録や表計算ソフトでの運用が多く残っています。日々の点検記録の記入や過去データの管理による見えない負担を少しでも減らし、現場をスマートにしたいという想いから、点検記録を管理するアプリの開発をテーマに選びました。（野村）</p>
<p><strong>【臨床と経営を守るスマート・オペレコOS】</strong></p>
<p>24時間365日体制の救急医療を支える医師たちが、深夜の緊急対応後の疲弊した状態でバラバラな手術記録を作成している現状に強い問題意識を抱いていました。さらに、多忙や疲労による症状詳記<sup id="fnref:1">1</sup>の記載漏れは、高額なカテーテル等の診療報酬<sup id="fnref:2">2</sup>請求漏れに繋がり、病院経営上の損失リスクを生みます。この臨床と経営の双方の課題に対し、「医師の入力・作文負担を減らしつつ病院の正当な収益を守る」ための最速の市場検証手段として、スマート・オペレコOSの開発をテーマに選びました。（久保）</p>
<p>異色のチームがAIをどう武器にし、組織全体で医療DXの限界をどう突破しようとしているのか、そのリアルな最前線をご紹介します。</p>
<h2 id="AIを相棒に、3ヶ月で創り手へ。非エンジニアが駆け抜けたAI駆動開発研修の記録">AIを相棒に、3ヶ月で創り手へ。非エンジニアが駆け抜けたAI駆動開発研修の記録</h2><p>プログラミングができないと、理想のアプリは作れない。そんな先入観を抱えていた私たちですが、気づけば3ヶ月後には、自分たちの手でプロトタイプを動かし、メンターや開発経験のあるサポーターからフィードバックをもらう創り手になっていました。</p>
<p>医療現場と事業、それぞれの専門性を持つ私たちが、この研修を通じて壁にぶつかり、アジャイルにAIと駆け抜けた進化のステップをご紹介します。</p>
<h3 id="STEP-1-開発テーマ設定とMVP設計：AIのスピードとルールベースの堅牢性を掛け合わせる">STEP 1 開発テーマ設定とMVP設計：AIのスピードとルールベースの堅牢性を掛け合わせる</h3><p>最初のステップは、課題の具体化です。生成AIを壁打ち相手にし、画面レイアウトを相談しました。AIは即座にコードを出力してくれるため、私たちは最速でプロトタイプを手にすることができました。</p>
<p>一方で、医療現場で最も恐ろしいのはAIのハルシネーションです。診療報酬の請求漏れを防ぐアプリで架空の数値を捏造されては一大事です。そこで、AIに自由な文章生成をさせるのではなく、業界公認の標準マスターである、DX審査支払機構の特定器材マスターや一般財団法人医療情報システム開発センター（MEDIS）のICD10対応標準病名マスターなどをデータベースの軸とし、あえて厳密なルールベースで動作する堅牢な初期MVPを設計しました。AIの瞬発力を借りつつも、制御の綱は人間が握る。このコンセプトと要件設計が私たちのスタートラインでした。</p>
<h3 id="STEP-2-環境構築と実践：AIの伴走で踏み出したモノづくりへの第一歩">STEP 2 環境構築と実践：AIの伴走で踏み出したモノづくりへの第一歩</h3><p>開発環境をセットアップし、いざ本格的な開発へ。黒いターミナル画面にコードの列が並ぶ様子は、未経験の私たちにとってまさに未知との遭遇でした。しかし、AIアシスタントを頼りに手順を踏むと、ついに画面に「Hello World」<sup id="fnref:3">3</sup>が表示されました。</p>
<p>「AIに指示して生成されたコードで、プログラムが動いた！」</p>
<p>これは実感が湧かない、なんとも不思議な感覚でした。正直に言えば、最初は「動いたけれど、これの何がそんなに面白いのだろう？（ん……で？）」という感覚でもありました（笑）。</p>
<p>しかし、本当に面白いのはお作法そのものを学ぶことではなく、自分の手で自分が作りたいものを作る、そのプロセスそのものなのだと認識しました。AIが1行1行の意味を理解度に合わせて解説してくれるパーソナライズされた学習体験が、プログラミングへの心理的ハードルを一瞬で壊してくれました。</p>
<h3 id="STEP-3-プロトタイプから実用へ：エンジニアと現場目線で浮き彫りになった課題">STEP 3 プロトタイプから実用へ：エンジニアと現場目線で浮き彫りになった課題</h3><p>AIと構築したプロトタイプを携え、開発経験を持つエンジニアやサポーター（HIGには臨床現場で現在も活躍している医師がいます！）の前でデモを行いました。コンセプトには共感してもらえたものの、実際に触ってもらうとエンジニアや実ユーザー目線のフィードバックが返ってきました。</p>
<p>「データが保存されたか視覚的にわからないと不安」「例外症例の時はどうする？」など、私たちでは気づくことのできなかった数々の実用的な課題が浮き彫りになりました。しかし、これこそが開発設計の原点。私たちはこのフィードバックを宝の山として、次なるステップへ進みました。</p>
<h3 id="STEP-4-アプリ改修と研修の軌道修正：事務局と目線を合わせ、全エネルギーを機能改修へ注ぐ">STEP 4 アプリ改修と研修の軌道修正：事務局と目線を合わせ、全エネルギーを機能改修へ注ぐ</h3><p>ここが研修最大のハイライトでした。</p>
<p>私たちは、二重保存防止機能の実装やHuman-in-the-Loop<sup id="fnref:4">4</sup>の安全設計など、アプリの改修に着手しました。さらに、コードから仕様書を自動生成する挑戦も行いました。Schema Enforcement（スキーマ強制）<sup id="fnref:5">5</sup>という手法を利用し、中間データを介してコードと仕様書の完全連動を構築しました。</p>
<p>ドキュメント作成に関する基礎知識がなく、開発も未経験である私たちにとって、この自動化は完全にキャパシティを超えるものでした。「プロトタイプの段階で、人間が読むための綿密な設計書をどこまで作り込むべきか？」という疑問が生じ、事務局と受講者の間で研修スコープや目的の目線合わせを行いカリキュラムを修正しました。HIG初の取り組みであり、事務局と受講者が共に作り上げる研修でもありました。ドキュメント作成は一旦スコープから外し、まずは動くアプリで価値を検証することに特化するという迅速な軌道修正のおかげで、機能磨きに全エネルギーを集中させることができました。もちろん、開発においてドキュメントが重要であることに変わりはありません。今回の経験から得た受講者の習熟度に合わせたカリキュラム設計が重要という気づきを踏まえ、今後は研修をレベル分けし、上位コースでは仕様書の作成・自動生成までを扱うなど、カリキュラムの改良を進める方針となりました。研修の型すらアジャイルにリビルドしてくれる柔軟な環境こそ、HIGの強みだと感じました。</p>
<h3 id="STEP-5-プロセスを組織の知的資産へ：AIとの対話をチームの共有知に変える">STEP 5 プロセスを組織の知的資産へ：AIとの対話をチームの共有知に変える</h3><p>最終報告に向けて、私たちは開発したすべてのソースコードをGitLabにPushし、組織の知的資産として登録しました。AIのチャット履歴に埋もれさせず、プロセスを資産化しました。</p>
<h2 id="ここが学びのカギだった-〜AI駆動開発研修の設計が、私たちを創り手に変えた〜">ここが学びのカギだった 〜AI駆動開発研修の設計が、私たちを創り手に変えた〜</h2><p>3ヶ月を駆け抜けて振り返ると、私たちがここまで走り切れたのは、この研修そのものの設計にカギがありました。非エンジニアが最速で創り手になれた理由を、4つのポイントに整理します。</p>
<p>フューチャーには、新しい挑戦を歓迎し、その実行を強力に後押しするカルチャーが根付いています。自ら創り出す組織風土をさらに加速させる指針が、「はじめに」で触れたAIステートメントです。この共創パートナーという考え方をベースに、HIGではより実践的に学べるよう設計したAI駆動開発研修を運用しています。</p>
<h3 id="学びのカギ①-コンセプト：創る喜びを実践型で会得する">学びのカギ① コンセプト：創る喜びを実践型で会得する</h3><p>ITエンジニアに限らず、AIを活用してモノづくりの成功体験を積む。それが本研修のコンセプトです。</p>
<p>複雑なコードの書き方を習得することよりも、AIを共創パートナーとして、Vibe Codingを用いてまずは形にしてみること、そして実際に日々医療業界の課題に向き合うHIGメンバーからのフィードバックを得て、改善し続けるという開発サイクルを、自分自身の力で回せるようになることを目指しています。</p>
<p>だからこそ単なる登録画面ではなく、「これがあったら現場がもっと笑顔になるはず！」と思える、受講者それぞれのこだわりが詰まったオリジナル機能にこだわりました。</p>
<h3 id="学びのカギ②-運用：はじめての壁も、心強いサポーターと乗り越えられる">学びのカギ② 運用：はじめての壁も、心強いサポーターと乗り越えられる</h3><p>「自分にアプリなんて作れるのか？」――そんな不安は、非エンジニアの受講者なら誰もが最初に抱くものです。しかし、行き詰まってもメンターや開発経験者がすぐに手を差し伸べてくれ、教材もサンプルでなく医療現場の公開データなどの一次情報を扱います。「共に学び、高め合う」この運用が、心理的なハードルと実務感覚のギャップを同時に埋めてくれました。</p>
<h3 id="学びのカギ③-得られた価値：AIを使いこなすディレクターシップの体感">学びのカギ③ 得られた価値：AIを使いこなすディレクターシップの体感</h3><p>3ヶ月の研修を終えた今、私たちの手元に残っているのはVibe Codingで作成した成果物だけではありません。</p>
<p>AIの回答をそのまま受け取らず、自ら一次情報を確認してより良い方向へ導くHuman-in-the-Loopの姿勢。そして、指示の解像度を高めて理想のアウトプットを引き出すスキル。これらを通じて、次世代のビジネスや開発に欠かせないAIという優秀なパートナーを導くディレクターシップ<sup id="fnref:6">6</sup>を、確かな実感を伴って習得できました。</p>
<h3 id="学びのカギ④-HIGの未来：現場の想いを、自分たちの手で最速で形にする">学びのカギ④ HIGの未来：現場の想いを、自分たちの手で最速で形にする</h3><p>医療現場の課題は専門的で、外部に伝えるだけでも大変です。その痛みを誰よりも知る私たちが、AIという共創パートナーと一緒に「こんな機能があれば解決できる」をその場で形にできれば、重厚なシステム開発や大規模投資の前に、プロトタイプで価値を検証できます。この最速かつ最小コストのPoCループをHIGのメンバー自身の手で回せることが、医療テクノロジー変革の強力なエンジンになると確信しています。</p>
<h2 id="受講者からの声">受講者からの声</h2><h3 id="Vibe-CodingからAgentic-Engineeringへ、そしてモノづくりの原点">Vibe CodingからAgentic Engineeringへ、そしてモノづくりの原点</h3><p>Andrej Karpathy氏が提唱したVibe Codingはプログラミングのハードルを劇的に下げ、非エンジニアにも自らの手でプロダクトを生み出す可能性を示してくれました。そして時代はさらに進み、AIエージェントと共に開発を進めるAgentic Engineeringのフェーズへと至っています。</p>
<p>コーディングそのものはAIに任せ、人間は設計、検証、意思決定に思考のリソースを集中させる。開発のスタイルは今、根本から変化しています。</p>
<p>今回のAI駆動開発研修を通じて、私が強く実感したのは、AIに指示を出す前の思考の深さの重要性でした。</p>
<ul>
<li><strong>何を作りたいのか（コンセプト）</strong>: 解決すべき本質的な課題はどこにあるのか</li>
<li><strong>どのように使われるのか（ユースケース）</strong>: 現場のリアルな利用シーンや運用フローはどうなっているか</li>
<li><strong>どう見せるのか（UI&#x2F;UX）</strong>: ユーザーが直感的に迷わず操作できる画面レイアウトか</li>
</ul>
<p>これらを人間側が高い解像度で定義して初めて、AIは真価を発揮する強力なパートナーになってくれます。</p>
<p>研修の中で、ふと中学生の目線に戻っている自分に気づきました。</p>
<p>当時は分厚いHTML辞典やJavaScript辞典を机の脇に積み上げ、1行1行のタグと格闘しながら夢中でWebサイトを作っていました。エラーが消えずに頭を抱えたあの歯がゆさ。思い通りにブラウザ上で動いた瞬間の達成感。</p>
<p>今回の研修でAIと対話し、プロンプトを練り直し、画面が形になっていくプロセスは、まさにあの頃味わった純粋なモノづくりの楽しさそのものでした。</p>
<p>技術が進化しツールが分厚い辞書からAIへ変わっても、アイデアが手の中で形になる感動は変わりません。AIという最高の相棒を得た今、またあの頃のような情熱をもって、現場の課題を解決するプロダクトづくりに挑んでいきます。（野村）</p>
<h3 id="AI駆動開発の本質はディレクターシップ">AI駆動開発の本質はディレクターシップ</h3><p>AIは、何でも自動で仕様を決めてくれる魔法の杖ではありませんでした。</p>
<p>自分の出した指示（プロンプト）の質が、そのまま結果に直結するということを、研修を通じて深く実感しました。AIの提案をただ受け取るのではなく、根拠となる一次情報を自分で確認したり、あらかじめ守るべきルールを明確に定め、責任を持って開発を動かすのは人間なのだと深く再認識しました。</p>
<p>AI開発の本質は、AIという頼れる相棒を主体的かつ冷静に導く「ディレクターシップ」そのもの。不確実性の高い開発プロセスにおいて、目的を見失わず軌道修正を重ねた経験も含めて、その重要性を身をもって確信できたことが、今回の研修での最大の収穫でした。（久保）</p>
<h2 id="おわりに">おわりに</h2><p>元医療従事者と事業企画推進という非ITエンジニアの私たちがAI駆動開発研修に挑んだこの3ヶ月は、単なるスキルの習得を超え、AIをパートナーとして共に創るというマインドセットへの転換期となりました。</p>
<p>AI駆動開発は、決してエンジニアだけの特権ではありません。医療現場の課題に向き合う私たちがAIを相棒として創り手になることこそ、医療DXを加速させるカギになると確信しています。</p>
<p>私たちはこの研修で得た知見を武器に、それぞれの専門領域で新たな価値を創出し続けます。現場の課題を一番よく知る私たちが一歩を踏み出し、AIをパートナーに自ら手を動かしてみる。その泥臭い挑戦の積み重ねこそが、医療現場を本当に変えていく原動力になると信じています。</p>
<h2 id="出典-参考リンク">出典 &#x2F; 参考リンク</h2><ul>
<li>フューチャー、AI 社会実装 No.1 カンパニーを目指しステートメントを発表 「AI 駆動開発」による生産性 3 倍と AI×IT のトータルデザインにより社会課題解決を加速</li>
<li>特定器材マスター 告示・データ移行関連情報（社会保険診療報酬支払基金。2026年10月よりDX審査支払機構へ改組）</li>
<li>ICD10対応標準病名マスター（一般財団法人医療情報システム開発センター（MEDIS））</li>
<li>Andrej Karpathy氏が提唱した「Vibe Coding」についての解説記事（Business Insider Japan）</li>
<li>Agentic Engineering（エージェント開発）の解説（NXCode Resources）</li>
</ul>
<div id="footnotes"><hr><div id="footnotelist"><ol style="list-style:none; padding-inline-start: 0;"><li id="fn:1"><span style="vertical-align: top; padding-inline-end: 10px;">1.</span><span style="vertical-align: top;">症状詳記（しょうじょうしょうき）。診療内容の必要性や正当性が審査側に伝わりにくい場合に、その理由や治療経過を詳しく説明して診療報酬請求書に添付する書類やデータのこと。</span> ↩</li><li id="fn:2"><span style="vertical-align: top; padding-inline-end: 10px;">2.</span><span style="vertical-align: top;">診療報酬（しんりょうほうしゅう）。医療機関が患者に提供した保険診療の対価として、国が定めた点数表に基づいてDX審査支払機構等から受け取る費用のこと。</span> ↩</li><li id="fn:3"><span style="vertical-align: top; padding-inline-end: 10px;">3.</span><span style="vertical-align: top;">Hello World（ハロー・ワールド）。プログラミング学習で最初に画面へ文字を表示させる、最小のサンプルプログラム。開発環境が正しく動いていることを確認する意味も持つ。</span> ↩</li><li id="fn:4"><span style="vertical-align: top; padding-inline-end: 10px;">4.</span><span style="vertical-align: top;">Human-in-the-Loop（ヒューマン・イン・ザ・ループ）。AIに判断を任せきりにせず、要所要所で人間が確認し、軌道修正する開発・運用の考え方。</span> ↩</li><li id="fn:5"><span style="vertical-align: top; padding-inline-end: 10px;">5.</span><span style="vertical-align: top;">Schema Enforcement（スキーマ強制）。データの型や項目の構造（スキーマ）をあらかじめ定義し、それに合致しない入出力を受け付けないようにする仕組み。AIの生成結果を決まった形式に縛ることで、記載漏れや表記のばらつきを防ぐ。</span> ↩</li><li id="fn:6"><span style="vertical-align: top; padding-inline-end: 10px;">6.</span><span style="vertical-align: top;">ディレクターシップ。何をどう作るかを決めてAIに指示し、でき上がったものの責任も人間が持つ、いわば“監督役”としての役割。</span> ↩</li></ol></div></div>]]></content>
    <summary type="html">元診療放射線技師と元開発PMの事業企画推進という非ITエンジニアの2人が、Healthcare Innovation Group のAI駆動開発研修に参加しました。医療機器の保守管理アプリと手術記録アプリを3ヶ月で動くプロトタイプにするまでの5つのステップと、研修設計の4つのカギを紹介します。</summary>
    <category term="AIDD" scheme="https://future-architect.github.io/categories/AIDD/"/>
    <category term="VibeCoding" scheme="https://future-architect.github.io/tags/VibeCoding/"/>
    <category term="ヘルスケア" scheme="https://future-architect.github.io/tags/%E3%83%98%E3%83%AB%E3%82%B9%E3%82%B1%E3%82%A2/"/>
    <category term="生成AI" scheme="https://future-architect.github.io/tags/%E7%94%9F%E6%88%90AI/"/>
    <category term="研修" scheme="https://future-architect.github.io/tags/%E7%A0%94%E4%BF%AE/"/>
  </entry>
  <entry>
    <title>クラウド入門 - 知っておくと良い心構え - Part1</title>
    <link href="https://future-architect.github.io/articles/20261005b/"/>
    <id>https://future-architect.github.io/articles/20261005b/</id>
    <published>2026-10-04T15:00:01.000Z</published>
    <updated>2026-10-04T15:00:01.000Z</updated>
    <author><name>林知範</name></author>
    <content type="html"><![CDATA[<img fetchpriority="high" src="/images/2026/20261005b/top.png" alt="" width="1024" height="572">

<p>こんにちは、2026 年 8 月にキャリア入社した林です。</p>
<p>ジョインしたてでチームメンバーにフォローアップしてもらうことが多い中で、何か還元できることはないかと考えました。チームメンバーと会話する中でこれからクラウドインフラを学びたいメンバーがいたので、クラウドインフラを触る上で先に知っておくと良い心構えを講義形式でインプットすることにしました。</p>
<p>本記事では、その講義で扱った題材をピックアップして複数回にまとめていきたいと思います。これからクラウドインフラを学びたいと思っている方や触りたてという方に向けて、基礎を固める役に立てれば幸いです。</p>
<h2 id="全体構成">全体構成</h2><p>講義形式ということで下記のような章立てとしています。<strong>網羅性を重視するよりも私の経験から知っておくと良いトピックを重視した構成</strong>としています。（以降、クラウドインフラを提供するサービスをクラウドと呼びます。）</p>
<ul>
<li>1章 オンプレミスとクラウドの違いを知る（違いを知る）</li>
<li>2章 壊れる前提で、強くする（耐障害性）</li>
<li>3章 セキュリティの基本原則（セキュリティ）</li>
<li>4章 壊れてはいけないもの（データと状態）</li>
<li>5章 なぜ、インフラをコードにするのか（IaC）</li>
<li>6章 見えないものは、直せない（運用と観測性）</li>
<li>7章 何を任せ、何を手元に残すか（マネージド）</li>
</ul>
<p>Part1 の本記事では 1 章から 3 章を扱います。</p>
<h2 id="1章-オンプレミスとクラウドの違いを知る">1章 オンプレミスとクラウドの違いを知る</h2><p>この章では、オンプレからクラウドに変わることで何が変わるのか俯瞰する内容としています。特に触れておきたかったのは<strong>責任共有モデル</strong>です。クラウドは「クラウド事業者に任せる部分」と「利用者が管理する部分」が混在するサービスです。クラウドを利用すればセキュリティ含めすべてやってくれると思われがちですが、サービス形態によって事業者が管理してくれる範囲が異なります。</p>
<p>これはよく耳にする IaaS &#x2F; PaaS &#x2F; SaaS というサービス形態の違いで区分されています。下図のように<strong>青の事業者が責任を持つ範囲が広いほど利用者が背負う責任は狭く</strong>なります。</p>
<figure><img class="bordered" src="/images/2026/20261005b/image_2.png" alt="" width="754" height="521" loading="lazy"><figcaption>図は一般的な責任共有モデルを表現したものであり、クラウド事業者によって細部は異なります</figcaption></figure>
<p>利用するサービスに対してどこから責任を負わなければいけないのかを把握することがクラウドを触る第一歩と言ってもいいのではないでしょうか。</p>
<h3 id="深掘り①：フルマネージドサービス">深掘り①：フルマネージドサービス</h3><p>クラウドを知っていくと<strong>フルマネージドサービス</strong>という単語も出くわすことがあります。私は以前、上記の区分と何が違うのかを混乱したことがあるので関連する概念として簡単に触れておきます。</p>
<p>フルマネージドサービスは、インフラやミドルウェアの運用保守の大部分をクラウド事業者が自動化・代行するサービス形態です。IaaS &#x2F; PaaS &#x2F; SaaS が「どの層までをクラウド事業者に任せるか」というサービス形態の区分であるのに対して、フルマネージドは「運用の手間をどこまでクラウド事業者が引き受けるか」という度合いを表す言葉で、両者は別の軸の話です。</p>
<p>とはいえ、入門の段階では <strong>「PaaS に近い位置づけで、運用保守の自動化がさらに進んだもの（PaaS+α）」</strong> というイメージを持っておけば十分です。その中でも用途ごとに専門化したサービスとして、下図のような 3 種類が例として挙げられます。</p>
<ul>
<li>Container as a Service<ul>
<li>コンテナ単位でアプリケーションを持ち込み、実行と管理をするプラットフォーム</li>
</ul>
</li>
<li>Function as a Service<ul>
<li>特定処理のコード（関数）をイベント駆動で実行するサーバーレス実行環境</li>
</ul>
</li>
<li>Database as a Service<ul>
<li>データベースの構築、バックアップ、スケーリングなどの保守運用を事業者が代行するサービス</li>
</ul>
</li>
</ul>
<p>ただし、同じ分類のサービスでも運用の手間は一様ではありません。例えば、CaaS には Kubernetes のクラスタを提供する GKE（Standard モード）や AKS のように、ノードの管理など利用者側の運用範囲が比較的広いものも含まれます。「CaaS だからフルマネージド」とは限らないので、サービスごとに利用者が何を管理する必要があるかを確認しましょう。</p>
<img class="bordered" src="/images/2026/20261005b/managed-services.png" alt="" width="1200" height="723" loading="lazy">

<p>最後に Google Cloud と Azure で該当するサービス例を挙げます。個人的に Google Cloud 推しなので、CaaS といえば <strong>Cloud Run</strong> をぜひ知ってほしいです。その理由は、デプロイや運用の容易さやスケーラビリティ、コストの低さなどどれを取っても申し分ないと思っているからです。また、下記の表には掲載していませんが、NewSQL なら **Spanner**、DWH なら <strong>BigQuery</strong> が Google Cloud のフルマネージドサービスとして有名です。</p>
<p>このように 1 つのクラウドで主要なサービスの特性を理解しておくと、他クラウドの類似サービスを扱う際にも構造や役割の推測が容易になります。クラウドを知っていく上で業務に近かったり興味を惹かれるクラウドをどれか 1 つを深掘りしてから他クラウドにも手を伸ばすことをお勧めします。</p>
<img class="bordered" src="/images/2026/20261005b/service-examples.png" alt="" width="939" height="403" loading="lazy">

<h2 id="2章-壊れる前提で、強くする">2章 壊れる前提で、強くする</h2><p>この章では、クラウドにおける耐障害性の基本思想とそれを実現する設計パターンを整理した内容としています。ここでは<strong>ステートレス設計</strong>をピックアップします。ステートレス設計は、<strong>分散システムにおける耐障害性を確保するために不可欠な要素</strong>となっています。</p>
<p>利用者からのリクエストを受け付けるサーバーが複数台存在するケースで、ステートフルな構成では特定のサーバーがダウンした際にそのメモリやローカルディスクに保持されたセッション情報が失われて、同一ユーザーからのリクエストを代替サーバーで引き継げないといったことが生じます。これに対してステートレスな構成ではノード間に機能上の個体差が存在せず、ロードバランサーが異常ノードを検知した瞬間にトラフィックを正常ノードへ切り替えるだけで復旧を完結させることができます。</p>
<img class="bordered" src="/images/2026/20261005b/image_3.png" alt="" width="737" height="426" loading="lazy">

<p>ステートをどこに逃がすかという具体的な実装はプロバイダーやアーキテクチャによって異なります（例えば、セッションやファイルは DB やキャッシュ、オブジェクトストレージなどの外部ストアに移すなど）が、ここで押さえておきたいのは<strong>サーバー自身は使い捨てにできる状態を保つ</strong>という考え方そのものです。この考え方はスケーラビリティの前提とも言えるので、次で簡単に触れておきます。</p>
<h3 id="深掘り②：スケーラビリティ">深掘り②：スケーラビリティ</h3><p>ステートレスな構成は、クラウドを触る上でよく耳にするスケーラビリティとも非常に関連性が高いです。スケーラビリティとは、<strong>システムの負荷増大に応じてリソースを追加して、処理能力を柔軟に拡張できる能力</strong>を指します。</p>
<p>計算リソースを追加して処理能力を高める水平スケーリング（スケールアウト）を成立させるには、すべての計算リソースは機能的に等価、つまり内部に状態を持たずに処理できることが求められます。これによりロードバランサーが特定のユーザーを特定ノードに依存せずトラフィックを分散できるため、計算リソースを追加した分だけ処理能力を拡張できます。</p>
<p>この内部に状態を持たない &#x3D; ステートレスな構成であるため、スケーラビリティを得るための前提となるアーキテクチャになります。</p>
<img class="bordered" src="/images/2026/20261005b/image_4.png" alt="" width="939" height="601" loading="lazy">

<h2 id="3章-セキュリティの基本原則">3章 セキュリティの基本原則</h2><p>この章では、クラウドの責任共有モデルにおいて利用者が責任を負う範囲を守るための、基礎的な原則を整理した内容としています。クラウドを安全に触る上で知っておくと良いセキュリティ観点の知識を詰め込んだので、他章より厚めにまとめます。</p>
<p>クラウドにおけるセキュリティ対策の目的は、大きく「攻撃を受けにくくする（予防）」と「何か起きた時に気づき、対処する（検知・対応）」の 2 つに分けられます。本章ではまず予防の考え方として、<strong>第三者が攻撃に利用できる面であるアタックサーフェイスを小さくする</strong>ための 3 つのポイントに触れます。</p>
<ul>
<li>最小権限の原則（IAM 層）</li>
<li>ネットワーク境界設計（境界 NW 層）</li>
<li>シークレット管理（データ・鍵層）</li>
</ul>
<img class="bordered" src="/images/2026/20261005b/image_5.png" alt="" width="1189" height="545" loading="lazy">

<p>参考：Azure セキュリティの概要</p>
<p>まずは、<strong>最小権限の原則</strong>です。クラウドを触る上で認証&#x2F;認可（誰が何をできるかを制御する仕組み）が必要不可欠になります。この認証認可を司るサービスを IAM（Identity and Access Management）と言い、特定のアカウントに対して権限を付与することで制御を実現しています。</p>
<p><strong>権限を付与する際に「必要最低限に留める」というのが最小権限の原則の根幹</strong>となります。なぜ必要最低限にするのかというと、アカウントの誤操作や認証情報の漏洩が生じた際の被害範囲の拡大を防ぐためです。</p>
<p>ただ、毎回本当に必要最低限で権限付与することはセキュリティを高める一方で開発や検証作業のアジリティを低下させるといったトレードオフを生じさせます。そのため、どの環境にも一律でこの原則を適用するというよりも開発 &#x2F; 検証 &#x2F; 本番といった環境の差異に応じて「どこまでリスクを許容できるか」を検討した上で権限付与の程度を変えることが現実的な運用となります。</p>
<img class="bordered" src="/images/2026/20261005b/image_6.png" alt="" width="895" height="467" loading="lazy">

<p>次は<strong>ネットワークの境界設計</strong>です。クラウドにおけるネットワーク制御では、パブリック（公開）とプライベート（非公開）の領域を明示的に切り分け、通信経路を制御することが基本になります。</p>
<p><strong>アクセスを許可する際の原則は「デフォルトで非公開とし、必要な通信のみを後から開ける」こと</strong>です。なぜデフォルト非公開にするのかというと、オンプレミス環境のような物理的隔絶が存在しないクラウドでは、設定変更ひとつで社内向けリソースが全世界へ露出してしまうためです。データベースや内部向けサーバーに安易にパブリック IP アドレスを付与せず、プライベートネットワーク内に配置した上で、許可された通信経路のみを明示的に開ける設計が求められます。</p>
<img class="bordered" src="/images/2026/20261005b/image_7.png" alt="" width="890" height="434" loading="lazy">

<p>最後に<strong>シークレット・認証情報の扱い</strong>です。クラウドを触っているとデータベースへのアクセス情報やアカウントの認証キーなどの公開すべきではない情報に触れる機会が増えます。これらの情報は、<strong>公開されてしまうと想定以上の被害を被る可能性の高い情報なので扱いはより一層慎重になる必要があります。</strong></p>
<p>被害の具体例として、アカウントの認証キーの漏洩によってクラウド環境が悪用されるといったことがあります。アカウントの認証キーとは、特定の文字列や JSON ファイルであることが多く、それさえあれば該当のアカウントとして認証でき権限を行使できるものを指します。アカウントに過剰な権限を付与した状態で認証キーを払い出し、これを誤って公開リポジトリにコミットしてしまったとします。悪意のある第三者がこれを発見してしまえば、そのアカウントに付与されている権限を行使できてしまいます。例えば、VM を可能な限り作成してマイニング用の処理サーバーとしたり、他社を攻撃するための踏み台サーバーにするといった悪用方法があります。</p>
<p>こういったセキュリティインシデントを 100% 発生させないということは難しい話です。人間が操作していれば見落としや誤操作は発生しうるものだからです。具体例に出たアカウントの認証キーについては払い出さないことを第一の選択肢としつつ、シークレット・認証情報を扱う際には、こちらで記載した基本原則を守ることでそのリスクを低くしながら運用することが非常に重要となります。</p>
<img class="bordered" src="/images/2026/20261005b/image_8.png" alt="" width="890" height="466" loading="lazy">

<h3 id="深掘り③：AI-エージェント専用の識別子">深掘り③：AI エージェント専用の識別子</h3><p>少し前までクラウド上で権限が付与される対象は人間用のアカウントかマシン用のアカウントでした。しかし、AI エージェントがアプリケーションに組み込まれることが多くなってきた昨今では、<strong>エージェント専用のアカウントを割り当てて管理するサービス</strong>も出てきました。Google Cloud で言えば、Agent Identity といったサービスが存在します。従来のマシンアカウントでは要件を満たせないエージェントの挙動に対して制御や追跡が可能となります。</p>
<h3 id="深掘り④：AI-エージェントによるクラウド操作の代行">深掘り④：AI エージェントによるクラウド操作の代行</h3><p>Cursor や Claude などをエディターやターミナルで動かして、人間の操作を代行させることが当たり前になってきました。その一例として、開発者であればクラウドへの操作もエージェントに代行させることがあると思います。この時エージェントは誰の権限を使ってクラウドに操作をするかというと、<strong>多くの場合に開発者自身（人間用アカウント）の認証情報を流用してクラウドを操作しています。</strong></p>
<p>手元の開発作業を円滑に進めるため、人間用のアカウントには開発環境全体の閲覧や変更といった広い権限が割り当てられている場合が多いと思います。<strong>この状態でエージェントがコマンドの生成や実行を誤ると、意図しないリソースの削除や構成変更が即座に実行されるリスクが生じます。</strong></p>
<p>このリスクを抑えるには、エージェントがクラウドを操作する際に許容する操作と許容しない操作の境界をどのように強制するかが問題となります。ここで押さえておきたいのは、ローカルでエージェントを動かしている限り、エージェントは開発者と同じ環境・同じ認証情報を使える状態にあるということです。以下のような対策を複数組み合わせて、許容できるレベルまでリスクを下げるという考え方が重要です。</p>
<ol>
<li>操作の経路を絞る（ハーネスでの制御）<ul>
<li>MCP サーバー上に許容する操作だけを定義してそこを経由させ、エージェント側の設定で CLI の直接実行を禁止</li>
<li>誤操作の防止には手軽で効果的だが、スクリプト経由などで迂回される余地は残る</li>
</ul>
</li>
<li>操作する主体の権限を絞る（IAM での制御）<ul>
<li>人間用アカウントではなく、低権限のアカウントとして操作させる</li>
<li>Google Cloud では権限借用を用いて、認証キー無しで短い期間有効なトークンを利用可能</li>
<li>ただし、人間用アカウントの認証情報が手元に残るため、強制力はない</li>
</ul>
</li>
<li>人間の認証情報から隔離する（実行環境での制御）<ul>
<li>人間用アカウントの認証情報がないコンテナや VM でエージェントを動かし、最低限の権限を持つ短命なトークンだけを渡す</li>
<li>最も強固な一方で、準備と運用の手間がかかる</li>
</ul>
</li>
</ol>
<p>すべてを常に実施する必要はなく、環境に応じたリスク許容で判断するのがよいと思います。重要なのは、「エージェントは自分と同じ権限を持っている」ことを意識した上で、どこまで任せるかを自分で決めることです。</p>
<img class="bordered" src="/images/2026/20261005b/image_9.png" alt="" width="931" height="527" loading="lazy">

<h3 id="深掘り⑤：パブリック-IP-アドレスの不付与">深掘り⑤：パブリック IP アドレスの不付与</h3><p>VM などにインターネット経由でアクセスする際にパブリック IP アドレスは便利です。しかし、<strong>インターネット経由で自分がアクセスできるということは他者もアクセスできる可能性がある</strong>とも言えます。他者がアクセスできる可能性が 0% でないなら、適切なセキュリティ設定をする必要があります。</p>
<p>その適切なセキュリティ設定を考えることももちろんですが、まずは<strong>パブリック IP アドレスが本当に必要かどうかを検討します</strong>。例えば、開発作業用の VM を作成して SSH したいといったケースを考えます。パブリック IP アドレスを付与したくなるところですが、昨今のクラウドではパブリック IP アドレスを付与しなくても VM に SSH 可能なサービスや機能があるので、そのサービスの利用検討から始めることをお勧めします。</p>
<p>主要なクラウド事業者では、パブリック IP アドレスを持たない VM へ安全に接続するための専用機能を提供しています。</p>
<ul>
<li><p>Google Cloud：IAP（Identity-Aware Proxy）</p>
<ul>
<li>インターネット経由で Google の認証&#x2F;プロキシ基盤に接続してから、Google 専用のネットワークを通って VM の内部 IP に安全にアクセスできる</li>
<li>IAP を利用することでパブリック IP アドレスの付与なしに VM へ SSH 可能となる</li>
</ul>
</li>
<li><p>Azure：Azure Bastion</p>
<ul>
<li>パブリック IP アドレスは必要だが、VM に付与するのではなく Azure Bastion にのみ付与する</li>
<li>Azure Bastion はインターネット経由でアクセスしたいリソースの前段に置かれ、アクセスポイントを集約する</li>
<li>VM にパブリック IP アドレスを付与するのと異なり、22 番ポートを公開せずに 443 番ポートでのアクセスになるため 22 番ポートを直接露出することで生じるリスクを回避できる</li>
</ul>
</li>
</ul>
<p>インターネット経由でリソースにアクセスする際は、対象のリソースに必ずパブリック IP が必要ということにとらわれず、提供されている機能やサービスを駆使してアクセスできないかをまずは検討してみてください。</p>
<h3 id="深掘り⑥：シークレット-認証情報のアプリケーションでの取り扱い">深掘り⑥：シークレット&#x2F;認証情報のアプリケーションでの取り扱い</h3><p>深掘りの最後は、データベースのアクセス情報や外部 SaaS の API キーなど、アプリケーションで扱わざるを得ないシークレットや認証情報についてです。アプリケーションでこういった情報を使いたい時の安易な選択肢として、アプリケーションコードへのハードコーディングや設定ファイル・デプロイ定義に平文で書くことが考えられます。</p>
<p>上述した通り、シークレットや認証情報は漏洩により大きな被害をもたらす可能性があります。<strong>漏洩の 1 つの原因は平文での設定です</strong>。コンテナ内だから安全だろう、プライベートリポジトリだから誰にも見られないだろう、そういった考えから平文のまま扱うことは漏洩リスクを高めます。</p>
<p>主要なクラウド事業者ではシークレットや認証情報を安全に扱うためのサービスを提供しています。</p>
<ul>
<li>Google Cloud：Secret Manager<ul>
<li>API キーやデータベースの接続文字列などの秘密情報を、暗号化した状態で一元管理するサービス</li>
<li>アプリケーションのコードやコンテナの環境変数に平文で値を保持させる代わりに、アプリケーション実行時に API を介して動的にシークレットを取得する構成をとる</li>
<li>IAM と連携させることで、特定のサービスアカウントを持つアプリケーションのみに読み取り権限を絞り込むことが可能となる</li>
</ul>
</li>
<li>Azure：Azure Key Vault<ul>
<li>シークレット、暗号化キー、API キーや証明書を安全に保護・一元管理するためのマネージドサービス</li>
<li>マネージド ID（Managed Identity）機能と組み合わせることで、Key Vault 自体にアクセスするための認証キーすらアプリケーション側に保持させる必要がなくなる</li>
<li>アプリケーションは実行時に自らのマネージド ID を用いて Azure Key Vault へ認証して、必要な秘密情報のみをメモリ上に読み出して利用する</li>
</ul>
</li>
</ul>
<p>これらのサービスを使うメリットは、平文を置かないことだけではありません。シークレットをバージョン管理できるため、定期的なローテーションや、漏洩時の差し替えがしやすくなります。また、誰がいつシークレットにアクセスしたかを監査ログで追えるようになります。</p>
<p>ソースコードや静的な設定ファイルへシークレットを平文で記述する運用は漏洩のリスクを高めるため、<strong>管理サービスで一元管理した上で実行時に取得する構成</strong>を設計の基本として採用してみてください。</p>
<img class="bordered" src="/images/2026/20261005b/image_10.png" alt="" width="895" height="508" loading="lazy">

<h2 id="おわりに">おわりに</h2><p>これからクラウドを触りたい・知りたい方向けに私の経験から知っておくと良い心構えを Part1 として「オンプレミスとの違い」「耐障害性の基本思想」「セキュリティ」の 3 つの観点でまとめました。</p>
<p>少し心構えから脱線して具体の話もありましたが、ここまで読んでくださった方が少しでも勇気と自信を持ってクラウドを触れるマインドセットになっていれば幸いです。Part2 にもご期待ください！</p>
]]></content>
    <summary type="html">クラウドインフラを触る前に知っておくと良い心構えを講義形式でまとめた連作の Part1 です。責任共有モデルとフルマネージドサービス、ステートレス設計とスケーラビリティ、最小権限・ネットワーク境界・シークレット管理の 3 原則に加えて、AI エージェントにクラウド操作を代行させるときのリスクと対策を扱います。</summary>
    <category term="Cloud" scheme="https://future-architect.github.io/categories/Cloud/"/>
    <category term="AIエージェント" scheme="https://future-architect.github.io/tags/AI%E3%82%A8%E3%83%BC%E3%82%B8%E3%82%A7%E3%83%B3%E3%83%88/"/>
    <category term="Azure" scheme="https://future-architect.github.io/tags/Azure/"/>
    <category term="GoogleCloud" scheme="https://future-architect.github.io/tags/GoogleCloud/"/>
    <category term="IAM" scheme="https://future-architect.github.io/tags/IAM/"/>
    <category term="入門" scheme="https://future-architect.github.io/tags/%E5%85%A5%E9%96%80/"/>
  </entry>
  <entry>
    <title>Java 26 / Java 27 リリースまとめ</title>
    <link href="https://future-architect.github.io/articles/20261005a/"/>
    <id>https://future-architect.github.io/articles/20261005a/</id>
    <published>2026-10-04T15:00:00.000Z</published>
    <updated>2026-10-04T15:00:00.000Z</updated>
    <author><name>前川喜洋</name></author>
    <content type="html"><![CDATA[<img fetchpriority="high" src="/images/2026/20261005a/top.jpg" alt="" width="600" height="395">

<h2 id="はじめに">はじめに</h2><p>Java連載2026 の3本目です。2026年3月にリリースされたJava 26と、9月のJava 27について、主なJEPとJEP以外の運用に関わる変更、アップグレード時の注意点をまとめます。</p>
<h2 id="Java-26-2026年3月-の主なJEP">Java 26(2026年3月)の主なJEP</h2><div class="scroll" tabindex="0" role="region" aria-label="表 JEP / 機能 / ステータス"><table>
<thead>
<tr>
<th>JEP</th>
<th>機能</th>
<th>ステータス</th>
</tr>
</thead>
<tbody><tr>
<td>517</td>
<td>HTTP&#x2F;3 for the HTTP Client API</td>
<td>正式</td>
</tr>
<tr>
<td>516</td>
<td>Ahead-of-Time Object Caching with Any GC</td>
<td>正式</td>
</tr>
<tr>
<td>522</td>
<td>G1 GC: Improve Throughput by Reducing Synchronization</td>
<td>正式</td>
</tr>
<tr>
<td>500</td>
<td>Prepare to Make Final Mean Final</td>
<td>正式</td>
</tr>
<tr>
<td>504</td>
<td>Remove the Applet API</td>
<td>削除</td>
</tr>
<tr>
<td>526</td>
<td>Lazy Constants</td>
<td>第2プレビュー</td>
</tr>
<tr>
<td>524</td>
<td>PEM Encodings of Cryptographic Objects</td>
<td>第2プレビュー</td>
</tr>
<tr>
<td>530</td>
<td>Primitive Types in Patterns, instanceof, and switch</td>
<td>第4プレビュー</td>
</tr>
<tr>
<td>525</td>
<td>Structured Concurrency</td>
<td>第6プレビュー</td>
</tr>
<tr>
<td>529</td>
<td>Vector API</td>
<td>第11インキュベータ</td>
</tr>
</tbody></table></div>
<h3 id="HTTP-3対応-JEP-517">HTTP&#x2F;3対応(JEP 517)</h3><p>Java 11で導入された<code>HttpClient</code>がHTTP&#x2F;3(QUIC)に対応しました。既定は引き続きHTTP&#x2F;2で、HTTP&#x2F;3はビルダーで<code>.version(HttpClient.Version.HTTP_3)</code>を指定する<strong>オプトイン</strong>です。外部ライブラリなしで多重化と低レイテンシの恩恵を受けられます。</p>
<h3 id="AOTオブジェクトキャッシュの全GC対応-JEP-516">AOTオブジェクトキャッシュの全GC対応(JEP 516)</h3><p>Project Leyden由来のAOTキャッシュ(訓練実行でロード・リンクしたクラスや初期化済みオブジェクトを保存し、次回以降の起動で再利用する仕組み)が、GCに依存しない形式で初期化済みオブジェクトを逐次ロードできるようになりました。これにより<strong>ZGCでも</strong>起動・ウォームアップ高速化を使えます。</p>
<p>手元の小さなアプリで試したところ、Java 25のZGCではオブジェクトを保存できず(<code>ZGC is not supported</code>)、キャッシュを使っても起動は速くなりませんでした。Java 27ではZGCでもG1と同じように、起動時間が大きく短縮されました。</p>
<p>なお、既定の<code>-XX:AOTMode=auto</code>ではキャッシュを使えなくてもそのまま起動を続けます。キャッシュが効いているかを確かめるときは<code>-XX:AOTMode=on</code>を付けると、使えない場合に起動が失敗するので気づけます。</p>
<h3 id="finalを本当にfinalにする準備-JEP-500">finalを本当にfinalにする準備(JEP 500)</h3><p>武田さんの こちらの記事で詳しく解説しています。</p>
<h3 id="Lazy-Constants-JEP-526、第2プレビュー">Lazy Constants(JEP 526、第2プレビュー)</h3><p>旧<code>StableValue</code>から改名・整理された<code>LazyConstant</code>です。初回アクセス時に一度だけ計算され、以降はJITが定数として最適化できます。ダブルチェックロッキングやHolderクラスイディオムの置き換えになります。</p>
<div class="code-block"><figure class="highlight java"><input type="checkbox" id="code-wrap-jmilzg-1" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-jmilzg-1" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="comment">// --enable-preview が必要</span></span><br><span class="line"><span class="keyword">class</span> <span class="title class_">OrderService</span> &#123;</span><br><span class="line">    <span class="keyword">private</span> <span class="keyword">static</span> <span class="keyword">final</span> LazyConstant&lt;Logger&gt; LOGGER =</span><br><span class="line">            LazyConstant.of(() -&gt; Logger.getLogger(<span class="string">&quot;orders&quot;</span>));</span><br><span class="line"></span><br><span class="line">    <span class="keyword">void</span> <span class="title function_">submit</span><span class="params">(Order o)</span> &#123;</span><br><span class="line">        LOGGER.get().info(<span class="string">&quot;submit &quot;</span> + o.id());  <span class="comment">// 初回のみ初期化</span></span><br><span class="line">    &#125;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure></div>

<p>ただし、初期化に失敗したときの挙動は一般的なダブルチェックロッキングと違います(JDK 27で確認)。</p>
<ul>
<li>初期化中に例外が出ると、その失敗が記録されて<strong>再計算されません</strong>。以降の<code>get()</code>は常に<code>NoSuchElementException</code>になります現行の実装が「一時的な失敗のあと再試行によりいずれ成功する」ことを期待する仕組みになっている場合、<code>LazyConstant</code>に置き換えると回復できなくなります。</li>
<li>初期化の処理が<code>null</code>を返した場合も失敗として記録されます(原因は<code>NullPointerException</code>)。値がないことを表したいときは<code>Optional</code>などで包みます</li>
</ul>
<h3 id="JEP以外の重要な変更">JEP以外の重要な変更</h3><p>ここでは運用への影響が大きい初期ヒープサイズの既定値変更だけを取り上げます。そのほかの変更はJDK 26 Release Notesを参照してください。</p>
<p><strong>InitialRAMPercentageの既定値廃止(JDK-8371986、CSR JDK-8371987)</strong></p>
<p><code>-Xms</code>を指定しない場合の初期ヒープは、これまで物理メモリの1&#x2F;64でした。Java 26では<code>InitialRAMPercentage</code>の既定値が0になり、初期ヒープは<code>MinHeapSize</code>と同じ値になります。起動は速くなりますが、起動直後にヒープ拡張のGCが増えることがあります。スループットや起動直後のレイテンシが悪化した場合は、<code>-Xms512m</code>のように初期ヒープを明示しましょう。</p>
<h2 id="Java-27-2026年9月-の主なJEP">Java 27(2026年9月)の主なJEP</h2><p>テーマは <strong>「良い既定値をオプトインなしで有効にする」</strong> です。G1とコンパクトオブジェクトヘッダのデフォルト化は、コードを変えなくても挙動が変わります(InfoQ)。</p>
<div class="scroll" tabindex="0" role="region" aria-label="Java 27(2026年9月)の主なJEPの表 JEP / 機能 / ステータス"><table>
<thead>
<tr>
<th>JEP</th>
<th>機能</th>
<th>ステータス</th>
</tr>
</thead>
<tbody><tr>
<td>523</td>
<td>Make G1 the Default Garbage Collector in All Environments</td>
<td>正式</td>
</tr>
<tr>
<td>534</td>
<td>Compact Object Headers by Default</td>
<td>正式</td>
</tr>
<tr>
<td>527</td>
<td>Post-Quantum Hybrid Key Exchange for TLS 1.3</td>
<td>正式</td>
</tr>
<tr>
<td>536</td>
<td>JFR In-Process Data Redaction</td>
<td>正式</td>
</tr>
<tr>
<td>531</td>
<td>Lazy Constants</td>
<td>第3プレビュー</td>
</tr>
<tr>
<td>538</td>
<td>PEM Encodings of Cryptographic Objects</td>
<td>第3プレビュー</td>
</tr>
<tr>
<td>532</td>
<td>Primitive Types in Patterns, instanceof, and switch</td>
<td>第5プレビュー</td>
</tr>
<tr>
<td>533</td>
<td>Structured Concurrency</td>
<td>第7プレビュー</td>
</tr>
<tr>
<td>537</td>
<td>Vector API</td>
<td>第12インキュベータ</td>
</tr>
</tbody></table></div>
<h3 id="G1が全環境でデフォルトに-JEP-523">G1が全環境でデフォルトに(JEP 523)</h3><p>これまでJVMは「サーバークラスマシン」と判定しない小さな環境(例: 1 CPU・低メモリのコンテナ)でSerial GCを選んでいました。Java 27からは環境に関わらずG1が既定です。意図せずSerial GCで動いていた小さなPodは、フラグなしでG1になります(The Register)。</p>
<p>メモリが極端に小さい環境で従来どおりにしたい場合は<code>-XX:+UseSerialGC</code>を明示します。どのGCが選ばれているかは次のコマンドで確認できます。</p>
<figure class="highlight bash"><table><tr><td class="code"><pre><span class="line">java -Xlog:gc -version</span><br><span class="line"><span class="comment"># [0.005s][info][gc] Using G1</span></span><br></pre></td></tr></table></figure>

<h3 id="コンパクトオブジェクトヘッダがデフォルトに-JEP-534">コンパクトオブジェクトヘッダがデフォルトに(JEP 534)</h3><p>武田さんの こちらの記事で詳しく解説しています。</p>
<h3 id="TLS-1-3の耐量子ハイブリッド鍵交換-JEP-527">TLS 1.3の耐量子ハイブリッド鍵交換(JEP 527)</h3><p>従来のECDHEとNIST標準のML-KEMを組み合わせたハイブリッド鍵交換(<code>X25519MLKEM768</code>など)がJSSEに入りました。「今盗聴して将来復号する(Harvest Now, Decrypt Later)」攻撃への対策で、標準の<code>SSLSocket</code>や<code>HttpClient</code>を使っていればアプリコードの変更なしで恩恵を受けられます。</p>
<p>注意したいのはClientHelloの大きさです。ML-KEM-768の公開鍵(1184バイト)が乗るため、手元の計測ではJava 25の422バイトからJava 27では1578バイトに増えました。一般的なMTU(1500バイト)を超えて複数のTCPセグメントに分かれるので、ClientHelloが1パケットに収まる前提で作られた古いミドルボックスやロードバランサで接続できなくなることがあります。問題が出た場合は、鍵交換グループを従来のものに絞ると元の大きさ(約410バイト)に戻せます。</p>
<div class="code-block"><figure class="highlight bash"><input type="checkbox" id="code-wrap-jmilzg-2" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-jmilzg-2" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line">java -Djdk.tls.namedGroups=x25519,secp256r1 -jar app.jar</span><br></pre></td></tr></table></figure></div>

<h3 id="JFRのプロセス内データ秘匿化-JEP-536">JFRのプロセス内データ秘匿化(JEP 536)</h3><p>Java Flight Recorderが、記録を確定させる前に機密情報を取り除けるようになりました。本番環境のJFRファイルをベンダーや別チームに渡す運用がしやすくなります。</p>
<p>秘匿化は既定で有効です。キー名が<code>*password*</code>、<code>*secret*</code>、<code>*token*</code>などに一致する環境変数・システムプロパティの値(<code>redact-key</code>)と、一致するコマンドライン引数(<code>redact-argument</code>)が<code>[REDACTED]</code>に置き換わります。パターンは追加もできます。</p>
<div class="code-block"><figure class="highlight bash"><input type="checkbox" id="code-wrap-jmilzg-3" class="code-wrap-input" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-jmilzg-3" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="comment"># 既定パターンに *cred* を追加(先頭の + で追記、付けないと置き換え)</span></span><br><span class="line">java -XX:FlightRecorderOptions:redact-key=+*cred* -XX:StartFlightRecording -jar app.jar</span><br></pre></td></tr></table></figure></div>

<p>秘匿化はベストエフォートです。<code>jdk.ProcessStart</code>(子プロセスの引数)や<code>jdk.InitialSecurityProperty</code>は対象外なので、JFRファイルを外部に渡す前の確認は引き続き必要です。対象になるイベントは<code>java -XX:FlightRecorderOptions:help</code>で確認できます。</p>
<h3 id="プレビューの継続">プレビューの継続</h3><p>プリミティブ型パターンを使うと、次のように値の範囲で安全に分岐できます。</p>
<div class="code-block"><figure class="highlight java"><input type="checkbox" id="code-wrap-jmilzg-4" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-jmilzg-4" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="comment">// --enable-preview が必要</span></span><br><span class="line"><span class="keyword">static</span> String <span class="title function_">classify</span><span class="params">(<span class="type">long</span> value)</span> &#123;</span><br><span class="line">    <span class="keyword">return</span> <span class="keyword">switch</span> (value) &#123;</span><br><span class="line">        <span class="keyword">case</span> <span class="type">int</span> i  -&gt; <span class="string">&quot;intに収まる: &quot;</span> + i;   <span class="comment">// 情報を失わずにintへ変換できる場合</span></span><br><span class="line">        <span class="keyword">case</span> <span class="type">long</span> l -&gt; <span class="string">&quot;longが必要: &quot;</span> + l;</span><br><span class="line">    &#125;;</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure></div>

<p>「情報を失わずに変換できるか」は、キャストで往復して元に戻るかではなく、値そのものが変わらないかで判定されます。境界値では次のようになります(JDK 27で確認)。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 式 / 結果 / 理由"><table>
<thead>
<tr>
<th>式</th>
<th>結果</th>
<th>理由</th>
</tr>
</thead>
<tbody><tr>
<td><code>-0.0</code>に対する<code>case int i</code></td>
<td>マッチしない</td>
<td><code>0</code>に変換すると符号が失われる</td>
</tr>
<tr>
<td><code>Long.MAX_VALUE instanceof double d</code></td>
<td><code>false</code></td>
<td><code>double</code>では正確に表せない。一方<code>(long)(double)Long.MAX_VALUE</code>は飽和によって元の値に戻るため、キャストの往復で調べる手書きのチェックは誤って通ってしまう</td>
</tr>
<tr>
<td><code>Object o = 42;</code>のあとの<code>o instanceof long l</code></td>
<td><code>false</code></td>
<td><code>Integer</code>は<code>Long</code>ではないのでマッチしない。数値の拡大変換はプリミティブ型同士でだけ行われる</td>
</tr>
</tbody></table></div>
<p>Java 26からStructured Concurrencyを使っている場合は、<code>Joiner.onTimeout()</code>が<code>R timeout()</code>に変わった点に注意が必要です。<code>timeout()</code>は抽象メソッドなので、Java 26に合わせて自作したJoinerはJava 27ではコンパイルできません。また、検査例外が型パラメータ<code>R_X</code>で表されるようになり、<code>allSuccessfulOrThrow(Function&lt;Throwable, R_X&gt;)</code>のように投げる例外の型を呼び出し側で選べます。</p>
<h3 id="JEP以外の重要な変更-1">JEP以外の重要な変更</h3><p>ここでは、指定したままだと起動できなくなるものと、気づかないうちに無視されるようになるものを取り上げます。そのほかの変更はJDK 27 Runtime Updatesを参照してください。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 変更 / チケット / 影響"><table>
<thead>
<tr>
<th>変更</th>
<th>チケット</th>
<th>影響</th>
</tr>
</thead>
<tbody><tr>
<td><code>-noverify</code>、<code>-Xverify:none</code>を削除</td>
<td>JDK-8373481</td>
<td>指定したままだと起動できない。代替なし</td>
</tr>
<tr>
<td><code>MaxRAM</code>、<code>AggressiveHeap</code>、<code>AlwaysActAsServerClassMachine</code>、<code>NeverActAsServerClassMachine</code>が廃止(obsolete)</td>
<td>—</td>
<td>Java 26で非推奨化。指定すると警告が出て無視され、Java 28で起動エラーに</td>
</tr>
</tbody></table></div>
<p><strong>Java 25(LTS)ではこれらのフラグを指定しても警告が出ない</strong>ため、LTSから直接上げると、非推奨の段階を一度も目にしないまま無視されるようになります。<code>MaxRAM</code>でコンテナのメモリ認識を調整していた場合は<code>-Xmx</code>や<code>-XX:MaxRAMPercentage</code>に移しましょう。廃止時期はHotSpotのソースにあるフラグの廃止予定表(arguments.cpp @ jdk-27-gaの<code>special_jvm_flags</code>)で確認しました。</p>
<h2 id="アップグレード時の注意点">アップグレード時の注意点</h2><p>本番はLTS(Java 21&#x2F;25)のまま、<strong>CIでJava 27のビルドとテストを回して次期LTSのJava 29(2027年9月予定)に備える</strong>のが現実的な進め方です。Java 26はJava 27のリリースで更新が止まっているので、非LTSを使うならJava 27へ上げましょう。</p>
<ul>
<li><input disabled="" type="checkbox"> <strong>初期ヒープサイズの既定変更(Java 26)</strong>: 起動直後のGC回数とレイテンシを比べ、必要なら<code>-Xms</code>を明示します</li>
<li><input disabled="" type="checkbox"> <strong>GCの既定変更(Java 27)</strong>: 小さなコンテナでSerial GCからG1に切り替わります。メモリ使用量と停止時間を計測し直します</li>
<li><input disabled="" type="checkbox"> <strong>コンパクトオブジェクトヘッダ(Java 27)</strong>: ヘッダレイアウトに依存するネイティブコードや<code>Unsafe</code>利用ライブラリがないか確認します</li>
<li><input disabled="" type="checkbox"> <strong>finalフィールド書き換えの警告(Java 26〜)</strong>: 起動ログの警告を洗い出し、ライブラリを更新します。原因の特定には<code>--illegal-final-field-mutation=debug</code>、将来の禁止の事前確認には<code>=deny</code>が使えます。将来の禁止に備えて、恐らく最も影響が広い項目です</li>
<li><input disabled="" type="checkbox"> <strong>Applet APIの削除(Java 26)</strong>: <code>java.applet</code>への参照が残っているとコンパイルできません</li>
<li><input disabled="" type="checkbox"> <strong>削除・廃止された起動オプション(Java 27)</strong>: 起動スクリプトやDockerfile、APMエージェントの導入手順に<code>-noverify</code>や<code>MaxRAM</code>などが残っていないか検索します</li>
<li><input disabled="" type="checkbox"> <strong>TLSの鍵交換(Java 27)</strong>: 古いミドルボックスやロードバランサを経由する接続をテストします</li>
</ul>
<p>プレビュー機能(<code>--enable-preview</code>)はリリースごとにAPIが変わります。実際Java 26→27の間でもStructured ConcurrencyやPEMのAPIが見直されているため、本番コードでの利用は避けましょう。</p>
<h2 id="まとめ">まとめ</h2><p>Java 26はHTTP&#x2F;3やAOTキャッシュの拡張といった「使える道具」を増やし、Java 27はG1とコンパクトオブジェクトヘッダを既定化して「何もしなくても速く軽く」しました。耐量子TLSの正式化は、セキュリティ要件の厳しいシステムにとって大きな前進です。</p>
<p>次のLTSはJava 29(2027年9月予定)です。今のうちにJava 27でCIを回し、finalフィールドの警告やGC変更の影響を潰しておくと、次のLTS移行が楽になります。</p>
]]></content>
    <summary type="html">Java 26（HTTP/3 対応・AOT キャッシュの全 GC 対応・Lazy Constants）と Java 27（G1 とコンパクトオブジェクトヘッダの既定化・耐量子 TLS・JFR の秘匿化）の主な JEP と、JEP 以外の運用に関わる変更、アップグレード時の注意点をまとめます。</summary>
    <category term="Programming" scheme="https://future-architect.github.io/categories/Programming/"/>
    <category term="GC" scheme="https://future-architect.github.io/tags/GC/"/>
    <category term="JEP" scheme="https://future-architect.github.io/tags/JEP/"/>
    <category term="Java" scheme="https://future-architect.github.io/tags/Java/"/>
    <category term="Java26" scheme="https://future-architect.github.io/tags/Java26/"/>
    <category term="Java27" scheme="https://future-architect.github.io/tags/Java27/"/>
  </entry>
  <entry>
    <title>Java 27：オブジェクトヘッダが 8 バイトになる（JEP 534）</title>
    <link href="https://future-architect.github.io/articles/20261002a/"/>
    <id>https://future-architect.github.io/articles/20261002a/</id>
    <published>2026-10-01T15:00:00.000Z</published>
    <updated>2026-10-01T15:00:00.000Z</updated>
    <author><name>武田大輝</name></author>
    <content type="html"><![CDATA[<img fetchpriority="high" src="/images/2026/20261002a/top.jpg" alt="" width="600" height="395">

<h2 id="はじめに">はじめに</h2><p>Java連載2026 の2本目です。</p>
<p>Java 27 は 2026年9月15日にリリースされました。この記事では、Java 27 本体に入った JEP 534: Compact Object Headers by Default を取り上げます。HotSpot JVM がすべてのオブジェクトに付けているヘッダを 12 バイトから 8 バイトに縮める機能、Compact Object Headers をデフォルトで有効にする JEP です。</p>
<p>同じ連載で取り上げた JEP 500 と違って、この変更で警告や例外が増えることはありません。Java 27 に上げれば、コードを 1 行も変えずにヒープの使用量が減ります。ただ、「ヘッダが 4 バイト減る」と聞いて、自分のアプリケーションのヒープでどれくらい減るのかを答えられる人は、そう多くないでしょう。オブジェクトによっては 1 バイトも減りません。手元で Java 25 と Java 27 を並べて測ったので、その結果から見ていきます。</p>
<h2 id="そもそもオブジェクトヘッダとは何か">そもそもオブジェクトヘッダとは何か</h2><p>Java のオブジェクトは、ヒープメモリ上では連続したひとかたまりのバイト列として置かれます。その先頭に JVM の使う領域があり、フィールドの値はその後ろに並びます。この先頭の領域がオブジェクトヘッダです。開発者が書くコードからは見えませんが、<code>new</code> で作ったオブジェクトには必ず付き、大きさはクラスや中身によらず一定です。</p>
<p>入っているのは、JVM がそのオブジェクトを扱うために必要な情報で、用途は大きく 4 つあります。</p>
<ul>
<li>型：どのクラスのオブジェクトか（メソッド呼び出し、リフレクション、キャストの判定に使う）</li>
<li>ハッシュ：<code>System.identityHashCode</code> が返す値（一度計算したら変わらない）</li>
<li>GC：何回の GC を生き延びたか、移動したならどこへ移したか</li>
<li>ロック：<code>synchronized</code> が取っているロックの状態</li>
</ul>
<p>100 万個のオブジェクトがあれば、ヘッダも 100 万個分がヒープを占めます。1 個あたり数バイトの差が、全体では大きな量になります。</p>
<h2 id="ヘッダはどう変わったのか">ヘッダはどう変わったのか</h2><p>Java 25 までのヘッダは 2 つに分かれます。前半は mark word と呼ばれ、さきほどの 4 つのうちハッシュ、GC、ロックの 3 つが入ります。後半は型を指すクラスポインタです。mark word が 64 ビット、圧縮クラスポインタが 32 ビットで、合わせて 96 ビット、12 バイトになります。</p>
<p>mark word の 64 ビットに何がどの順で入るかは、HotSpot のソースの markWord.hpp にコメントで書かれています。内訳は次のとおりです。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 ビット / 長さ / 用途"><table>
<thead>
<tr>
<th align="right">ビット</th>
<th align="right">長さ</th>
<th>用途</th>
</tr>
</thead>
<tbody><tr>
<td align="right">42〜63</td>
<td align="right">22</td>
<td>未使用</td>
</tr>
<tr>
<td align="right">11〜41</td>
<td align="right">31</td>
<td>識別ハッシュコード</td>
</tr>
<tr>
<td align="right">7〜10</td>
<td align="right">4</td>
<td>Project Valhalla のための予約</td>
</tr>
<tr>
<td align="right">3〜6</td>
<td align="right">4</td>
<td>GC が数える世代</td>
</tr>
<tr>
<td align="right">2</td>
<td align="right">1</td>
<td>self-forwarded タグ（GC がコピーに失敗した印）</td>
</tr>
<tr>
<td align="right">0〜1</td>
<td align="right">2</td>
<td>ロック状態のタグ</td>
</tr>
</tbody></table></div>
<p>名前の付いたフィールドは合計 42 ビットで、上位の 22 ビットは空いています。それでも 64 ビットあるのは、mark word がマシンのポインタと同じ大きさだからです。</p>
<p>JOL（Java Object Layout）という JVM 内のオブジェクト・レイアウトを解析するためのツールを使用して <code>new Object()</code> の内訳を表示すると、Java 25 では次のようになります。OFF は先頭から何バイト目か、SZ はその要素が占めるバイト数を表します。</p>
<div class="code-block"><figure class="highlight text"><input type="checkbox" id="code-wrap-281ceg-1" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-281ceg-1" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line">java.lang.Object object internals:</span><br><span class="line">OFF  SZ   TYPE DESCRIPTION               VALUE</span><br><span class="line">  0   8        (object header: mark)     0x0000000000000001 (non-biasable; age: 0)</span><br><span class="line">  8   4        (object header: class)    0x00180dc8</span><br><span class="line"> 12   4        (object alignment gap)</span><br><span class="line">Instance size: 16 bytes</span><br><span class="line">Space losses: 0 bytes internal + 4 bytes external = 4 bytes total</span><br></pre></td></tr></table></figure></div>

<p>Object にはフィールドがないので、中身はヘッダの 12 バイトだけです。それでも合計 16 バイトあるのは、JVM がオブジェクトの大きさを 8 の倍数にそろえるからです。切り上げで余った 4 バイトの隙間が、出力の alignment gap にあたります。同じコードを Java 27 で動かすと次のようになります。</p>
<div class="code-block"><figure class="highlight text"><input type="checkbox" id="code-wrap-281ceg-2" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-281ceg-2" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line">java.lang.Object object internals:</span><br><span class="line">OFF  SZ   TYPE DESCRIPTION               VALUE</span><br><span class="line">  0   8        (object header: mark)     0x0018640000000009 (Lilliput)</span><br><span class="line">Instance size: 8 bytes</span><br><span class="line">Space losses: 0 bytes internal + 0 bytes external = 0 bytes total</span><br></pre></td></tr></table></figure></div>

<p>class の行が消えて、mark word だけの 8 バイトになりました。クラスポインタがなくなったわけではありません。さきほど空いていた上位 22 ビットに、さらに圧縮した形で入っています。ほかのフィールドは、1 ビットも動いていません。</p>
<p>では、その 22 ビットはなぜ空いたままだったのでしょうか。mark word は、丸ごと別の値で上書きされることのある場所だったからです。ロックを取るときや、GC がオブジェクトを移動するとき、JVM はこの 64 ビットを作業用の置き場として使っていました。クラスポインタをここに置いていたら、上書きのたびに型が分からなくなります。この上書きをやめる書き直しが Java 24 までに済み、22 ビットが使えるようになりました。</p>
<h2 id="どのオブジェクトが小さくなるのか">どのオブジェクトが小さくなるのか</h2><p>ヘッダが 4 バイト減れば、オブジェクトも 4 バイト減るとは限りません。代表的なクラスについて、オブジェクト 1 個あたりのサイズを GC のクラスヒストグラム（jcmd の GC.class_histogram と同じ情報）から求めてみます。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 クラス / Java 25 / Java 27"><table>
<thead>
<tr>
<th>クラス</th>
<th align="right">Java 25</th>
<th align="right">Java 27</th>
</tr>
</thead>
<tbody><tr>
<td>Object</td>
<td align="right">16</td>
<td align="right">8</td>
</tr>
<tr>
<td>record Point(int x, int y)</td>
<td align="right">24</td>
<td align="right">16</td>
</tr>
<tr>
<td>HashMap.Node</td>
<td align="right">32</td>
<td align="right">24</td>
</tr>
<tr>
<td>Integer</td>
<td align="right">16</td>
</tr>
<tr>
<td>String</td>
<td align="right">24</td>
</tr>
</tbody></table></div>
<p>Integer と String は 1 バイトも変わっていません。ここでも 8 バイト境界が働いています。Integer はヘッダ 12 バイトに int の 4 バイトで、ちょうど 16 バイトに収まっていました。ヘッダが 8 バイトになると 12 バイトですが、8 の倍数に切り上げられて 16 バイトに戻ります。String はフィールドが合計 10 バイトです。ヘッダを足した 22 バイトと 18 バイトは、どちらも 24 バイトに切り上げられます。小さくなるのは、フィールドの合計が 8 の倍数か、8 の倍数まで 1〜3 バイト足りないクラスです。</p>
<p>それでも、実際のデータ構造では減ります。100 万件の <code>HashMap&lt;Integer, String&gt;</code> を作って GC した直後のヒープ使用量を測ってみます。</p>
<div class="code-block"><figure class="highlight java"><input type="checkbox" id="code-wrap-281ceg-3" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-281ceg-3" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="keyword">void</span> <span class="title function_">main</span><span class="params">()</span> &#123;</span><br><span class="line">  Map&lt;Integer, String&gt; map = <span class="keyword">new</span> <span class="title class_">HashMap</span>&lt;&gt;();</span><br><span class="line">  <span class="keyword">for</span> (<span class="type">int</span> <span class="variable">i</span> <span class="operator">=</span> <span class="number">0</span>; i &lt; <span class="number">1_000_000</span>; i++) &#123;</span><br><span class="line">    map.put(i, <span class="string">&quot;value-&quot;</span> + i);</span><br><span class="line">  &#125;</span><br><span class="line">  System.gc();</span><br><span class="line">  <span class="type">var</span> <span class="variable">rt</span> <span class="operator">=</span> Runtime.getRuntime();</span><br><span class="line">  <span class="type">var</span> <span class="variable">usedMiB</span> <span class="operator">=</span> (rt.totalMemory() - rt.freeMemory()) / <span class="number">1024</span> / <span class="number">1024</span>;</span><br><span class="line">  IO.println(<span class="string">&quot;entries=&quot;</span> + map.size() + <span class="string">&quot; usedHeap=&quot;</span> + usedMiB + <span class="string">&quot; MiB&quot;</span>);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure></div>

<figure class="highlight text"><table><tr><td class="code"><pre><span class="line">Java 25: entries=1000000 usedHeap=112 MiB</span><br><span class="line">Java 27: entries=1000000 usedHeap=96 MiB</span><br></pre></td></tr></table></figure>

<p>16 MiB、14% の減少。1 エントリは 4 つのオブジェクトでできています。HashMap の Node、キーの Integer、値の String、そして文字の並びを持つ byte 配列です。小さくなったのは Node と byte 配列で、それぞれ 8 バイトずつ、合わせて 1 エントリあたり 16 バイト減りました。Integer と String は、さきほど説明したとおり変わっていません。</p>
<p>JEP 450 を見ると、実アプリケーションでも 10%〜20% の減少が報告されています。</p>
<blockquote>
<p>Early adopters of Project Lilliput who have tried it with real-world applications confirm that live data is typically reduced by 10%–20%.</p>
</blockquote>
<p>この減り幅は、オブジェクトの大きさから説明がつきます。同じ JEP によれば、ワークロードの平均的なオブジェクトは 32〜64 バイトです。ヘッダの 12 バイトは、その 19%〜38% を占めます。そこから 4 バイト削り、8 バイト境界への切り上げも重なると、全体で 10%〜20% 減る計算になります。</p>
<h2 id="Java-27-でデフォルトになった経緯">Java 27 でデフォルトになった経緯</h2><p>Compact Object Headers そのものは新しい機能ではありません。Java 24 の JEP 450 で実験的機能として入り、Java 25 の JEP 519 で正式な機能になりました。有効にするオプションは Java 24 では <code>-XX:+UnlockExperimentalVMOptions -XX:+UseCompactObjectHeaders</code> の 2 つ、Java 25 では <code>-XX:+UseCompactObjectHeaders</code> の 1 つです。JEP 534 では、このオプションのデフォルト値が true になっただけです。</p>
<p>JEP 534 がデフォルトにしてよい根拠として挙げているのは、Java 24 以降の実績です。Oracle はテストスイートで、Amazon は本番のサービスで、SAP は自社の OpenJDK ディストリビューションのデフォルトとして、それぞれ使ってきました。</p>
<blockquote>
<p>Since JDK 24, compact object headers have proven their stability and performance. They have been tested at Oracle by running the full JDK test suite. They have also been tested at Amazon and SAP. Amazon runs hundreds of services in production with compact object headers, most of them using backports of the feature to JDK 21 and JDK 17. SAP has already switched to compact object headers by default in their downstream OpenJDK fork, the SapMachine; they run a large suite of tests daily and have a large customer base.</p>
</blockquote>
<p>注意点として Java 25 まで使えた <code>-XX:-UseCompressedClassPointers</code> は、Java 27 では指定しても無視されます。これは、圧縮クラスポインタで表せるクラス数の上限（約 400 万個）を超える場合に圧縮をやめるためのオプションですが、Compact Object Headers は圧縮クラスポインタを前提にしているため、この回避策がなくなりました。</p>
<div class="code-block"><figure class="highlight text"><input type="checkbox" id="code-wrap-281ceg-4" class="code-wrap-input" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-281ceg-4" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line">OpenJDK 64-Bit Server VM warning: Ignoring option UseCompressedClassPointers; support was removed in 27.0</span><br></pre></td></tr></table></figure></div>

<p>JEP 450 は、400 万個のクラスをロードするアプリケーションはまだ見たことがない、と書いています。</p>
<h2 id="このアップデートをうけて何をすべきか">このアップデートをうけて何をすべきか</h2><p>基本的には「何もしなくてよい」です。そのうえで、自分のアプリケーションで試すなら、3 つポイントがあります。</p>
<p>1 つ目は、現在 Java 25 を使っているなら今日から試せることです。JEP 519 で正式な機能になっているので、<code>-XX:+UseCompactObjectHeaders</code> を付けるだけで有効になります。実際にこのオプションを付けた Java 25 でさきほどのクラスヒストグラムを取ると、Java 27 と同じ数字になりました。Java 27 へバージョンアップする前に、自分のアプリケーションで減り幅を測っておくことができます。</p>
<p>2 つ目は、減った分の扱いです。ヒープが 14% 減ったからといって、コンテナのメモリ制限をそのまま 14% 削るのは早計でしょう。減り幅はオブジェクトの形で決まり、上の表のとおりクラスによってはゼロです。GC の回数が減る効果は、ヒープを小さくすると相殺されます。まず現行の設定で GC ログを見て、それから決めるのが順当です。</p>
<p>3 つ目は、戻す手段です。何か問題が起きたら <code>-XX:-UseCompactObjectHeaders</code> で従来のレイアウトに戻せます。ただし Java 27 のリリースノートは、このオプションを将来非推奨にして削除する計画だと書いています。恒久的なオプションではなく、問題が発生した際に原因を調べるための暫定的なオプションです。</p>
<h2 id="おわりに">おわりに</h2><p>JEP 534 は、Java 27 にバージョンアップするだけで有効になる変更です。</p>
<p>サンプルの HashMap では減り幅は 14% でしたが、Integer や String が大半を占めるヒープなら数字はもっと小さくなります。この機能は Java 25 から試せるので、まず自分のアプリケーションで測ってみることをお勧めします。</p>
<p>この記事で動かしたサンプルコードは GitHub で公開しています。</p>
]]></content>
    <summary type="html">Java 27 で JEP 534 により Compact Object Headers がデフォルトで有効になり、オブジェクトヘッダが 12 バイトから 8 バイトに縮みました。ヘッダの中身、小さくなるオブジェクトとならないオブジェクト、ヒープ使用量の実測、移行時に確かめることを整理します。</summary>
    <category term="Programming" scheme="https://future-architect.github.io/categories/Programming/"/>
    <category term="GC" scheme="https://future-architect.github.io/tags/GC/"/>
    <category term="JEP" scheme="https://future-architect.github.io/tags/JEP/"/>
    <category term="Java" scheme="https://future-architect.github.io/tags/Java/"/>
    <category term="Java27" scheme="https://future-architect.github.io/tags/Java27/"/>
  </entry>
  <entry>
    <title>Java 26：final を本当に final にする準備（JEP 500）</title>
    <link href="https://future-architect.github.io/articles/20260930b/"/>
    <id>https://future-architect.github.io/articles/20260930b/</id>
    <published>2026-09-29T15:00:01.000Z</published>
    <updated>2026-09-29T15:00:01.000Z</updated>
    <author><name>武田大輝</name></author>
    <content type="html"><![CDATA[<img fetchpriority="high" src="/images/2026/20260930b/top.jpg" alt="" width="600" height="395">

<h2 id="はじめに">はじめに</h2><p>Java連載2026 の1本目です。</p>
<p>Java 27 は 2026年9月15日にリリースされました。この記事では Java 27 本体に入った JEP ではなく、半年前の Java 26 で入った JEP 500: Prepare to Make Final Mean Final を取り上げます。直訳すると「final が final を意味するようにする準備」です。final は「変更できない」を表す修飾子だったはずで、それをあらためて final にするとはどういうことでしょうか。</p>
<p>このテーマを選んだ理由は、この JEP が我々のアプリケーションコードにも直接関係することが多いからです。private final なフィールドをリフレクションで差し替えるテストは、今もよく残っています。Spring の <code>ReflectionTestUtils.setField</code> や、それを自作したユーティリティです。生成 AI にテストを書かせても、この形は出てきます。そのコードが Java 26 以降では警告を出すようになりました。</p>
<h2 id="final-は-final-ではなかった">final は final ではなかった</h2><p>例として、次のコードを実行します。名前を持つだけのクラスと、それをリフレクションで書き換える main です。</p>
<div class="code-block"><figure class="highlight java"><input type="checkbox" id="code-wrap-syio82-1" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-syio82-1" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="keyword">import</span> java.lang.reflect.Field;</span><br><span class="line"></span><br><span class="line"><span class="keyword">class</span> <span class="title class_">Person</span> &#123;</span><br><span class="line">  <span class="keyword">private</span> <span class="keyword">final</span> String name;</span><br><span class="line"></span><br><span class="line">  Person(String name) &#123;</span><br><span class="line">    <span class="built_in">this</span>.name = name;</span><br><span class="line">  &#125;</span><br><span class="line"></span><br><span class="line">  <span class="meta">@Override</span></span><br><span class="line">  <span class="keyword">public</span> String <span class="title function_">toString</span><span class="params">()</span> &#123;</span><br><span class="line">    <span class="keyword">return</span> <span class="string">&quot;Person&#123;name=&#x27;&quot;</span> + name + <span class="string">&quot;&#x27;&#125;&quot;</span>;</span><br><span class="line">  &#125;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="keyword">void</span> <span class="title function_">main</span><span class="params">()</span> <span class="keyword">throws</span> Exception &#123;</span><br><span class="line">  <span class="type">Person</span> <span class="variable">p</span> <span class="operator">=</span> <span class="keyword">new</span> <span class="title class_">Person</span>(<span class="string">&quot;Alice&quot;</span>);</span><br><span class="line">  <span class="type">Field</span> <span class="variable">f</span> <span class="operator">=</span> Person.class.getDeclaredField(<span class="string">&quot;name&quot;</span>);</span><br><span class="line">  f.setAccessible(<span class="literal">true</span>);</span><br><span class="line">  f.set(p, <span class="string">&quot;Bob&quot;</span>);</span><br><span class="line">  IO.println(p);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure></div>

<p>Java 25 までは、警告が出ません。</p>
<figure class="highlight text"><table><tr><td class="code"><pre><span class="line">Person&#123;name=&#x27;Bob&#x27;&#125;</span><br></pre></td></tr></table></figure>

<p>final と書いたフィールドが Bob に書き換わっています。同じコードを Java 27 で実行すると次のようになります。</p>
<div class="code-block"><figure class="highlight text"><input type="checkbox" id="code-wrap-syio82-2" class="code-wrap-input" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-syio82-2" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line">WARNING: Final field name in class FieldSetDemo$Person has been mutated reflectively by class FieldSetDemo in unnamed module @ca263c2 (file:/path/to/FieldSetDemo.java)</span><br><span class="line">WARNING: Use --enable-final-field-mutation=ALL-UNNAMED to avoid a warning</span><br><span class="line">WARNING: Mutating final fields will be blocked in a future release unless final field mutation is enabled</span><br><span class="line">Person&#123;name=&#x27;Bob&#x27;&#125;</span><br></pre></td></tr></table></figure></div>

<p>Java 27 でも書き換えは成功しています。ただし、将来のリリースではブロックされると予告されました。</p>
<p>setAccessible(true) を経由した final フィールドの書き換えは、2004年の JDK 5 から許されてきました。20年もの間、final は「通常の Java コードからは変更できない」という意味でしかなかったわけです。</p>
<p>なぜそんな穴が開いていたのでしょうか。理由はシリアライズです。ObjectInputStream は、Serializable なクラスのオブジェクトをストリームから復元するとき、コンストラクタを通さずにフィールドへ値を書き込む必要があります。final フィールドもその対象です。この用途のために開けた穴が、誰からでも使える形で公開されました。DI コンテナ、モックライブラリ、JSON ライブラリがそこを通って final フィールドをセットするようになり、今日に至ります。</p>
<h2 id="なぜ今になってブロックするのか">なぜ今になってブロックするのか</h2><p>JEP 500 は、OpenJDK が「Integrity by Default」と呼ぶ一連の取り組みの一部です。わかりやすく言うと、言語や JVM が保証しているはずの前提を、ライブラリが抜け道から破れる状態をなくしていく方針を指します。Java 21 の JEP 451 はエージェントの動的ロードに警告を付け、Java 23 と 24 の JEP 471 と JEP 498 は <code>sun.misc.Unsafe</code> のメモリアクセスを非推奨にして警告を付け、Java 24 の JEP 472 は JNI の利用に同じ扱いをしました。どれもアプローチは同じです。まずデフォルトで警告し、数リリース後にデフォルトで拒否し、明示的なフラグでだけ許す。JEP 500 は、これを final フィールドに適用した一段階目です。</p>
<p>リフレクションによる final の変更をブロックする動機は2つあります。</p>
<p>1つは、コードを読む側の推論です。final と書かれたフィールドを見た開発者は、コンストラクタを抜けた後は値が変わらないと考えて読みます。クラスパス上のどこかのライブラリが書き換えられる状態では、その前提は「たぶん変わらない」でしかありません。Java メモリモデルが final フィールドに与えている安全な公開の保証も、構築後に書き換えないことが前提です。</p>
<p>もう1つは JVM の最適化です。JIT コンパイラは、変わらないと確信できる値を定数としてコンパイル結果に埋め込めます（定数畳み込み）。HotSpot は現在、static final や record のフィールドは信頼していますが、record 以外の final なインスタンスフィールドは信頼していません。Field.set で書き換えられうるからです。書き換えがデフォルトで拒否されれば、この制限を外せます。</p>
<p>record のフィールドは、Java 16 で正式導入された時点からリフレクションでも書き換えられませんでした。JEP 500 は、通常のクラスの final フィールドを record と同じような扱いにするための変更です。</p>
<h2 id="何が警告され、何が例外なのか">何が警告され、何が例外なのか</h2><p>final フィールドなら何でも警告が出るわけではありません。警告すら出ずに、以前から例外になる対象もあります。Java 27 で試した結果を表にまとめます。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 書き換える対象のフィールド / Java 27 での挙動"><table>
<thead>
<tr>
<th>書き換える対象のフィールド</th>
<th>Java 27 での挙動</th>
</tr>
</thead>
<tbody><tr>
<td>final なインスタンスフィールド（record 以外）</td>
<td>警告：書き換えは成功する（将来は IllegalAccessException）</td>
</tr>
<tr>
<td>record のフィールド</td>
<td>例外：IllegalAccessException</td>
</tr>
<tr>
<td>final な static フィールド</td>
<td>例外：IllegalAccessException</td>
</tr>
</tbody></table></div>
<p>書き換えの方法は、Core Reflection の Field.set でも MethodHandles.Lookup.unreflectSetter でも扱いが同じです。後者は警告の文言が「has been unreflected for mutation」に変わり、書き換えた時点ではなくメソッドハンドルを取得した時点で出ます。</p>
<p>警告は書き換えた側のモジュールごとに一度だけ出ます。書き換える先のフィールドが違っても、書き換える側のクラスが違っても、同じモジュールからなら二度目以降は表示されません。</p>
<p>この挙動は <code>java</code> コマンドの <code>--illegal-final-field-mutation</code> オプションで切り替えられます。</p>
<ul>
<li><code>warn</code>: デフォルト。書き換えは成功し、モジュールごとに一度警告する</li>
<li><code>debug</code>: 毎回警告し、スタックトレースも付ける</li>
<li><code>deny</code>: IllegalAccessException を投げる（将来のデフォルト）</li>
<li><code>allow</code>: 警告などを出さず許可する（将来削除されるオプション）</li>
</ul>
<h2 id="警告がでるのは自分のコードとは限らない">警告がでるのは自分のコードとは限らない</h2><p>表示される警告は、自分で書いたリフレクションから出るとは限りません。多くの場合はフレームワークやライブラリといった別の場所から来ます。</p>
<p>さきほどの Person クラスを Gson 2.14.0 で JSON から復元してみます。</p>
<div class="code-block"><figure class="highlight java"><input type="checkbox" id="code-wrap-syio82-3" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-syio82-3" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="keyword">void</span> <span class="title function_">main</span><span class="params">()</span> &#123;</span><br><span class="line">  <span class="type">Person</span> <span class="variable">p</span> <span class="operator">=</span> <span class="keyword">new</span> <span class="title class_">Gson</span>().fromJson(<span class="string">&quot;&#123;\&quot;name\&quot;:\&quot;Alice\&quot;&#125;&quot;</span>, Person.class);</span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure></div>

<div class="code-block"><figure class="highlight text"><input type="checkbox" id="code-wrap-syio82-4" class="code-wrap-input" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-syio82-4" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line">WARNING: Final field name in class GsonDemo$Person has been mutated reflectively by class com.google.gson.internal.bind.ReflectiveTypeAdapterFactory$2 in unnamed module @e73f9ac (file:/path/to/gson.jar)</span><br></pre></td></tr></table></figure></div>

<p>書き換えたのは Gson の内部クラスです。Jackson 2.22.2 も同じです。引数なしコンストラクタとゲッタを持ち、セッタと @JsonCreator のどちらも持たないクラスなら、やはり警告が出ます。自分のコードに Field や setAccessible は一文字も出てきません。</p>
<p><code>--illegal-final-field-mutation=deny</code> を付けると、両方とも復元に失敗します。Jackson は <code>unnamed module is not allowed to mutate final fields</code> と原因を書いた JsonMappingException を投げますが、Gson は <code>Unexpected IllegalAccessException occurred</code> と、ReflectionAccessFilter の設定を疑うメッセージを出します。ライブラリ側がまだこの例外を想定していないと、原因にたどり着くまでに一手間かかります。</p>
<p>Jackson は3系で方針を変えました。<code>tools.jackson.core:jackson-databind:3.2.2</code> で同じクラスを復元すると、警告は出ません。MapperFeature.ALLOW_FINAL_FIELDS_AS_MUTATORS のデフォルトが false になり、final フィールドへ書き込まなくなったからです。ただし FAIL_ON_UNKNOWN_PROPERTIES のデフォルトも false です。例外は投げられず、name は null のまま返ります。警告が消えたからといって、対処できたわけではありません。</p>
<h2 id="どう対処すべきか">どう対処すべきか</h2><p>警告を消す手段は3つあります。良いほうから順に、書き換えをやめる、フラグで許可する、警告だけ非表示にする、と並びます。</p>
<p>一番良いのは、書き換えをやめることです。Jackson なら @JsonCreator を付けたコンストラクタか record にすれば、フィールドへの直接書き込みは起きません。テストで final フィールドを差し替えているなら、コンストラクタから依存を渡す形に直します。JEP 自身も、DI やテストのフレームワークに対して final フィールドを書き換えない設計への見直しを求めています。</p>
<p>2つ目は、フラグでの許可です。ライブラリ側の対応を待つ間は、<code>--enable-final-field-mutation</code> で書き換えを許可します。</p>
<div class="code-block"><figure class="highlight bash"><input type="checkbox" id="code-wrap-syio82-5" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-syio82-5" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line">java --enable-final-field-mutation=ALL-UNNAMED -jar app.jar</span><br></pre></td></tr></table></figure></div>

<p>指定するのは、書き換えられるクラスのモジュールではなく、書き換える側のモジュールです。クラスパスに置いた jar はモジュール名を持たず、まとめて1つの無名モジュールに入るため、通常は ALL-UNNAMED を指定することになります。<code>com.google.gson</code> のようなモジュール名で書けるのは、ライブラリをモジュールパスに置いた場合だけです。コマンドラインのほかに、環境変数 JDK_JAVA_OPTIONS や実行可能 JAR のマニフェストの Enable-Final-Field-Mutation 属性でも指定できます。</p>
<p>なお、Serializable なクラスについては、開発者が何かする必要はありません。JDK のシリアライズと同じ手段が jdk.unsupported モジュールの ReflectionFactory を通してライブラリ向けに用意されており、ライブラリがそちらへ移行すればフラグなしで動きます。逆に言えば、Serializable でないクラスの final フィールドは、将来 JVM が不変だとみなしてよい対象です。</p>
<p>3つ目の、<code>--illegal-final-field-mutation=allow</code> で警告を非表示にするアプローチは、避けたほうがよいでしょう。このオプションは将来削除されると明記されていて、消えたときに一気に例外へ変わります。むしろ逆に、CI のテスト実行に <code>deny</code> を付けるほうに価値があります。将来のデフォルトを先取りして、どのライブラリがどこで落ちるかを今のうちに知っておけます。</p>
<h2 id="おわりに">おわりに</h2><p>ここまでみてきたようにリフレクションで final フィールドを差し替えるコードは、Java 27 では警告付きで通ります。いつ通らなくなるかは、JEP が「将来のリリース」としか書いていないので分かりません。ただ、Integrity by Default の先行例はどれも数リリースでデフォルトを切り替えてきました。</p>
<p>final を本当に final にするのは JVM の仕事ですが、その日に備えて final フィールドを書き換えないコードにしておくのは開発者の仕事です。まずは自分のアプリケーションで <code>debug</code> を付けて動かし、どこに警告がでるかを見るところから始めてみると良いでしょう。</p>
<p>この記事で動かしたサンプルコードは GitHub で公開しています。</p>
]]></content>
    <summary type="html">Java 26 で入った JEP 500 により、リフレクションで final フィールドを書き換えると警告が出るようになりました。背景の Integrity by Default、警告と例外の違い、Gson・Jackson での挙動、対処方法を整理します。</summary>
    <category term="Programming" scheme="https://future-architect.github.io/categories/Programming/"/>
    <category term="JEP" scheme="https://future-architect.github.io/tags/JEP/"/>
    <category term="Java" scheme="https://future-architect.github.io/tags/Java/"/>
    <category term="Java26" scheme="https://future-architect.github.io/tags/Java26/"/>
    <category term="リフレクション" scheme="https://future-architect.github.io/tags/%E3%83%AA%E3%83%95%E3%83%AC%E3%82%AF%E3%82%B7%E3%83%A7%E3%83%B3/"/>
  </entry>
  <entry>
    <title>Java連載2026：Java 26／27リリース記念ブログ連載</title>
    <link href="https://future-architect.github.io/articles/20260930a/"/>
    <id>https://future-architect.github.io/articles/20260930a/</id>
    <published>2026-09-29T15:00:00.000Z</published>
    <updated>2026-09-29T15:00:00.000Z</updated>
    <author><name>admin</name></author>
    <content type="html"><![CDATA[<img fetchpriority="high" src="/images/2026/20260930a/top.jpg" alt="" width="600" height="395">

<h2 id="はじめに">はじめに</h2><p>2026年9月にJava 27がリリースされました。</p>
<p>これを記念して、今年もフューチャー技術ブログでJava連載を開催します。昨年の Java25リリース記念ブログ連載 に続く2回目です。</p>
<p>今年は2026年3月にリリースされたJava 26と、9月のJava 27の2バージョンをまとめて扱います。</p>
<h2 id="昨今のJavaのトレンド">昨今のJavaのトレンド</h2><h3 id="AIを使う時代でもJavaは残るのか">AIを使う時代でもJavaは残るのか</h3><p>コーディングエージェントが当たり前になり、「どの言語で書くか」をAIに任せる場面も増えてきました。そうなると、記述量が多いと言われがちなJavaは選ばれにくくなるのでは、と感じる方もいるかもしれません。</p>
<p>ところが実際には逆の動きが見えています。Azulの「2026 State of Java Survey &amp; Report」では、AI機能をJavaで実装している組織は62%と、前年の50%から増えました。LangChain4jやSpring AIのようにLLMを呼び出すライブラリがそろい、既存の業務システムにAI機能を組み込む言語としてJavaが使われています。</p>
<ul>
<li>Azul 2026 State of Java Survey Report（Business Wire）</li>
</ul>
<p>静的型付けでコンパイラが多くの誤りを止めてくれることは、AIが書いたコードを人がレビューする時代にはむしろ利点になります。型やテストという「機械が確かめられる手がかり」が多い言語ほど、エージェントに任せやすいからです。</p>
<h3 id="利用ランキングの動き">利用ランキングの動き</h3><p>TIOBE Indexでは、Javaは2026年9月時点で4位（7.54%）です。8月には3位のC++との差が0.37ポイントまで縮まり、順位が入れ替わる可能性が話題になりました。9月は差が1.13ポイントに開いたものの、長く続いた「Javaは下り坂」という見方とは違う動きです。</p>
<ul>
<li>TIOBE Index for September 2026（TechRepublic）</li>
</ul>
<p>言語そのものも、半年ごとのリリースで着実に変わり続けています。今回の連載でも、オブジェクトヘッダーの縮小やfinalの厳格化といったランタイムの深い部分から、HTTP&#x2F;3や耐量子暗号のTLSといった新しい標準への対応まで扱います。</p>
<h2 id="スケジュール">スケジュール</h2><div class="scroll" tabindex="0" role="region" aria-label="表 日付 / 執筆者 / タイトル"><table>
<thead>
<tr>
<th align="left">日付</th>
<th align="left">執筆者</th>
<th align="left">タイトル</th>
</tr>
</thead>
<tbody><tr>
<td align="left"><img src="/images/2026/20260930b/thumbnail.jpg" alt="" width="72" height="48" loading="lazy"> 9&#x2F;30（水）</td>
<td align="left">武田大輝</td>
<td align="left">Java 26：final を本当に final にする準備（JEP 500）</td>
</tr>
<tr>
<td align="left"><img src="/images/2026/20261002a/thumbnail.jpg" alt="" width="72" height="48" loading="lazy"> 10&#x2F;2（金）</td>
<td align="left">武田大輝</td>
<td align="left">Java 27：オブジェクトヘッダが 8 バイトになる（JEP 534）</td>
</tr>
<tr>
<td align="left"><img src="/images/2026/20261005a/thumbnail.jpg" alt="" width="72" height="48" loading="lazy"> 10&#x2F;5（月）</td>
<td align="left">前川喜洋</td>
<td align="left">Java 26 &#x2F; Java 27 リリースまとめ</td>
</tr>
</tbody></table></div>
<h2 id="さいごに">さいごに</h2><p>AIがコードを書く時代になっても、フューチャーで最も使われている言語はJavaです。言語の進化を追い続けることは、AIに任せたコードを正しく読み、判断するための土台にもなります。</p>
<p>連載を通して、最新のJavaの世界を少しでも紹介できたらと思います。</p>
]]></content>
    <summary type="html">Java 27のリリースを記念して、Java 26／27をテーマにしたブログリレーを開催します。AI時代のJavaの立ち位置と、公開スケジュールを紹介します。</summary>
    <category term="Programming" scheme="https://future-architect.github.io/categories/Programming/"/>
    <category term="Java" scheme="https://future-architect.github.io/tags/Java/"/>
    <category term="Java26" scheme="https://future-architect.github.io/tags/Java26/"/>
    <category term="Java27" scheme="https://future-architect.github.io/tags/Java27/"/>
    <category term="インデックス" scheme="https://future-architect.github.io/tags/%E3%82%A4%E3%83%B3%E3%83%87%E3%83%83%E3%82%AF%E3%82%B9/"/>
  </entry>
  <entry>
    <title>知らない業界の下調べを AI に任せたら、肝心の項目がごっそり抜けていた</title>
    <link href="https://future-architect.github.io/articles/20260929a/"/>
    <id>https://future-architect.github.io/articles/20260929a/</id>
    <published>2026-09-28T15:00:00.000Z</published>
    <updated>2026-09-28T15:00:00.000Z</updated>
    <author><name>老田築</name></author>
    <content type="html"><![CDATA[<img fetchpriority="high" src="/images/2026/20260929a/top.jpg" alt="" width="1024" height="572" class="bordered">

<h2 id="はじめに">はじめに</h2><p>老田です。</p>
<p>新しいプロジェクトに入ると、まずその業界のことが何も分かりません。せめて取っ掛かりぐらいは AI に手伝ってもらえないかと思って、業界の下調べをやらせる手順を作ってみました。</p>
<p>速さは期待どおりでした。しかし困ったことに中身は参考にならないレベルでした。1 回目に返ってきたものは体裁が整っていて、読むと分かった気になるのに、肝心の項目がまるごと抜けていました。しかも未経験分野の場合は間違っていることや抜けていることにしばらく気づきませんでした。</p>
<p>今回は何が壊れたのか、どう縛ったら直ったのか、人が何を見ればいいのかを書きたいと思います。</p>
<h2 id="試した対象">試した対象</h2><p>サンプルとして 2 つのドメインを対象にしました。</p>
<ul>
<li>地形図の図式(未経験)</li>
<li>ロボットのティーチング(経験有)</li>
</ul>
<p>知らない業界だけで試すと、出てきたものが正しいのか自分で判断できません。分かっている業界を並べておくと、AI の出力を自分の知識と突き合わせられます。実際、後者では「現場でその言い方はしないな」という違和感からいくつか粗が見つかりました。</p>
<p>例えばロボットティーチングの分野では各メーカーごとに使われている単語が違ったりします。それらが別の単語として独立した意味を持ってしまってるケースがありました。</p>
<p>また、ISO（国際標準化機構）の版ごとに変化があった箇所で古いデータを参照してることで、規格・規則が現在時点に即していないものを提示されることもありました。</p>
<p>最初に渡した指示はこれだけです。</p>
<ul>
<li>ドメインの地図を作ること。個別の規則の実装には使わないこと。</li>
<li>根拠は 1 次情報に限ること。</li>
<li>分量は 1 ファイル 1500 〜 3000 字。</li>
</ul>
<p>使った環境です。モデルは入れ替わりが早いので、いつ時点の話かを添えておきます。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 項目 / 内容"><table>
<thead>
<tr>
<th>項目</th>
<th>内容</th>
</tr>
</thead>
<tbody><tr>
<td>実行時期</td>
<td>2026 年 9 月</td>
</tr>
<tr>
<td>エージェント</td>
<td>Claude Code</td>
</tr>
<tr>
<td>モデル</td>
<td>Claude Opus 5（1M コンテキスト）。モデル ID は <code>claude-opus-5[1m]</code></td>
</tr>
<tr>
<td>推論の強さの設定</td>
<td>xhigh</td>
</tr>
</tbody></table></div>
<p>以下の壊れ方は、この組み合わせで観察したものです。別のエージェントや別のモデルでも同じように壊れるかは確かめていません。</p>
<h2 id="字数で縛ったら、項目の数が減った">字数で縛ったら、項目の数が減った</h2><p>返ってきた成果物には、出典表があり、用語が 15 語定義され、未解決の疑問が並んでいました。形は整っています。</p>
<p>しかし足りないことに気づいたのは、それを持って人に質問しようとしたときでした。その仕事がどの工程に当たるのかが書かれておらず、成果物が何で構成されるのかも書いていません。登場するものの一覧もありません。</p>
<p>工程・構成・オブジェクト。業界を知るときに最初に押さえたい 3 つが、そろって落ちていました。</p>
<p>犯人は「1500 〜 3000 字」です。AI はこの制約を、各項目の説明を短くするのではなく、挙げる項目の数を減らして満たしていました。</p>
<p>人に「短くまとめて」と言えば、たいてい説明のほうを削ります。項目を落とすと網羅性が壊れると知っているからです。おそらく AI はそこを区別していないのでしょう。数字ひとつで雑に縛ると、どこを削るかは向こうが決めます。</p>
<h2 id="人の調査では起きない壊れ方があった">人の調査では起きない壊れ方があった</h2><p>直しながら見つけたものを並べます。</p>
<p>出典がなくても文章が書けてしまう問題がありました。人は知らないことを書けませんが、AI は書けます。しかも書きぶりが自然なので、出典があるかどうかを文体から見分けづらいです。</p>
<p>「見つけた」と「読んだ」が混ざります。検索結果で存在を知っただけの規格を、中身を確認したかのように書きます。有料で本文が読めない規格でも、表題から想像した内容を書いていました。</p>
<p>一番厄介だと思ったのは、「調べたが見つからなかった・分からなかった」を書かないことです。実務ではこの空白が重要な情報源である場合も少なくないと思います。</p>
<h2 id="字数ではなく、書くべき節で縛る">字数ではなく、書くべき節で縛る</h2><p>字数の指定をやめて、必須の節のリストに変えました。</p>
<ol>
<li>目的と使い先</li>
<li>範囲・範囲外・隣接領域</li>
<li>出典表</li>
<li>ドメインの輪郭</li>
<li>工程の地図</li>
<li>成果物の構成</li>
<li>構成オブジェクトの一覧</li>
<li>主体と役割</li>
<li>用語集</li>
<li>突き合わせ</li>
<li>未解決の疑問</li>
<li>次に深掘りすべき分野</li>
<li>更新履歴</li>
</ol>
<p>そのうえで「浅くするのは各項目の説明であって、挙げる項目の数ではありません」と書き添え、各項目 1 〜 3 行、オブジェクト 20 〜 40 個、用語 30 〜 50 語という目安を付けました。</p>
<p>これで落ちなくなりました。2 回目は工程が 5 フェーズ、オブジェクトが 32 個、用語が 44 語。全体の分量は 2834 字から 12049 字へ増えましたが、1 項目あたりは 1 〜 2 行のままです。</p>
<p>ひとつコツがあって、埋まらなかった節を削らせてはいけません。「調べたが分からなかった」と書き残させます。削ってよいことにすると、また消えます。</p>
<h2 id="出典を-3-段に分け、確認状況を列に持たせる">出典を 3 段に分け、確認状況を列に持たせる</h2><p>情報源の格を先に決めました。</p>
<ul>
<li>1 次情報。規格の原本、法令、業界団体が自ら出した規定や用語集。根拠にできるのはこれだけ。</li>
<li>2 次情報。解説記事、書籍の概説。1 次情報へたどる手掛かりにはするが、根拠にはしない。</li>
<li>根拠にしないもの。出典のないまとめ記事、SNS、そして AI 自身の出力。</li>
</ul>
<p>最後の 1 行は地味ですが要ります。前のステップで自分が書いたことを、次のステップで既知の事実として扱うのを止められます。</p>
<p>出典表には確認状況の列を足しました。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 ID / 発行元 / 正式名称 / 版・発行日 / 所在 / 取得日 / 確認状況"><table>
<thead>
<tr>
<th>ID</th>
<th>発行元</th>
<th>正式名称</th>
<th>版・発行日</th>
<th>所在</th>
<th>取得日</th>
<th>確認状況</th>
</tr>
</thead>
<tbody><tr>
<td>E1</td>
<td>業界団体</td>
<td>用語集</td>
<td>版の表示なし</td>
<td>URL</td>
<td>2026-09-09</td>
<td>全量読了</td>
</tr>
<tr>
<td>E2</td>
<td>規格協会</td>
<td>規格の表題</td>
<td>2013 年版</td>
<td>URL</td>
<td>2026-09-09</td>
<td>表題のみ確認（本文は有料で未読）</td>
</tr>
</tbody></table></div>
<p>この列があるだけで読み方が変わります。「表題のみ確認」の行を根拠にした記述に断定は書けない、というルールが勝手に効くからです。取得日も必須にしました。ウェブの文書は改訂されるので、いつ時点かが分からないと再検証できません。</p>
<h2 id="情報源を減らしたら、質が上がった">情報源を減らしたら、質が上がった</h2><p>ウェブで公開されていて第三者が URL から開けるものだけに絞りました。ローカルにあるメモや MCP からアクセスできる社内知識が混ざっていると、どこまでが公開情報で裏づけられるのか分からない文書になります。</p>
<p>信憑性の低い 2 次・3 次情報は使わず、1 次情報を使うように制限しました。解説記事を見つけると、そこに書いてあることを事実として書き、又聞きのような情報が成果物に載ります。</p>
<p>ロボットティーチングではどのような手順や作法でロボットにティーチングするかの公開資料がゼロでした。今回の地形図の図式でも同様に、何を描いて何を省くかの判断の作法が分かりませんでした。</p>
<p>地図を例にすると、それが調査不足ではないことも確かめられました。</p>
<ul>
<li>図式は記号の大きさ・線の太さ・文字まで定めているのに、何を描いて何を省くかは定めていない。</li>
<li>図式は明治 13 年式から平成 25 年式まで 8 版を重ねているが、どの版も表現の規則であって取捨選択の規則ではない。</li>
<li>公開されている地図記号の一覧は 11 の分類に分かれているが、どれも何を描くかの分類であって、何を省くかの区分はない。</li>
</ul>
<p>ここまで来ると「この先は人に聞くしかない」が根拠付きで言えます。キャッチアップで最初に手に入るのは知識ではなく、知識の境界線でした。境界線があると、質問の形が変わります。「教えてください」ではなく「ここまで調べて、ここが分からない」になります。聞かれる側の負担がだいぶ違うはずです。</p>
<h2 id="人が見るところ">人が見るところ</h2><p>そのまま信じるわけにはいかないので、確認する箇所を決めました。節がそろっているか、出典表に空欄がないかといった形式の点検は AI に回せるので、下の折りたたみに指示としてまとめました。書いたセッションとは別のセッションで回します。ここに挙げるのは、人が見たほうがよい 4 つです。</p>
<p>出典の URL を開いて数値が合うかを確かめます。これは必ずやります。1 か所ずれていたら全体を疑います。</p>
<p>「全量」の主張に数えられる根拠があるかを見ます。「図式は何度か改訂されています」ではなく「図式は明治 13 年式から平成 25 年式まで 8 版ある」と書けているかどうかです。数えられない形のものは、網羅ではなく印象です。</p>
<p>確認状況が「表題のみ」の行に、断定が乗っていないかを見ます。</p>
<p>最後に、導出の計算を追います。ここは AI の得意分野だと思います。地図記号の一覧を分類ごとに数えさせたら、11 分類の合計が 122 個でした。ページのどこにも総数は書かれていません。あわせて、図式の版を並べたページでは、系譜に載っていない「昭和 42 年式」が記号数の説明にだけ出てきます。人が見るには件数が多いうえ、上記のような違いは目で見ていたら気づきにくいです。</p>
<h2 id="向き不向き">向き不向き</h2><p>データの突き合わせに関してはAI が人より速くて正確です。団体のサイトを片端から当たって全量を数えます。表から関係式を導いて例外を見つけます。複数の資料で同じ語が別の意味になっていないか照合します。どれも人の手だと時間がかかるうえ、ミスも散見されます。AI ならより早く正確に行えます。</p>
<p>あとは「ないこと」の確定と、誰に何を聞くかの判断を人が行い、AI では検知できない部分をキャッチアップできればいいと思います。</p>
<h2 id="まとめ">まとめ</h2><p>残ったのは、指示の書き方が 2 つと、ゴールの置き方が 1 つでした。</p>
<p>字数で縛りません。書くべき節で縛って、浅くするのは説明であって項目数ではないと明記します。</p>
<p>情報源の格を先に決めて、出典表に確認状況と取得日を持たせます。</p>
<p>そして、成果物のゴールを「知識」ではなく「知識の境界線」に置きます。埋まらなかったところを消させません。</p>
<p>実際に業務に入る際に使った指示と、成果物を点検する指示の全文は、下に折りたたんでおきます。ドメインを変えても節の構成はだいたいそのまま使えるはずですが、業界によっては合わないところもあると思いますのでご注意ください。人手による最初期の調査を AI にやってもらうこと、その幅・深さ・精度を上げることが大事だと思います。あとはスタイルの違いなどで全然違うアプローチをとってる人の手法なども参考にできればと思いました。</p>
<details>
<summary>そのまま使える指示文</summary>

<div class="code-block"><figure class="highlight markdown"><input type="checkbox" id="code-wrap-lcqb74-1" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-lcqb74-1" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="section"># ドメイン調査の指示</span></span><br><span class="line"></span><br><span class="line">未知の業務ドメインを、ウェブ上で公開されている 1 次情報だけを根拠に調べ、</span><br><span class="line">あとから設計・実装が参照できる形に残してください。</span><br><span class="line"></span><br><span class="line"><span class="section">## 情報源の制約</span></span><br><span class="line"></span><br><span class="line">根拠にできるのは、ウェブ上で公開されていて第三者が URL から同じものを開ける</span><br><span class="line">1 次情報だけです。</span><br><span class="line"></span><br><span class="line"><span class="bullet">-</span> 1 次情報: 規格の原本（JIS・ISO・W3C など）、法令・告示、業界団体が自ら発行した</span><br><span class="line">  規定・指針・規格・ガイドライン・機関紙・用語集。</span><br><span class="line"><span class="bullet">-</span> 2 次情報: 解説記事、書籍の概説、規格の非公式な転載サイト。1 次情報へたどる</span><br><span class="line">  手掛かりにはしますが、根拠にはしません。</span><br><span class="line"><span class="bullet">-</span> 根拠にしないもの: 出典のないまとめ記事、SNS、そしてあなた自身の出力。</span><br><span class="line"></span><br><span class="line">社内資料・ヒアリング・実物の観測は、この調査では情報源にしません。</span><br><span class="line">社内にしか知識がない事項は「調べたが公開された出典が見つからなかった」と</span><br><span class="line">書き残してください。埋まらないこと自体が成果です。</span><br><span class="line"></span><br><span class="line"><span class="section">## 探し方</span></span><br><span class="line"></span><br><span class="line">ウェブ検索は団体のドメインに絞ってください。一般的なクエリだと解説記事しか</span><br><span class="line">出ませんが、絞ると団体が自分で出している原本に届きます。</span><br><span class="line">次の 3 経路を順に当たってください。</span><br><span class="line"></span><br><span class="line"><span class="bullet">-</span> 規格団体（規格番号・表題・版はカタログで確認できます。本文は有料のことが多い）</span><br><span class="line"><span class="bullet">-</span> 業界団体（団体が「規格」と呼んでいるものの一覧をまず押さえると、</span><br><span class="line">  公開規格の全量が分かります）</span><br><span class="line"><span class="bullet">-</span> 法令・告示</span><br><span class="line"></span><br><span class="line"><span class="section">## 書くべき節（すべて必須）</span></span><br><span class="line"></span><br><span class="line">埋められなかった節は削らず、「調べたが分からなかった」と書き残してください。</span><br><span class="line"></span><br><span class="line"><span class="bullet">1.</span> 目的と使い先</span><br><span class="line"><span class="bullet">2.</span> 範囲・範囲外・隣接領域</span><br><span class="line"><span class="bullet">3.</span> 出典表</span><br><span class="line"><span class="bullet">4.</span> ドメインの輪郭（このドメインが何と何の重なりでできているかを層に分け、</span><br><span class="line">   層ごとにどこまで公開規格があるかを書く）</span><br><span class="line"><span class="bullet">5.</span> 工程の地図（対象の作業が、成果物が世に出るまでのどのフェーズにあるか。</span><br><span class="line">   前後のフェーズ、受け渡すもの、締切と後戻りの可否）</span><br><span class="line"><span class="bullet">6.</span> 成果物の構成（階層と座標系。階層の各段に種類があるならその種類も）</span><br><span class="line"><span class="bullet">7.</span> 構成オブジェクトの一覧（名前・役割・特性・出典の表。目安 20〜40 個）</span><br><span class="line"><span class="bullet">8.</span> 主体と役割</span><br><span class="line"><span class="bullet">9.</span> 用語集（目安 30〜50 語。出典の性質で分けて並べる）</span><br><span class="line"><span class="bullet">10.</span> 突き合わせ（複数の出典の一致・矛盾・判定不能。あわせて用語の衝突を必ず確認）</span><br><span class="line"><span class="bullet">11.</span> 未解決の疑問（優先順に。なぜ分からなかったかを添える）</span><br><span class="line"><span class="bullet">12.</span> 次に深掘りすべき分野</span><br><span class="line"><span class="bullet">13.</span> 更新履歴</span><br><span class="line"></span><br><span class="line"><span class="section">## 分量</span></span><br><span class="line"></span><br><span class="line">字数では縛りません。上の節がそろったかで判定してください。</span><br><span class="line">浅くするのは各項目の説明であって、挙げる項目の数ではありません。</span><br><span class="line">やむを得ず分量を減らす場合は各項目は 1〜3 行に収めてください。</span><br><span class="line"></span><br><span class="line"><span class="section">## 出典の書式</span></span><br><span class="line"></span><br><span class="line">出典表は本文より先に作ってください。</span><br><span class="line"></span><br><span class="line">| ID | 発行元 | 正式名称 | 版・発行日 | 所在 | 取得日 | 確認状況 |</span><br><span class="line"></span><br><span class="line"><span class="bullet">-</span> 取得日を必ず書きます。ウェブの文書は改訂されるためです。</span><br><span class="line"><span class="bullet">-</span> 確認状況は「原本を通読 / 該当箇所のみ読了 / 表題のみ確認」の 3 段で書きます。</span><br><span class="line">  「規格に規定がある」と書けるのは本文を読んだときだけです。</span><br><span class="line"><span class="bullet">-</span> 版の表示がない文書は「版の表示なし」と書きます。空欄にしないでください。</span><br><span class="line"></span><br><span class="line"><span class="section">## 書き分け</span></span><br><span class="line"></span><br><span class="line">次の 3 つを別の節に隔離してください。同じ表・同じ箇条書きに混ぜないでください。</span><br><span class="line"></span><br><span class="line"><span class="bullet">-</span> 出典に書かれていること（末尾に出典 ID を添える）</span><br><span class="line"><span class="bullet">-</span> 導出（出典にはないが算術で導けること。計算を示す）</span><br><span class="line"><span class="bullet">-</span> 推定（根拠のある見込み。根拠と、その推定で説明できない点を添える）</span><br><span class="line"></span><br><span class="line"><span class="section">## 用語の衝突</span></span><br><span class="line"></span><br><span class="line">突き合わせでは値だけでなく用語も確認してください。</span><br><span class="line">同じ語が別の意味で使われていないか、別の語が同じものを指していないか。</span><br><span class="line">見つけたら、どちらかへ統一せず両方を残し、どの文脈でどちらの意味になるかを</span><br><span class="line">書いてください。</span><br></pre></td></tr></table></figure></div>

</details>

<details>
<summary>成果物を点検する指示</summary>

<p>成果物を書いたセッションでは実行しません。自分の出力を既知の事実として扱うため、見落としが素通りします。別のセッションを立てるか、成果物だけを読む新しいコンテキストのサブエージェントへ回してください。そのとき、リポジトリの他のファイルとドメインに関する資料を読ませないでください。</p>
<p>判定基準として 2 つのファイルを参照しています。手元に同じものがなければ、上の「そのまま使える指示文」を判定基準として読み替えてください。</p>
<div class="code-block"><figure class="highlight markdown"><input type="checkbox" id="code-wrap-lcqb74-2" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-lcqb74-2" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="section"># 調査の成果物を点検する指示</span></span><br><span class="line"></span><br><span class="line">次の成果物を点検してください。</span><br><span class="line"></span><br><span class="line"><span class="bullet">-</span> 成果物: <span class="code">`&lt;ファイルのパス&gt;`</span></span><br><span class="line"></span><br><span class="line"><span class="section">## 読んでよいもの</span></span><br><span class="line"></span><br><span class="line"><span class="bullet">-</span> 点検の対象である成果物。</span><br><span class="line"><span class="bullet">-</span> 判定基準として <span class="code">`.agents/skills/domain-research/SKILL.md`</span> と</span><br><span class="line">  <span class="code">`.agents/skills/domain-research/evidence.md`</span>。</span><br><span class="line"></span><br><span class="line">それ以外のリポジトリのファイルと、ドメインに関する資料は読まないでください。</span><br><span class="line">成果物に書かれていないことを補って解釈しないでください。書かれていないなら</span><br><span class="line">「書かれていない」と判定します。</span><br><span class="line"></span><br><span class="line"><span class="section">## 判定の出し方</span></span><br><span class="line"></span><br><span class="line"><span class="bullet">-</span> 項目ごとに 合格 / 要修正 / 判定不能 のいずれかを付けます。</span><br><span class="line"><span class="bullet">-</span> 要修正には該当箇所（節の名前か、本文からの引用）を必ず添えます。</span><br><span class="line"><span class="bullet">-</span> 判定不能は、成果物だけでは判定できないとき（基準の文書が読めない、環境が</span><br><span class="line">  足りない）に使います。要修正と混ぜないでください。</span><br><span class="line"><span class="bullet">-</span> 同じ箇所が複数の項目に当たるときは、最も根本的な 1 項目にだけ要修正として</span><br><span class="line">  計上し、他の項目では「項目 N と同じ箇所」と参照するにとどめます。同じ欠陥を</span><br><span class="line">  何度も数えないためです。</span><br><span class="line"><span class="bullet">-</span> 要修正には重大度を付けます。重大（成果物の使い方を誤らせる）、中（追記で</span><br><span class="line">  直る）、軽微（表記の差）の 3 段です。</span><br><span class="line"><span class="bullet">-</span> 最後に、要修正の件数と、その原因の数を 1 行でまとめます。</span><br><span class="line"></span><br><span class="line"><span class="section">## A. 書き分け</span></span><br><span class="line"></span><br><span class="line">最初に判定します。ここが崩れていると、以降の指摘の多くはここから派生します。</span><br><span class="line"></span><br><span class="line"><span class="bullet">1.</span> 出典に書かれたこと、導出、推定が別の節に隔離されているか。同じ表や同じ</span><br><span class="line">   箇条書きに混ざっていれば要修正。</span><br><span class="line"><span class="bullet">2.</span> 導出に、計算または推論の道筋が示されているか。結論だけになっていないか。</span><br><span class="line"><span class="bullet">3.</span> 推定に、根拠と、その推定では説明できない点の両方が添えられているか。</span><br><span class="line">   片方だけなら要修正。</span><br><span class="line"></span><br><span class="line"><span class="section">## B. 出典</span></span><br><span class="line"></span><br><span class="line"><span class="bullet">4.</span> 出典表が本文より前にあるか。</span><br><span class="line"><span class="bullet">5.</span> 出典表の各行に、発行元・正式名称・版・所在・取得日・確認状況がそろって</span><br><span class="line">   いるか。空欄があればその行を挙げる。</span><br><span class="line"><span class="bullet">6.</span> 版の欄が、版番号または発行日か、「版の表示なし」のいずれかになっているか。</span><br><span class="line">   どちらでもない説明文が入っていれば要修正。</span><br><span class="line"><span class="bullet">7.</span> 確認状況が「原本を通読／該当箇所のみ読了／表題のみ確認」の 3 段のいずれかで</span><br><span class="line">   書かれているか。</span><br><span class="line"><span class="bullet">8.</span> 確認状況の申告と、本文での使い方が整合しているか。本文が読めなかったと</span><br><span class="line">   書いてある出典に「原本を通読」が付いていないか。</span><br><span class="line"><span class="bullet">9.</span> 確認状況が「表題のみ確認」の出典を根拠にして、「規定がある」「〜と定めて</span><br><span class="line">   いる」と断定していないか。</span><br><span class="line"><span class="bullet">10.</span> 根拠にしないものが出典表に入っていないか。判定は evidence.md の</span><br><span class="line"><span class="code">    「1 次情報の判定」に従います。2 次情報（解説記事、書籍の概説、規格の非公式な</span></span><br><span class="line"><span class="code">    転載）を根拠に使っている箇所があれば挙げる。</span></span><br><span class="line"><span class="code">11. 出典 ID が添えられていない事実の記述がないか。あればすべて挙げる。節の</span></span><br><span class="line"><span class="code">    役割上どうしても書き手の判断になる記述（層の分け方など）は、項目 1 の隔離の</span></span><br><span class="line"><span class="code">    問題として扱い、ここでは重複して数えない。</span></span><br><span class="line"><span class="code"></span></span><br><span class="line"><span class="section">## C. 節の構成</span></span><br><span class="line"></span><br><span class="line"><span class="bullet">12.</span> SKILL.md の「概要調査で書く節」が定める 13 節がすべてあるか。ない節が</span><br><span class="line"><span class="code">    あれば節名を挙げる。</span></span><br><span class="line"><span class="code">13. 節名が SKILL.md の記載と一致しているか。役割は果たしているが名前が違う</span></span><br><span class="line"><span class="code">    だけなら、重大度は軽微。</span></span><br><span class="line"><span class="code">14. 各節が、SKILL.md がその節に求める要素を含んでいるか。少なくとも次を</span></span><br><span class="line"><span class="code">    確認する。</span></span><br><span class="line"><span class="code">    - 工程の地図に、前後のフェーズ、受け渡すもの、締切と後戻りの可否があるか。</span></span><br><span class="line"><span class="code">    - 成果物の構成に、階層と座標系の両方があるか。階層の各段に種類があるなら、</span></span><br><span class="line"><span class="code">      その種類があるか。</span></span><br><span class="line"><span class="code">    - 構成オブジェクトの一覧に、名前・役割・特性・出典の 4 つがそろっているか。</span></span><br><span class="line"><span class="code">    - 突き合わせに、一致・矛盾・判定不能の 3 つが分けて書かれているか。</span></span><br><span class="line"><span class="code">    - 未解決の疑問が優先順に並び、なぜ分からなかったかが添えられているか。</span></span><br><span class="line"><span class="code">    - 次に網羅調査すべき分野が 1 つだけ指名されているか。</span></span><br><span class="line"><span class="code">15. 項目数の目安を満たしているか。構成オブジェクトは 20〜40 個、用語集は</span></span><br><span class="line"><span class="code">    30〜50 語です。下回っていれば、何個・何語かを挙げる。</span></span><br><span class="line"><span class="code">16. 埋められなかった節が、削られずに「調べたが公開された出典が見つからなかった」</span></span><br><span class="line"><span class="code">    と書き残されているか。</span></span><br><span class="line"><span class="code"></span></span><br><span class="line"><span class="section">## D. 主張の強さ</span></span><br><span class="line"></span><br><span class="line"><span class="bullet">17.</span> 「全量」「すべて」「〜だけ」「N つあります」と書いている箇所に、数えられる</span><br><span class="line"><span class="code">    根拠があるか。根拠にした一覧が抜粋であれば要修正とし、その一覧の表題を</span></span><br><span class="line"><span class="code">    引用する。</span></span><br><span class="line"><span class="code">18. 数値に単位と適用条件（どの版か、どの時点か、どの適用範囲か）が添えられて</span></span><br><span class="line"><span class="code">    いるか。規格の箇条を指す番号は、規格の版が特定できる形になっているか。</span></span><br><span class="line"><span class="code">19. 「ない」「見つからなかった」と書いている箇所に、どこを探したかが添えられて</span></span><br><span class="line"><span class="code">    いるか。</span></span><br><span class="line"><span class="code"></span></span><br><span class="line"><span class="section">## E. 用語</span></span><br><span class="line"></span><br><span class="line"><span class="bullet">20.</span> 突き合わせの節に、用語の衝突を確認した記録があるか。「確認したが見つから</span><br><span class="line"><span class="code">    なかった」でも合格。形跡がなければ要修正。</span></span><br><span class="line"><span class="code"></span></span><br><span class="line"><span class="section">## F. 機密</span></span><br><span class="line"></span><br><span class="line"><span class="bullet">21.</span> 個社名が残っていないか。統計として個社名なしで書ける数値は対象外。</span><br><span class="line"><span class="bullet">22.</span> 顧客名・案件名・プロジェクトコード・アカウント ID が含まれていないか。</span><br><span class="line"></span><br><span class="line"><span class="section">## G. 取得できる環境なら追加で</span></span><br><span class="line"></span><br><span class="line"><span class="bullet">23.</span> 出典表の URL を開き、到達できるか。到達できない行を挙げる。成果物が取得の</span><br><span class="line"><span class="code">    失敗を書き残している行は、想定どおりなので要修正に数えない。</span></span><br><span class="line"><span class="code">24. 引用の照合。成果物が出典から引いている記述を抜き出し、その出典を開いて</span></span><br><span class="line"><span class="code">    同じ記述があるかを確かめる。対象は数値だけではありません。次をすべて</span></span><br><span class="line"><span class="code">    含めます。</span></span><br><span class="line"><span class="code">    - 数値（発行日、ページ数、件数、単位付きの値）。</span></span><br><span class="line"><span class="code">    - 条文・箇条・附属書の番号。</span></span><br><span class="line"><span class="code">    - 定義文と、かぎ括弧で引用している語句。</span></span><br><span class="line"><span class="code">    - 機関名・団体名・制度名などの固有名詞。</span></span><br><span class="line"><span class="code">      一致したものは「一致」、違っていたものは「不一致」とし、成果物の記述と</span></span><br><span class="line"><span class="code">      出典の記述を両方引用する。読めなかったものは「照合できず」とし、理由を</span></span><br><span class="line"><span class="code">      添える。推測で一致したことにしない。</span></span><br><span class="line"><span class="code">25. 出典 ID は添えられているが、その出典にその記述がないものがないか。項目 11</span></span><br><span class="line"><span class="code">    が ID の有無を見るのに対し、ここは ID の中身を見ます。語の置き換え（制度や</span></span><br><span class="line"><span class="code">    団体の現在の名称へ直してしまうなど）が起きやすい箇所です。</span></span><br><span class="line"><span class="code"></span></span><br><span class="line"><span class="section">## やらないこと</span></span><br><span class="line"></span><br><span class="line"><span class="bullet">-</span> 内容の正しさは判定しません。出典に当たって事実を確かめるのは人の仕事です。</span><br><span class="line">  項目 24 と 25 は、出典にそう書いてあるかの照合であって、出典が正しいかの</span><br><span class="line">  判定ではありません。</span><br><span class="line"><span class="bullet">-</span> 文章の良し悪しは判定しません。</span><br><span class="line"><span class="bullet">-</span> 直しません。どこが要修正かだけを報告してください。</span><br><span class="line"><span class="bullet">-</span> 項目を統合・要約・省略・重複排除しないでください。25 項目すべてについて</span><br><span class="line">  書いてください。</span><br></pre></td></tr></table></figure></div>

</details>
]]></content>
    <summary type="html">業界の下調べを AI に任せると、字数の指定に合わせて工程・構成・オブジェクトといった肝心の項目が落ちました。字数ではなく書くべき節で縛り、出典を3段に分けて確認状況を持たせた手順と、人が確かめるべき箇所をまとめます。</summary>
    <category term="AIDD" scheme="https://future-architect.github.io/categories/AIDD/"/>
    <category term="Claude" scheme="https://future-architect.github.io/tags/Claude/"/>
    <category term="キャッチアップ" scheme="https://future-architect.github.io/tags/%E3%82%AD%E3%83%A3%E3%83%83%E3%83%81%E3%82%A2%E3%83%83%E3%83%97/"/>
    <category term="プロンプトエンジニアリング" scheme="https://future-architect.github.io/tags/%E3%83%97%E3%83%AD%E3%83%B3%E3%83%97%E3%83%88%E3%82%A8%E3%83%B3%E3%82%B8%E3%83%8B%E3%82%A2%E3%83%AA%E3%83%B3%E3%82%B0/"/>
  </entry>
  <entry>
    <title>WebMCPを試してみたがまだ時期尚早だった(2026年9月時点)</title>
    <link href="https://future-architect.github.io/articles/20260928a/"/>
    <id>https://future-architect.github.io/articles/20260928a/</id>
    <published>2026-09-27T15:00:00.000Z</published>
    <updated>2026-09-27T15:00:00.000Z</updated>
    <author><name>澁川喜規</name></author>
    <content type="html"><![CDATA[<p>コーディングエージェントを拡張するための規格というのがいくつかあります。まず最初に大流行したModel Context Protocol(MCP)。そしてSkillsは有名です。今回試してみたのがWebMCPです。</p>
<p>WebMCPはW3Cのアンオフィシャルなプロポーザルですが、提出しているのはMicrosoftとGoogleの人です。で、今の所対応してそうなブラウザが、Chromeと、Codexの内蔵ブラウザとのこと。</p>
<p>と言うことで試してみたところ、まだ現時点では実用には程遠そうだな、と言う感想でした。作業メモとして残しておきます。</p>
<h2 id="WebMCP（が一般で使えるようになったら）期待できること">WebMCP（が一般で使えるようになったら）期待できること</h2><p>MCPもSkillsもすでに多くの人が使っています。これらのツールは開発者にとってはいつでも使えるものですが、そうではないユーザーからするとコーディングエージェントを必要とするツールです。安ければ$10ぐらいとはいえ、開発者やビジネスでAIを契約しているユーザー以外には使いにくい。</p>
<p>非開発者でCodexやClaude Codeに課金している人はいるかもしれませんし、Microsoft Copilot 365を使っている人もいるかもしれないですが、一般向けWebサービスでMCPをインターフェースにして提供します！までは舵を切ることができるほどではないかと思っています。</p>
<figure><img fetchpriority="high" src="/images/2026/20260928a/concept.png" alt="" width="639" height="356" class="bordered"><figcaption>こうかも？</figcaption></figure>
<p>一方、WebMCPならば、ブラウザだけがあれば使えるようになるんじゃないかと思ったわけです。生成AIはできることがどんどん増えています。一言言えば80%の完成度のものが10%の時間でできると。とはいえ、残りの20%を期待通りにするのには細かいディレクションが必要でなかなか完成しない、というのが実情かと思います。どうしても言葉では指示しにくいものはGUIツールでディレクションを行う方が良いという場面は多いと思うので、そういったものを実装する土台としてかなり未来を感じたわけですよ。</p>
<h2 id="仕組み">仕組み</h2><p>MCPサーバーそのものは以下のような機能を提供しています。</p>
<ul>
<li>ツール: データを加工するなどのメソッド</li>
<li>リソース: データアクセスのRead系メソッド</li>
<li>プロンプト: ホスト(呼び出し側ツール)に読みこませるプロンプト</li>
</ul>
<p>一方、WebMCPはMCPサーバーのうちのツールだけに対応しています。それを登録しておきます。</p>
<div class="code-block"><figure class="highlight ts"><input type="checkbox" id="code-wrap-1gh6kzc-1" class="code-wrap-input" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-1gh6kzc-1" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="keyword">const</span> tools = [</span><br><span class="line">  &#123;</span><br><span class="line">    <span class="attr">name</span>: <span class="string">&#x27;get_project_summary&#x27;</span>,</span><br><span class="line">    <span class="attr">title</span>: <span class="string">&#x27;Get project summary&#x27;</span>,</span><br><span class="line">    <span class="attr">description</span>: <span class="string">&#x27;Read the current C4 project name, scope, and element counts.&#x27;</span>,</span><br><span class="line">    <span class="attr">inputSchema</span>: &#123; <span class="attr">type</span>: <span class="string">&#x27;object&#x27;</span>, <span class="attr">properties</span>: &#123;&#125;, <span class="attr">additionalProperties</span>: <span class="literal">false</span> &#125;,</span><br><span class="line">    <span class="attr">execute</span>: <span class="function">() =&gt;</span> (&#123; <span class="attr">project</span>: projectRef.<span class="property">current</span>.<span class="property">name</span>, <span class="attr">level</span>: scopeRef.<span class="property">current</span>.<span class="property">level</span>, <span class="attr">scope</span>: <span class="title function_">labelForScope</span>(projectRef.<span class="property">current</span>, scopeRef.<span class="property">current</span>), <span class="attr">elementCount</span>: <span class="title class_">Object</span>.<span class="title function_">keys</span>(projectRef.<span class="property">current</span>.<span class="property">elements</span>).<span class="property">length</span> &#125;),</span><br><span class="line">  &#125;,</span><br><span class="line">  :</span><br><span class="line">]</span><br><span class="line"><span class="comment">// 登録</span></span><br><span class="line"><span class="title class_">Promise</span>.<span class="title function_">all</span>(tools.<span class="title function_">map</span>(<span class="function">(<span class="params">tool</span>) =&gt;</span> &#123;</span><br><span class="line">    <span class="variable language_">document</span>.<span class="property">modelContext</span>.<span class="title function_">registerTool</span>(tool, &#123; <span class="attr">signal</span>: controller.<span class="property">signal</span> &#125;)</span><br><span class="line">&#125;))</span><br></pre></td></tr></table></figure></div>

<p>こうするとウェブアプリの操作をガシガシAIがやってくれていい感じになる？</p>
<h2 id="というわけで試してみようと思った">というわけで試してみようと思った</h2><p>試すにはウェブアプリケーションが必要なので、さっとCodexに作ってもらいました。Codex、初期のR大きめの秋色角丸パネルを並べた様なデザインからすると、だいぶ垢抜けた感じのUIを何も言わずに作ってくれる様になりましたね。C4 diagramのモデリングツールです。機能は全然足りていませんが。</p>
<p>Chromeに設定（<code>chrome://flags/#devtools-webmcp-support</code>）があるので有効にしてみました。これで右上のGeminiを開いて操作できたら神！と思ったらどうも登録したツールを見つけてくれない。</p>
<img src="/images/2026/20260928a/chrome-gemini.png" alt="" width="1010" height="565" loading="lazy">

<p>WebMCP - Model Context Tool Inspectorと言うツールを入れないといけないらしい。これを入れると確かにツールは出てくるが呼び出しにはAPIキーの登録が必要とのこと・・・それは一般人に使わせるには厳しい・・・</p>
<img src="/images/2026/20260928a/tool-inspector.png" alt="" width="1200" height="725" loading="lazy">

<p>OpenAIのChatGPTアプリのブラウザで開くと、チャットで確かに操作できました。気づいた点は以下の通り。</p>
<ul>
<li>GPT-5.6 Terra, GPT-5.6 Sol, GPT-6-Astraでは利用可能。同じ世代のGPT-5.6 Lunaは非対応</li>
<li>WebMCPのツールを使って、と明示して言う必要がある（言わないとツールを見つけてくれない？）</li>
<li>使ってはくれるのだがちょっと応答は遅いかもしれない。普通にComputer Useの方が早い可能性すらある</li>
</ul>
<img src="/images/2026/20260928a/chatgpt-browser.png" alt="" width="1200" height="667" loading="lazy">

<h2 id="まとめ">まとめ</h2><p>一般の人が使えるブラウザの中からAIを通じて操作ができるようになると、アプリケーションの作り方は変わってくるな、と期待して触ってみたのですが、まだ「いますぐアプリに組み込むべき！」というところには至っていないかな、という感想です。</p>
<p>ただ、将来的にこの様な体験が来るのは間違いないとは思っていて、そのインターフェースがMCPなのかSkillsなのかWebMCPなのか、ブラウザ内蔵AI機能を使ったウェブアプリに組込みのChat Botなのか、ラストワンマイルのアプリとの接合部分はどうなるかなー、と思っています。</p>
<p>今だとアプリ側がAIのAPIを使う、各アプリがエージェントを実装するというのが一般的だと思いますが、アプリごとにデスクトップアプリを作っていた時代に近く、ユーザーが選んだブラウザなどのツールが常に媒介するのはウェブ化と同じような進化だと思うので、将来的にはこのような世界になっていくと思います。</p>
<p>今後も定期的にアップデートをウォッチしていきたいなと思っています。</p>
]]></content>
    <summary type="html">ブラウザだけでAIからWebアプリを操作できるWebMCPを、ChromeとChatGPTアプリのブラウザで試した作業メモです。現時点では実用には程遠いという感想でした。</summary>
    <category term="AIDD" scheme="https://future-architect.github.io/categories/AIDD/"/>
    <category term="MCP" scheme="https://future-architect.github.io/tags/MCP/"/>
    <category term="Web" scheme="https://future-architect.github.io/tags/Web/"/>
    <category term="WebMCP" scheme="https://future-architect.github.io/tags/WebMCP/"/>
  </entry>
  <entry>
    <title>第21回言語処理若手シンポジウム (YANS2026) 参加報告</title>
    <link href="https://future-architect.github.io/articles/20260916a/"/>
    <id>https://future-architect.github.io/articles/20260916a/</id>
    <published>2026-09-15T15:00:00.000Z</published>
    <updated>2026-09-15T15:00:00.000Z</updated>
    <author><name>境田晃大</name></author>
    <content type="html"><![CDATA[<h2 id="はじめに">はじめに</h2><p>はじめまして。フューチャー株式会社 AI戦略推進グループ（AIXG）の境田と申します。2025年4月に入社し、自然言語処理（NLP）に関わる業務に携わっています。</p>
<p>2026年8月16日 (日) から18日 (火) にかけて、仙台国際センターで開催された<strong>第21回言語処理若手シンポジウム (YANS2026)</strong> に、当社はプラチナスポンサーとして協賛しました。NLPチームのメンバーが現地参加し、スポンサーセッションでの会社紹介や企業ブースの出展、ランチ懇親会の開催に取り組みました。</p>
<p>本記事では、シンポジウムの様子と、当社が贈呈したスポンサー賞、そして注目した発表についてご報告します。</p>
<p>なお、昨年のYANS2025の参加報告は 第20回言語処理若手シンポジウム (YANS2025) 参加報告 にまとめています。あわせてご覧ください。</p>
<img fetchpriority="high" src="/images/2026/20260916a/top.jpeg" alt="" width="600" height="640">

<h2 id="言語処理若手シンポジウム-YANS-とは">言語処理若手シンポジウム (YANS) とは</h2><p>YANS (NLP若手の会) は、自然言語処理・計算言語学およびその関連分野において、若手研究者・技術者の研究開発を促進し、参加者の相互交流と成長の場を提供することを目的として、年に1度開催されているシンポジウムです。</p>
<p>今年のテーマは <strong>「若手のその先へ」</strong>。自然言語処理研究の歩みと、それを支える研究者・技術者の中長期的なキャリアについて理解を深める場、というコンセプトが掲げられていました。プログラムに並んでいたチュートリアルや特別企画セッションにも、このテーマが色濃く反映されていたように感じます。</p>
<p>直近3年の推移は次のとおりです。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 開催年 / 参加者数 / 発表件数 / スポンサー団体数"><table>
<thead>
<tr>
<th>開催年</th>
<th>参加者数</th>
<th>発表件数</th>
<th>スポンサー団体数</th>
</tr>
</thead>
<tbody><tr>
<td>2024</td>
<td>411名</td>
<td>196件</td>
<td>24団体</td>
</tr>
<tr>
<td>2025</td>
<td>570名</td>
<td>257件</td>
<td>28団体</td>
</tr>
<tr>
<td>2026</td>
<td>571名</td>
<td>248件</td>
<td>37団体</td>
</tr>
</tbody></table></div>
<p>参加者数・発表件数は昨年と同水準ですが、<strong>スポンサー団体数は28から37へと大きく増えています</strong>。自然言語処理に取り組む企業が増え、若手との接点を求める動きが強まっていることが、数字にも表れているように思います。</p>
<p>3日間のプログラムは以下の構成でした。</p>
<ul>
<li><strong>1日目 (8&#x2F;16)</strong> ハッカソン</li>
<li><strong>2日目 (8&#x2F;17)</strong> オープニング &#x2F; チュートリアル(1) &#x2F; ポスターセッション(1)(2)(3) &#x2F; スポンサーセッション &#x2F; ナイトセッション</li>
<li><strong>3日目 (8&#x2F;18)</strong> ハッカソン報告会 &#x2F; ポスターセッション(4)(5) &#x2F; チュートリアル(2) &#x2F; 招待ポスター &#x2F; 特別企画セッション &#x2F; クロージング</li>
</ul>
<h2 id="スポンサー参加">スポンサー参加</h2><p>フューチャーはプラチナスポンサーとして参加し、スポンサーセッションで発表するとともに、スポンサーブースで会社を紹介しました。ブースにお越しいただいた方には、生成AI基盤モデルの開発やLLMの業務適用といった当社のNLPやAI関連の取り組みをご紹介しました。</p>
<p>ノベルティには当社のロゴ入りのポーチやエコバッグをご用意しました。立ち寄ってくださった方の中には、すでに当社の社名や事業内容をご存じの方も多く、認知が着実に広がっていることを実感しました。改めてブースに足を運んでくださった皆様に感謝申し上げます。</p>
<img src="/images/2026/20260916a/booth.jpeg" alt="" width="1200" height="1151" loading="lazy">

<h3 id="ランチ懇親会">ランチ懇親会</h3><p>3日目の8月18日 (火) のお昼に、学会会場近くの施設をお借りして<strong>ランチ懇親会</strong>を開催しました。</p>
<p>当日はAIXGのメンバーによるライトニングトーク2本と、座談会を行いました。</p>
<ol>
<li><strong>実用化へ繋がったコンテンツ編集特化LLMの研究開発プロジェクトについて 〜企業で研究と社会実装の両輪を回す働き方のリアル〜</strong><br>メディア業界のコンテンツ編集業務に特化したLLMの研究開発プロジェクトを例に、初期検討から論文化、実用化に至るまでの軌跡を紹介しました。実際のプロジェクトならではの難しさと、そこから学術的な価値を生み出す面白さの両面をお話ししました。</li>
<li><strong>研究と社会実装のあいだ：ITコンサルタントが歩むグラデーション・キャリア</strong><br>「進学か就職か」「研究かビジネスか」は二元論で語られがちですが、どちらかを選んだらもう一方を諦めなければならないわけではありません。ビジネスの前線で顧客課題に向き合う中での心境の変化を経て、社会人博士という挑戦に至るまでの過程をお話ししました。</li>
</ol>
<p>参加者は学部生から博士課程の方まで幅広く、終了予定の時刻を過ぎても当社社員と熱心に話し込んでいる学生の方もいらっしゃいました。</p>
<p>開催後のアンケートでは、回答者全員から「満足」以上の評価をいただき、その大半が「大変満足」でした。印象に残った点として最も多く挙がったのは<strong>社会人博士</strong>に関する話題で、博士課程に進んでも企業でキャリアを築く選択肢があると分かった、研究と業務の関係性を具体的に聞けた、といった声をいただいています。</p>
<p>大会テーマが「若手のその先へ」でしたので、<strong>企業で研究を続けるという選択肢</strong>について、実際にその道を歩んでいるメンバーから直接お話しできる場になったのではないかと思っています。</p>
<h2 id="スポンサー賞と注目した発表">スポンサー賞と注目した発表</h2><p>当社は今年もスポンサー賞を1件贈呈しました。あわせて、選考の候補に挙がった発表を1件紹介します。</p>
<h3 id="S5-P31-LLM-as-a-Judgeにおける絶対評価と相対評価の整合性はスコア帯でどのように変わるか？（スポンサー賞）">[S5-P31] LLM-as-a-Judgeにおける絶対評価と相対評価の整合性はスコア帯でどのように変わるか？（スポンサー賞）</h3><p>山下 伊織、木山 朔、伊藤 大陽、小町 守（一橋大学）</p>
<p>この研究では、LLMに品質評価をさせる際の「1件ずつ点数を付ける絶対評価」と「2件を並べて選ばせる相対評価」の評価結果の食い違いに着目し、その発生率や要因がスコア帯によってどのように変わるのかを分析しています。評価形式によって結論が逆転すること自体は知られていますが、この研究では複数のLLMとタスクで検証し、逆転の要因について、スコア帯に応じて傾向の違いがあることや、スコア帯横断的な要因とLLM・タスクにも影響される局所的な要因に分けられることを報告しています。</p>
<p>選定理由は以下の通りです。</p>
<blockquote>
<p>本研究は、LLM-as-a-Judgeの絶対・相対評価の不整合をスコア帯ごとに分析し、その要因を広く影響するものと局所的なものとに切り分けて示しました。当社でも業種の異なる多様な顧客向けの開発において、既存の自動評価指標では捉えきれない品質の評価にLLM-as-a-Judgeを用いる機会があり、スコアの解釈は運用上の重要な課題です。実務に直結する指針を与えた研究として、スポンサー賞に選定いたしました。</p>
</blockquote>
<p>副賞として、開催地にちなんで牛タンの食べ比べセットを贈呈しました。</p>
<h3 id="S2-P30-Activation-Steeringにおける文章崩壊の抑制に向けた初期検討">[S2-P30] Activation Steeringにおける文章崩壊の抑制に向けた初期検討</h3><p>西山 天、川田 拓朗、北田 俊輔、永井 大地、彌冨 仁（法政大学）</p>
<p>この研究では、LLMの内部状態にベクトルを足し込んで出力を制御するActivation Steeringについて、生成される文章の崩壊を抑える手法を検討しています。</p>
<p>従来手法は1トークンを出力するたびに同じ強さでベクトルを足すため、目的の概念以外の表現にまで影響が及んでしまったり、介入が不要な箇所にまで作用し、無用な反復や意味の破綻した文章を招いてしまいます。この研究では、介入する位置と強度をトークンごとに決める機構と、元の内部状態を極力保ったまま、目的の概念へ変換する機構を組み合わせた手法を提案しており、2つの機構の適用順を誤ると出力が崩壊することも報告されていました。介入の「どこに・どれだけ」と「どう」を分けて整理した枠組みが明快で、参考になる発表だと感じました。</p>
<h2 id="さいごに">さいごに</h2><p>YANS2026では、スポンサーセッション、ブース、ランチ懇親会を通じて、多くの学生・若手研究者の皆様とお話しできました。ご来場いただいた皆様、そして運営に携わられた委員の皆様に、この場を借りて御礼申し上げます。</p>
<p>今回紹介した2件は、いずれもLLMを実務で運用する際に壁となる「評価」や「制御」の課題を扱った発表でした。実務でLLMを組み込む際は、出力の良し悪しを測る仕組み自体が信頼できるか、意図した制御が思わぬ副作用を生んでいないかといった点が見落とされやすいと感じます。</p>
<p>発表全体のトピックを見ても、「NLPモデルの評価・安全性・信頼性」に分類される発表が非常に多く見られました。LLMの活用が広がったからこそ、いかに評価し、いかに制御するかへの関心が高まっているのだろうと感じました。</p>
<p>AIXGでは一緒に働く仲間を募集しています！NLPエンジニア&#x2F;リサーチャー、AIアーキテクト&#x2F;コンサルタント、AIエージェント開発者といったポジションがありますので、ピンときた方はぜひ覗いてみてください。</p>
<p>博士課程の方向けのResearch Internや研究アルバイトも通年で受け付けています。新卒採用・キャリア採用も幅広く行っていますので、まずは話を聞いてみたいという方も歓迎です。</p>
<p>来年のYANSでもまたお会いできればうれしいです。一緒に働きましょう！</p>
<h2 id="参考">参考</h2><ul>
<li>第21回言語処理若手シンポジウム (YANS2026) プログラム<ul>
<li>YANS2026の公式プログラムです。発表一覧が掲載されています。</li>
</ul>
</li>
<li>第20回言語処理若手シンポジウム (YANS2025) 参加報告<ul>
<li>昨年のYANSの参加報告です。</li>
</ul>
</li>
</ul>
]]></content>
    <summary type="html">2026年8月16日から18日にかけて仙台国際センターで開催されたYANS2026に、プラチナスポンサーとして協賛しました。シンポジウムの様子と、当社が贈呈したスポンサー賞、そして注目した発表についてご報告します。</summary>
    <category term="DataScience" scheme="https://future-architect.github.io/categories/DataScience/"/>
    <category term="NLP" scheme="https://future-architect.github.io/tags/NLP/"/>
    <category term="YANS" scheme="https://future-architect.github.io/tags/YANS/"/>
    <category term="参加レポート" scheme="https://future-architect.github.io/tags/%E5%8F%82%E5%8A%A0%E3%83%AC%E3%83%9D%E3%83%BC%E3%83%88/"/>
    <category term="論文紹介" scheme="https://future-architect.github.io/tags/%E8%AB%96%E6%96%87%E7%B4%B9%E4%BB%8B/"/>
  </entry>
  <entry>
    <title>夏休みの宿題をオンスケで終えられなかった私が、AWS全冠を約2か月で完走できた理由</title>
    <link href="https://future-architect.github.io/articles/20260909a/"/>
    <id>https://future-architect.github.io/articles/20260909a/</id>
    <published>2026-09-08T15:00:00.000Z</published>
    <updated>2026-09-08T15:00:00.000Z</updated>
    <author><name>棚井龍之介</name></author>
    <content type="html"><![CDATA[<img fetchpriority="high" class="bordered" src="/images/2026/20260909a/thumbnail.png" alt="" width="300" height="158">

<p>FutureVulsチームの棚井です。この記事は夏休み自由研究連載2026の1本として書いています。</p>
<p>「夏休み自由研究」連載の趣旨は、童心を思い出して何かをじっくり研究してみることだそうです。「夏休み」と言われて最初に思い出したのは、昔、8月31日の夜に机の上に残っていた宿題でした。当時、夏休みの宿題を予定どおりに終えた記憶はありません。毎年ギリギリに着手して、なんとか提出には間に合わせていました。</p>
<p>2026年8月31日、私は試験センターでAWS認定の最後の1つを受験しました。この試験にも合格し、全冠を達成しました。最初の1資格は5月に取得済みで、6月末のAWS Summit Japan 2026をきっかけに全冠を目指し、7月1日から8月31日までの約2か月で残り11資格を取得したことになります。</p>
<p>短期間でAWS全冠という記事はすでに多く、35日で終えた方もいます。今回は速さよりも、昔は予定どおりに進められなかった私が、今回の資格の勉強を試験日に間に合わせられた理由を振り返ります。</p>
<h2 id="前提">前提</h2><p>この記事では、2026年8月31日時点で、下表の12資格をすべて保有した状態を「全冠」と呼びます。2026 Japan All AWS Certifications Engineersの資格要件を基準に、選択可能な資格についてはCloudOps Engineer - AssociateとGenerative AI Developer - Professionalを取得しました。これは保有資格の範囲を示すための基準で、2026年の同表彰を受けたという意味ではありません。</p>
<div class="note-container note-info"><span class="note-icon"></span><div>

<p>AWS認定の体系は変わり続けており、2026年9月1日には新しい認定 AWS Certified AI Business Strategist が発表されました。ベータ試験は同年9月29日から提供される予定です。Japan All AWS Certifications Engineers の対象資格は毎年 AWS JAPAN APN ブログ で発表されるので、今後、表彰を目指す場合は該当年度の条件を確認してください。</p>
</div></div>

<p>私はAWSを使った経験が通算4〜5年あり、直近の2年ほどは業務でインフラの設計・運用に継続的に携わっていました。クラウドコストの削減や構成の見直しなどを通じて、複数のサービスを学んできました。試験対策を短期間で進められた背景には、この下地があります。5月に取ったSecurity - Specialtyは会社の資格補助が出るから受けたもので、その時点では全冠を目指していませんでした。全冠を目指すきっかけになったのは、Summitの会場で、AWSのエコシステムが日本のさまざまな産業に広がっていると実感したことです。</p>
<p>受験履歴は次のとおりです。日付はすべて2026年で、資格名の「AWS Certified」は省略しています。個々の試験対策は、各合格体験記にまとめています。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 受験日 / 区分 / 資格 / スコア / 合格記"><table>
<thead>
<tr>
<th>受験日</th>
<th>区分</th>
<th>資格</th>
<th align="right">スコア</th>
<th>合格記</th>
</tr>
</thead>
<tbody><tr>
<td>5&#x2F;18</td>
<td>Specialty</td>
<td>Security - Specialty</td>
<td align="right">823</td>
<td>合格体験記</td>
</tr>
<tr>
<td>7&#x2F;1</td>
<td>Specialty</td>
<td>Advanced Networking - Specialty</td>
<td align="right">769</td>
<td>合格体験記</td>
</tr>
<tr>
<td>7&#x2F;14</td>
<td>Professional</td>
<td>Generative AI Developer - Professional</td>
<td align="right">794</td>
<td>合格体験記</td>
</tr>
<tr>
<td>7&#x2F;25</td>
<td>Professional</td>
<td>Solutions Architect - Professional</td>
<td align="right">812</td>
<td>合格体験記</td>
</tr>
<tr>
<td>7&#x2F;27</td>
<td>Professional</td>
<td>DevOps Engineer - Professional</td>
<td align="right">833</td>
<td>合格体験記</td>
</tr>
<tr>
<td>7&#x2F;30</td>
<td>Associate</td>
<td>Solutions Architect - Associate</td>
<td align="right">807</td>
<td>Associate 3資格 合格体験記</td>
</tr>
<tr>
<td>8&#x2F;1</td>
<td>Associate</td>
<td>CloudOps Engineer - Associate</td>
<td align="right">817</td>
<td>同上</td>
</tr>
<tr>
<td>8&#x2F;3</td>
<td>Associate</td>
<td>Developer - Associate</td>
<td align="right">853</td>
<td>同上</td>
</tr>
<tr>
<td>8&#x2F;5</td>
<td>Foundational</td>
<td>Cloud Practitioner</td>
<td align="right">811</td>
<td>Foundational 2資格 合格体験記</td>
</tr>
<tr>
<td>8&#x2F;7</td>
<td>Foundational</td>
<td>AI Practitioner</td>
<td align="right">793</td>
<td>同上</td>
</tr>
<tr>
<td>8&#x2F;24</td>
<td>Associate</td>
<td>Data Engineer - Associate</td>
<td align="right">773</td>
<td>Associate 2資格 合格体験記</td>
</tr>
<tr>
<td>8&#x2F;31</td>
<td>Associate</td>
<td>Machine Learning Engineer - Associate</td>
<td align="right">784</td>
<td>同上</td>
</tr>
</tbody></table></div>
<p>合格ラインはSpecialtyとProfessionalが750、Associateが720、Foundationalが700で、私は12試験とも1回で合格しています。</p>
<img class="bordered" src="/images/2026/20260909a/burndown.png" alt="" width="1200" height="620" loading="lazy">

<h2 id="進め方">進め方</h2><p>細かい学習計画は立てず、先に決めたのは受験の順番のみです。難易度の高い試験から先に取り組み、そこで学んだ知識を後続の試験でも使う方針で進めました。実際、Professionalの取得後は、AssociateやFoundationalの準備がだいぶ楽になりました。</p>
<p>AWS認定には、次の試験に使える受験料50%割引の特典があります。私は合格後にバウチャーの案内を確認すると、その場でカレンダーと試験センターの空きを見て次の試験を予約し、それから勉強を始めていました。2試験目以降はこのバウチャーを利用しました。制度上は試験開始の24時間前まで日程を変更できますが、私は予約した日を動かさないと決めていました。先に予定を入れ、締切の圧力で自分を動かすこの方法を、自分では「予定先入れ・締切駆動」と呼んでいました。予約を先にしたのは、「勉強が終わったら申し込む」では、いつまでも着手しない気がしたからです。目の前の1試験に集中でき、合格後に何をするかも決まっていたので、迷わず次に進めました。</p>
<p>勉強は基本的に、試験ガイドで範囲を確認し、演習問題やAWS Skill BuilderのOfficial Pretestで理解度を測り、不足している知識を補う流れでした。間違えたところや自信のなかったところを中心に、公式ドキュメントを調べ、AIも理解の補助に使いました。AIの説明は誤ることもあるため、技術的な根拠は公式ドキュメントで確認する必要があります。</p>
<p>先行する学習だけでは足りない部分もあり、私は試験ごとに準備の量を変えています。たとえばCloudOpsでは、演習で見覚えのない仕様が出てきたため、問題演習を1回分から2回分に増やしました。一方、同記事のDeveloperでは、実務経験と出題範囲が重なっていたため、試験ガイドの確認だけで受験しています。状況を把握し、重点的に調べるところと、どこまで調べるかを決めるというこの進め方は、業務のインシデント対応で行う優先順位付けに少しだけ似ている気がしました。</p>
<h2 id="同じ進め方が成り立つ条件と全冠の限界">同じ進め方が成り立つ条件と全冠の限界</h2><p>この受験ペースを支えた条件で、いちばん大きいのは学習と受験に使える時間です。私は試験センターを利用したので、空いている受験枠に合わせて数日おきに予定を調整できることも必要でした。次に、この領域の勉強を楽しめることです。資格の勉強で得た知識を業務のどの場面で使えるか、想像するのが面白かったので私は続けられました。興味を持てなければ、数日おきの締切はかなりの負担だったと思います。実務経験や先行資格の知識に加え、会社の受験補助、Skill Builderの有料プランやAIを使える環境も、このペースを支えた条件です。</p>
<p>全冠を達成した今の私は、試験に出る範囲の地図を一通り持ったくらいの状態です。サービスの用途や位置づけをつかむ助けにはなりますが、実際の設計・運用や障害対応には、個々のサービスに触れて経験を積む必要があります。</p>
<h2 id="おわりに">おわりに</h2><p>「締切を先に買う」という進め方は、自分には合っていました。受験料を払って日付を決め、合否で区切りをつけ、次の予約に進む流れです。細かな学習計画がなくても、この流れで着手と完了を繰り返せたことは、資格そのものと同じくらいの収穫です。</p>
<p>昔の夏休みは、宿題の提出期限ばかりを見ていました。今回の受験では、資格ごとに近い締切と明確な完了条件がありました。当時とは経験も学習への興味も異なるので単純には比較できませんが、自分にとっては、遠い締切に向けて大きな課題を抱えるより、完了を判定できる単位に分けて近い締切を置くことが有効だったようです。今更ですが。</p>
]]></content>
    <summary type="html">2026年7月から8月の約2か月で、AWS認定の残り11資格に一発合格し、全冠を達成しました。細かい学習計画は立てず、合格したその場で次の試験を予約する「予定先入れ・締切駆動」で進めた記録です。</summary>
    <category term="Cloud" scheme="https://future-architect.github.io/categories/Cloud/"/>
    <category term="AWS" scheme="https://future-architect.github.io/tags/AWS/"/>
    <category term="合格記" scheme="https://future-architect.github.io/tags/%E5%90%88%E6%A0%BC%E8%A8%98/"/>
  </entry>
  <entry>
    <title>AWS Certified Associate 2資格 合格体験記 - DEAはRedshift、MLAはSageMaker</title>
    <link href="https://future-architect.github.io/articles/20260908a/"/>
    <id>https://future-architect.github.io/articles/20260908a/</id>
    <published>2026-09-07T15:00:00.000Z</published>
    <updated>2026-09-07T15:00:00.000Z</updated>
    <author><name>棚井龍之介</name></author>
    <content type="html"><![CDATA[<img fetchpriority="high" src="/images/2026/20260908a/aws-dea-mla-2badges-diagonal.png" alt="" width="600" height="734">

<h2 id="はじめに">はじめに</h2><p>Cyber Security Innovation Group、FutureVulsチームの棚井です。</p>
<p>2026年8月24日と8月31日に、データサイエンティストや機械学習エンジニアに向けたAssociateレベルの2資格を受験し、どちらも一発合格しました。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 資格 / 受験日 / スコア"><table>
<thead>
<tr>
<th align="left">資格</th>
<th align="left">受験日</th>
<th align="left">スコア</th>
</tr>
</thead>
<tbody><tr>
<td align="left">AWS Certified Data Engineer - Associate (DEA-C01)</td>
<td align="left">2026&#x2F;08&#x2F;24</td>
<td align="left">773点</td>
</tr>
<tr>
<td align="left">AWS Certified Machine Learning Engineer - Associate (MLA-C01)</td>
<td align="left">2026&#x2F;08&#x2F;31</td>
<td align="left">784点</td>
</tr>
</tbody></table></div>
<p>どちらも100〜1,000点のスケールスコアで、合格ラインは720点です。</p>
<p>前回のAssociate 3連戦 で書いたとおりAssociateは5つあり、残っていたこの2つに合格したことで、AWS全冠になりました。受験順序や費用を含めた全冠の話は別の記事にまとめるので、この記事は2試験の体験記に絞ります。</p>
<p>準備は、Udemyの演習問題を各試験2回分(2試験で計260問)解いたのみです。ただ、率直に言うとこの2つは苦手意識のある領域でした。データエンジニアリングも機械学習も普段の業務ではほとんど利用経験がなく、スコアが12試験のなかでは低めなのもその表れです。実務経験のない領域を演習問題でどう補ったか、1つのサンプルとして読んでもらえればと思います。</p>
<h2 id="試験の概要">試験の概要</h2><p>2試験とも受験条件は共通です。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 項目 / 内容"><table>
<thead>
<tr>
<th align="left">項目</th>
<th align="left">内容</th>
</tr>
</thead>
<tbody><tr>
<td align="left">試験時間</td>
<td align="left">130分</td>
</tr>
<tr>
<td align="left">問題数</td>
<td align="left">65問(採点対象50問+採点対象外15問)</td>
</tr>
<tr>
<td align="left">受験料</td>
<td align="left">150 USD</td>
</tr>
<tr>
<td align="left">合格ライン</td>
<td align="left">100〜1,000点のスケールスコアで720点</td>
</tr>
</tbody></table></div>
<p>違うのは出題形式で、DEAが択一選択問題と複数選択問題の2種類のみなのに対し、MLAではこれに並べ替えと内容一致が加わります。どちらも AI Practitioner で経験済みの形式です。</p>
<h3 id="Data-Engineer-Associate-DEA-C01">Data Engineer - Associate (DEA-C01)</h3><p>データパイプラインの実装と運用を問う試験です。出題分野は次の4つです(試験ガイド)。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 分野 / 出題比率"><table>
<thead>
<tr>
<th align="left">分野</th>
<th align="left">出題比率</th>
</tr>
</thead>
<tbody><tr>
<td align="left">第1分野: データの取り込みと変換</td>
<td align="left">34%</td>
</tr>
<tr>
<td align="left">第2分野: データストア管理</td>
<td align="left">26%</td>
</tr>
<tr>
<td align="left">第3分野: データ運用とサポート</td>
<td align="left">22%</td>
</tr>
<tr>
<td align="left">第4分野: データセキュリティとガバナンス</td>
<td align="left">18%</td>
</tr>
</tbody></table></div>
<p>試験ガイドは、範囲外のジョブタスクとして「人工知能と機械学習 (AI&#x2F;ML) のタスクを実行する」を明記しています。AI&#x2F;MLは次のMLAの領分で、DEAはデータをためて、変換して、届けるまでが守備範囲です。</p>
<h3 id="Machine-Learning-Engineer-Associate-MLA-C01">Machine Learning Engineer - Associate (MLA-C01)</h3><p>MLモデルの開発、デプロイ、運用を問う試験です。出題分野は次の4つです(試験ガイド)。</p>
<div class="scroll" tabindex="0" role="region" aria-label="Machine Learning Engineer - Associate (Mの表 分野 / 出題比率"><table>
<thead>
<tr>
<th align="left">分野</th>
<th align="left">出題比率</th>
</tr>
</thead>
<tbody><tr>
<td align="left">第1分野: 機械学習 (ML) のためのデータ準備</td>
<td align="left">28%</td>
</tr>
<tr>
<td align="left">第2分野: ML モデルの開発</td>
<td align="left">26%</td>
</tr>
<tr>
<td align="left">第3分野: ML ワークフローのデプロイとオーケストレーション</td>
<td align="left">22%</td>
</tr>
<tr>
<td align="left">第4分野: ML ソリューションのモニタリング、保守、セキュリティ</td>
<td align="left">24%</td>
</tr>
</tbody></table></div>
<p>なお、MLA-C01は更新が発表されており、次バージョンMLA-C02のベータ試験の登録が2026年9月1日に始まります。英語版MLA-C01の最終受験日は2026年9月28日で、日本語版はベータ期間中も引き続き受験できます(公式発表)。これから受ける人は、移行スケジュールを確認してから予約するのをおすすめします。</p>
<h2 id="学習方法">学習方法</h2><p>教材は今回も syo @Cloud講師 のUdemy演習問題集だけです。どちらもUdemyのサブスクリプションプランには含まれていない講座なので、2講座分を追加購入しました。解いた問題は正誤にかかわらず解説を読み、知識の穴を埋めていく使い方は、これまでの試験と同じです。</p>
<h3 id="Data-Engineer-Associate-演習問題2回分">Data Engineer - Associate: 演習問題2回分</h3><img src="/images/2026/20260908a/DEA.png" alt="" width="640" height="203" loading="lazy">

<p>AWS認定データエンジニア - アソシエイト（DEA-C01）模擬試験問題集 2026年版 を使いました。演習問題は4回分収録されていますが、2回分で切り上げました。</p>
<h3 id="Machine-Learning-Engineer-Associate-演習問題2回分">Machine Learning Engineer - Associate: 演習問題2回分</h3><img src="/images/2026/20260908a/MLA.png" alt="" width="640" height="202" loading="lazy">

<p>生成AI系資格の学習では埋まらない範囲を補強する目的で、【図解付き詳細解説】AWS MLA-C01完全攻略問題集 | 構成図＆グラフ解説付き を使いました。</p>
<h2 id="試験を終えて">試験を終えて</h2><h3 id="DEAはRedshift、MLAはSageMaker">DEAはRedshift、MLAはSageMaker</h3><p>受験を終えた率直な感想がこの見出しで、試験ガイドを読み直すと、そのとおりのことが書いてあります。</p>
<p>DEA-C01のタスクステートメントには、フェデレーションクエリ、マテリアライズドビュー、Redshift Spectrum、ストアドプロシージャ、データ共有と、Redshiftの機能が分野をまたいで繰り返し登場します。分析カテゴリにはAthenaやEMR、Glueなどのサービスがずらりと並びますが、機能単位でここまで踏み込まれるのはRedshiftです。</p>
<p>MLA-C01は輪をかけて明快です。受験対象者からして「Amazon SageMaker をはじめとする AWS のサービスを利用した ML エンジニアリングの経験が 1 年以上ある方」で、タスクステートメントにはData WranglerからRole ManagerまでSageMakerの機能名が20種類近く出てきます。SageMakerをどれだけ細かく知っているかの試験です。</p>
<p>受験を決めたら試験ガイドでこの主役を確認し、そこを演習問題で固める。この2試験の対策は、それで足りると思います。</p>
<h3 id="生成AI系資格の学習は、MLAにどこまで効いたか">生成AI系資格の学習は、MLAにどこまで効いたか</h3><p>7月に Generative AI Developer - Professional (AIP-C01)、8月に AI Practitioner (AIF-C01) と生成AI系の認定を取ってきたので、MLAはその貯金でいけるだろうと見込んでいました。結果は半分だけ正解でした。</p>
<p>効いたのはSageMakerの周辺知識です。AIP-C01の範囲内サービスにはSageMaker系の項目が10個含まれていて(SageMaker AIのほか、Clarify、Data Wrangler、Ground Truth、JumpStart、Model Monitor、Model Registry、Neoなど)、MLAの試験ガイドに登場する機能の一部は、AIP対策で一度通っていました。IaCやCI&#x2F;CD、モニタリングといったMLOps寄りの考え方も共通です。</p>
<p>一方、SageMakerの組み込みアルゴリズムやスクリプトモード、自動モデルチューニング(AMT)、Feature Store、それに混同行列、F1スコア、RMSE、ROC-AUCといったモデル評価のメトリクスについては、生成AI系2資格の試験ガイドではAI Practitionerが一部の名前に触れる程度で、MLAのような踏み込みはありません。演習問題2回分は、実質この穴埋めに使いました。</p>
<p>ちなみにAIP-C01の認定ページは、AIPの受験前に取得しておくとメリットがある認定としてMLAを挙げています。上位レベルから受けてきた自分は、今回も順番が逆です。</p>
<h2 id="おわりに">おわりに</h2><p>これで保有するAWS認定は、Specialty 2つ、Professional 3つ、Associate 5つ、Foundational 2つの計12個になりました。2試験とも、スコアレポートの分野別評価は全分野で「コンピテンシーを満たしている」でした。</p>
<p>5月18日に Security - Specialty を受けたあと、全冠に向けて本格着手したのは7月1日からで、そこから2ヶ月で残りの11資格を受け切りました。どの順で受けて、いくらかかったのか、そしてこのAI時代になぜ資格試験に取り組んだのかは、次の記事にまとめます。</p>
]]></content>
    <summary type="html">AWS認定のAssociateレベルで残っていたData EngineerとMachine Learning Engineerを受験し、どちらも一発合格しました。試験ガイドが示す主役はDEAがRedshift、MLAがSageMakerで、実務経験のない領域を演習問題2回分でどう補ったかをまとめます。</summary>
    <category term="Cloud" scheme="https://future-architect.github.io/categories/Cloud/"/>
    <category term="AWS" scheme="https://future-architect.github.io/tags/AWS/"/>
    <category term="合格記" scheme="https://future-architect.github.io/tags/%E5%90%88%E6%A0%BC%E8%A8%98/"/>
  </entry>
  <entry>
    <title>「👨‍👩‍👧‍👦」は何文字？ ― JavaScriptのlengthとUnicodeで文字を数える</title>
    <link href="https://future-architect.github.io/articles/20260907a/"/>
    <id>https://future-architect.github.io/articles/20260907a/</id>
    <published>2026-09-06T15:00:00.000Z</published>
    <updated>2026-09-06T15:00:00.000Z</updated>
    <author><name>永井優斗</name></author>
    <content type="html"><![CDATA[<!-- textlint-disable no-japanese-only-inline-code -->

<img fetchpriority="high" class="bordered" src="/images/2026/20260907a/thumbnail.png" alt="" width="300" height="200">

<p>FVG＆CodeCamp兼務出向中の永井です。</p>
<p>夏休み自由研究連載2026の8本目記事となります。</p>
<p>次のものは、それぞれ何文字でしょうか？</p>
<blockquote>
<p>A &#x2F; あ &#x2F; プ &#x2F; 😀 &#x2F; 🇯🇵 &#x2F; 👨‍💻 &#x2F; 👨‍👩‍👧‍👦</p>
</blockquote>
<p>だいたい全部「1文字」と答えたくなります。</p>
<figure class="highlight js"><table><tr><td class="code"><pre><span class="line"><span class="variable language_">console</span>.<span class="title function_">log</span>(<span class="string">&quot;A&quot;</span>.<span class="property">length</span>) <span class="comment">// 1</span></span><br><span class="line"><span class="variable language_">console</span>.<span class="title function_">log</span>(<span class="string">&quot;あ&quot;</span>.<span class="property">length</span>)         <span class="comment">// 1</span></span><br><span class="line"><span class="variable language_">console</span>.<span class="title function_">log</span>(<span class="string">&quot;😀&quot;</span>.<span class="property">length</span>)         <span class="comment">// 2</span></span><br><span class="line"><span class="variable language_">console</span>.<span class="title function_">log</span>(<span class="string">&quot;🇯🇵&quot;</span>.<span class="property">length</span>)       <span class="comment">// 4</span></span><br><span class="line"><span class="variable language_">console</span>.<span class="title function_">log</span>(<span class="string">&quot;👨‍💻&quot;</span>.<span class="property">length</span>)      <span class="comment">// 5</span></span><br><span class="line"><span class="variable language_">console</span>.<span class="title function_">log</span>(<span class="string">&quot;👨‍👩‍👧‍👦&quot;</span>.<span class="property">length</span>) <span class="comment">// 11</span></span><br></pre></td></tr></table></figure>

<p>最後の「家族」は、画面ではひとかたまりなのに 11。JavaScript が意外な数を返したように見えますが、仕様どおりに数えています。</p>
<h2 id="きっかけは、同じに見える「プ」">きっかけは、同じに見える「プ」</h2><p>きっかけは、フロントエンドカンファレンス名古屋で聞いた wabi さんの発表「見た目は同じなのに検索でヒットしない：ファイルアップロード実装の落とし穴と設計を考える」でした。発表では、1つの文字に見える <code>プ</code> が、見た目は同じでもコンピュータの中では違う並びで保存されることがある、と紹介されていました。発表の主題は、こうした違いがファイル名の検索にどう影響するかと、どこで文字列をそろえるかという設計です。</p>
<p>この発表を聞いて、私は別の疑問を持ちました。見た目はどちらも「プ」なのに、中身は違う。では、コンピュータにとって「1文字」とは何なのでしょうか。この記事では、wabi さんも取り上げていた <code>プ</code> を出発点に、その問いを実験してみます。検索の一致や文字列をそろえる方法ではなく、「何を数えたときに1文字と言えるのか」を調べるのが今回の目的です。</p>
<h2 id="4種類の「数え方」を用意する">4種類の「数え方」を用意する</h2><p>ここから少し専門用語が出てきます。でも、最初に全部覚える必要はありません。大事なのは、<strong>同じ文字列でも、何を数えるかで数字が変わる</strong>ことです。</p>
<p>たとえば JavaScript の <code>&quot;😀&quot;.length</code> は <code>2</code> でした。この <code>2</code> は、私たちが画面で見ている「顔が1つ」という数とは一致しません。JavaScriptの文字列を構成するUTF-16コードユニットを2つ数えた結果です。</p>
<p>標本は、直感と実装結果がずれやすく、実務で入力・検索・表示の場面に現れやすいものを選びました。今回は、次の4つの数え方で同じ標本を見比べます。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 数え方 / ひとことで言うと / どんなときに見る？"><table>
<thead>
<tr>
<th>数え方</th>
<th>ひとことで言うと</th>
<th>どんなときに見る？</th>
</tr>
</thead>
<tbody><tr>
<td>UTF-8バイト数</td>
<td>送ったり保存したりするときの<strong>データ量</strong></td>
<td>APIやファイルに「何バイトまで」という上限があるとき</td>
</tr>
<tr>
<td>UTF-16コードユニット数</td>
<td>JavaScriptが文字列を区切って数える<strong>箱の数</strong></td>
<td>JavaScriptの <code>String#length</code> が返す数</td>
</tr>
<tr>
<td>Unicodeコードポイント数</td>
<td>文字を作る部品についた<strong>Unicode上の番号の数</strong></td>
<td>「この文字列は、何の部品でできている？」と調べるとき</td>
</tr>
<tr>
<td>書記素クラスタ数</td>
<td>画面で人が<strong>一文字らしく読むまとまり</strong></td>
<td>UIの「あと○文字」の表示や、文字単位の入力制限を検討するとき（カーソル移動・削除の挙動はUIコンポーネント側の実装にも依存します）</td>
</tr>
</tbody></table></div>
<p>「コードユニット」や「コードポイント」という言葉は、今は名前だけで大丈夫です。後の実験で、<code>😀</code> や <code>👨‍💻</code> を実際に分解しながら見ていきます。</p>
<p>書記素クラスタは、フォント上の幅や、どの端末でも同じ見た目になることを保証する単位ではありません。それでも「利用者には何文字に見えるか」に近い数え方として役立ちます。今回は JavaScript の <code>Intl.Segmenter</code> を使って数えます。</p>
<h2 id="観察記録：だんだん様子がおかしくなる">観察記録：だんだん様子がおかしくなる</h2><h3 id="A-と-あは、まだ直感どおり">A と あは、まだ直感どおり</h3><p><code>A</code> は UTF-8 で1バイト、<code>あ</code> は3バイトです。保存するときのデータ量は違いますが、それ以外の数え方ではどちらも1です。ここでは、画面で見た「1文字」と、4種類の数え方がまだ仲よく一致しています。</p>
<h3 id="プは1個にも2個にもなる">プは1個にも2個にもなる</h3><p>これは先ほど紹介したwabiさんの発表でも取り上げられたものです。<code>プ</code> と <code>プ</code> は、多くの環境では同じように見えます。けれど中身を見ると、<code>プ</code> は1つの番号（<code>U+30D7</code>）で表される一方、 <code>プ</code> は、<code>フ</code>（<code>U+30D5</code>）と、半濁点だけを表す記号（<code>U+309A</code>）を2つ並べたものです。</p>
<p>そのため <code>プ</code> は、コードポイント数が2、JavaScriptの <code>length</code> も2、UTF-8では6バイトになります。それでも、画面では一文字らしく見えるので、書記素クラスタ数はどちらも1です。</p>
<p>同じように見える文字を、1つの番号で書く方法と「文字 + 印」で書く方法の両方を Unicode は認めています。この違いをそろえたいときに使うのが正規化です。<code>normalize(&quot;NFC&quot;)</code> の NFC は、正準等価な並びを可能な範囲で合成済み形式へそろえる正規化形式です。反対に NFD は、正準分解した形式へそろえる正規化形式です。たとえば <code>&quot;プ&quot;.normalize(&quot;NFC&quot;) === &quot;プ&quot;</code> は <code>true</code> になります。今回は正規化そのものが主役ではありません。「同じに見えても、数え方によっては2つになる」ことを覚えておけば十分です。</p>
<p>同じ現象は <code>é</code> と <code>e + ◌́</code> でも起きます。前者は1コードポイント・2バイト、後者は2コードポイント・3バイトです。</p>
<h3 id="😀で-JavaScript-の事情が見える">😀で JavaScript の事情が見える</h3><p>次は JavaScript の <code>length</code> です。<code>😀</code> は1つの顔に見えるのに、<code>&quot;😀&quot;.length</code> は <code>2</code> になります。なぜなら JavaScript は、文字列を16ビットずつの小さな箱に分けて数えるからです。<code>😀</code> の番号は1つの箱には入りきらないため、2つの箱を使います。この組をサロゲートペアと呼びます。</p>
<p>絵文字だけの話ではありません。<code>𠮷</code>（<code>U+20BB7</code>）も同じ理由で、<code>length</code> は2、コードポイント数は1です。つまり <code>length</code> は「画面に何文字見えるか」ではなく、JavaScriptが使っている箱の数です。</p>
<p><code>[...text].length</code> や <code>Array.from(text).length</code> を使うと、この2つ組は1つのコードポイントとして数えられるので、<code>😀</code> と <code>𠮷</code> では1を返します。</p>
<h3 id="🇯🇵には「日本国旗」という単独のコードポイントがない">🇯🇵には「日本国旗」という単独のコードポイントがない</h3><p>日本国旗の絵文字には、「日本国旗そのもの」を表す1つの番号はありません。J を表す記号（Regional Indicator Symbol Letter J、<code>U+1F1EF</code>）と P を表す記号（Regional Indicator Symbol Letter P、<code>U+1F1F5</code>）を並べて、日本を表しています。つまりコードポイントは2、JavaScriptの <code>length</code> は4、UTF-8では8バイトです。</p>
<p>それでも、対応している端末では2つの記号が1つの旗 <code>🇯🇵</code> として表示されます。書記素クラスタ数も1です。「国旗を1つ表示する」という見た目と、「記号を2つ持つ」という中身がここで分かれます。</p>
<h3 id="👍🏻は「絵文字-肌色指定」">👍🏻は「絵文字 + 肌色指定」</h3><p><code>👍🏻</code> も、中身は2つです。まず親指の絵文字があり、その後ろに肌の色を指定する記号が続きます。画面では1つの「肌色付きのいいね」に見えても、部品を数えれば2つあります。どちらの数も間違いではなく、何を数えたいかが違うだけです。</p>
<h3 id="👨‍💻の見えない接着剤">👨‍💻の見えない接着剤</h3><p><code>👨‍💻</code> の中身は、「男性」👨＋「見えない接着剤」＋「パソコン」💻の3つで構成されています。この見えない接着剤は ZWJ（Zero Width Joiner、<code>U+200D</code>）と呼ばれます。対応している端末では、ZWJが前後の絵文字をつなぎ、3つの部品を1つの「男性技術者」の絵文字として表示します。</p>
<p><code>👩‍🚀</code>、虹の旗 <code>🏳️‍🌈</code>、キス <code>👩‍❤️‍💋‍👨</code> も同じ仲間です。虹の旗やキスには「絵文字として表示してほしい」と伝える見えない記号も入っています。キーキャップの <code>1️⃣</code> も、数字の <code>1</code> に2つの記号を足して作られます。一文字に見える絵文字の中には、このように複数の部品と表示のルールが隠れています。</p>
<h3 id="ラスボス：家族の絵文字で全部が重なる">ラスボス：家族の絵文字で全部が重なる</h3><p>最後は家族の絵文字です。<code>👨‍👩‍👧‍👦</code> は、4人の人物と3個の見えない接着剤でできています。部品は合計7個。JavaScriptの <code>length</code> は11、UTF-8では25バイトです。</p>
<p>しかし <code>Intl.Segmenter</code> で区切ると、これは1つの書記素クラスタになります（本記事のNode.js v20.16.0環境での結果です。実装が参照するUnicode&#x2F;ICUのバージョンによって、新しい絵文字の分割結果は変わる可能性があります）。つまり、画面上の「一文字らしさ」を数えたいなら1です。ただし、書記素クラスタだけが唯一の正解ではありません。通信量の上限を守るなら25バイト、JavaScriptの添字を扱うなら11という数が必要です。目的が違えば、見るべき数も変わります。</p>
<h2 id="「10文字以内」の10文字を実験する">「10文字以内」の10文字を実験する</h2><p>次のバリデーションはよく見かけます。</p>
<figure class="highlight js"><table><tr><td class="code"><pre><span class="line"><span class="keyword">const</span> value = <span class="string">&quot;😀😀😀😀😀😀&quot;</span>;</span><br><span class="line"></span><br><span class="line"><span class="keyword">if</span> (value.<span class="property">length</span> &gt; <span class="number">10</span>) &#123;</span><br><span class="line">  <span class="comment">// 10文字を超えています</span></span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure>

<p>実際に測ると、6個の 😀 は <code>length === 12</code> なのでこの条件に引っかかります。一方でコードポイント数と書記素クラスタ数は6です。画面に「10文字以内」と出してこの実装を置くと、利用者は「まだ6文字なのに」と感じるかもしれません。JavaScript が間違っているのではなく、仕様の「10文字」と実装の「10 UTF-16コードユニット」が食い違っています。</p>
<p>UIでユーザーが読む個数を制限したいなら、意図をコードにも書いたほうがいいです。</p>
<div class="code-block"><figure class="highlight js"><input type="checkbox" id="code-wrap-h3fe67-1" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-h3fe67-1" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="keyword">const</span> segmenter = <span class="keyword">new</span> <span class="title class_">Intl</span>.<span class="title class_">Segmenter</span>(<span class="string">&quot;ja&quot;</span>, &#123; <span class="attr">granularity</span>: <span class="string">&quot;grapheme&quot;</span> &#125;);</span><br><span class="line"><span class="keyword">const</span> <span class="title function_">graphemeCount</span> = (<span class="params">text</span>) =&gt; <span class="title class_">Array</span>.<span class="title function_">from</span>(segmenter.<span class="title function_">segment</span>(text)).<span class="property">length</span>;</span><br><span class="line"></span><br><span class="line"><span class="keyword">if</span> (<span class="title function_">graphemeCount</span>(value) &gt; <span class="number">10</span>) &#123;</span><br><span class="line">  <span class="comment">// 画面上の1文字らしい単位で10個を超えています</span></span><br><span class="line">&#125;</span><br></pre></td></tr></table></figure></div>

<p>ただし、これで全問題が解決するわけではありません。</p>
<ul>
<li>ユーザー名、SNS投稿、フォームの残り文字数は書記素クラスタが候補</li>
<li>DBの制約は、その製品・照合順序・カラム定義が何を上限にするかを確認する</li>
<li>SMSや外部API、ファイル、メッセージングの上限では、バイト数やプロトコル固有の単位を確認する</li>
<li>JavaScript内部の切り出しや互換性のある既存仕様なら、UTF-16コードユニットが要件になることもある</li>
</ul>
<p>大事なのは「文字数」というラベルで済ませず、仕様に単位を添えることです。たとえば「表示上の書記素クラスタで10個まで」「（外部APIの仕様がUTF-8バイト数で上限を定めている場合は）UTF-8エンコード後512バイトまで」のように書く。後から実装する人も、テストを書く人も、困りにくくなります。</p>
<p>文字数を数える方法を選ぶことは、ライブラリを選ぶ話ではありません。利用者に何を約束し、その約束をテスト可能な言葉にするか、という仕様設計の話です。先に単位を決めておけば、UI、フロントエンド、API、データベースのそれぞれで同じ約束を確認できます。</p>
<h2 id="おわりに：「1文字」は自然な言葉、曖昧な仕様">おわりに：「1文字」は自然な言葉、曖昧な仕様</h2><p>人間にとって「👨‍👩‍👧‍👦」は、まず1つの家族の記号です。コンピュータにとっては、25バイト、11 UTF-16コードユニット、7コードポイント、1書記素クラスタでした。どれも同じ文字列についての正しい観察です。</p>
<p>つまり「1文字」という言葉は人間には自然でも、コンピュータにとっては曖昧です。まずは自分が担当している入力欄をひとつ選び、表示文言が「10文字」なら、その「10文字」がどの単位（書記素クラスタか、UTF-16コードユニットか、バイト数か）を指しているのか確認してみると良いかもしれません。今度「10文字以内」という仕様を見たら、エンジニアは一度だけ立ち止まって、こう聞いてみてもよいかもしれません。</p>
<blockquote>
<p>ところで、その1文字って何ですか？</p>
</blockquote>
<p>たぶん何それ？って言われますけど。</p>
<h2 id="付録：検証コード">付録：検証コード</h2><p>以下は記事内で使う分析関数です。<code>TextEncoder</code> で UTF-8 バイト列を得て、<code>String#length</code>、文字列イテレータ（<code>Array.from</code>）、<code>Intl.Segmenter</code> をそれぞれ別のものさしとして使います。Node.js 18 以降、または <code>Intl.Segmenter</code> 対応ブラウザで実行できます。</p>
<div class="code-block"><figure class="highlight js"><input type="checkbox" id="code-wrap-h3fe67-2" class="code-wrap-input" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-h3fe67-2" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="keyword">const</span> graphemeSegmenter = <span class="keyword">new</span> <span class="title class_">Intl</span>.<span class="title class_">Segmenter</span>(<span class="string">&quot;ja&quot;</span>, &#123; <span class="attr">granularity</span>: <span class="string">&quot;grapheme&quot;</span> &#125;);</span><br><span class="line"><span class="keyword">const</span> encoder = <span class="keyword">new</span> <span class="title class_">TextEncoder</span>();</span><br><span class="line"></span><br><span class="line"><span class="keyword">function</span> <span class="title function_">analyzeCharacter</span>(<span class="params">label, text</span>) &#123;</span><br><span class="line">  <span class="keyword">const</span> codePoints = <span class="title class_">Array</span>.<span class="title function_">from</span>(text);</span><br><span class="line">  <span class="keyword">const</span> graphemes = <span class="title class_">Array</span>.<span class="title function_">from</span>(</span><br><span class="line">    graphemeSegmenter.<span class="title function_">segment</span>(text),</span><br><span class="line">    <span class="function">(<span class="params">&#123; segment &#125;</span>) =&gt;</span> segment,</span><br><span class="line">  );</span><br><span class="line"></span><br><span class="line">  <span class="keyword">return</span> &#123;</span><br><span class="line">    label,</span><br><span class="line">    <span class="attr">display</span>: text,</span><br><span class="line">    <span class="attr">utf8Bytes</span>: encoder.<span class="title function_">encode</span>(text).<span class="property">length</span>,</span><br><span class="line">    <span class="attr">utf16Units</span>: text.<span class="property">length</span>,</span><br><span class="line">    <span class="attr">codePoints</span>: codePoints.<span class="property">length</span>,</span><br><span class="line">    <span class="attr">graphemes</span>: graphemes.<span class="property">length</span>,</span><br><span class="line">    <span class="attr">codePointList</span>: codePoints</span><br><span class="line">      .<span class="title function_">map</span>(<span class="function">(<span class="params">c</span>) =&gt;</span> <span class="string">`U+<span class="subst">$&#123;c.codePointAt(<span class="number">0</span>).toString(<span class="number">16</span>).toUpperCase().padStart(<span class="number">4</span>, <span class="string">&quot;0&quot;</span>)&#125;</span>`</span>)</span><br><span class="line">      .<span class="title function_">join</span>(<span class="string">&quot; &quot;</span>),</span><br><span class="line">  &#125;;</span><br><span class="line">&#125;</span><br><span class="line"></span><br><span class="line"><span class="variable language_">console</span>.<span class="title function_">log</span>(<span class="title function_">analyzeCharacter</span>(<span class="string">&quot;家族&quot;</span>, <span class="string">&quot;👨‍👩‍👧‍👦&quot;</span>));</span><br></pre></td></tr></table></figure></div>

<h3 id="実行環境と結果一覧">実行環境と結果一覧</h3><p>Node.js v20.16.0 で実行しました。結果は次のとおりです。表の「コードポイント数」は <code>[...text].length</code> と同じ数え方です。ただし、それを「人間が数える文字数」と呼べるとは限りません。ほかの環境で実行した場合、<code>Intl.Segmenter</code> が参照するUnicode&#x2F;ICUのバージョンによっては、新しい絵文字の分割結果が異なる可能性があります。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 標本 / 表示 / UTF-8 bytes / UTF-16 units / Code Points / Graphem"><table>
<thead>
<tr>
<th>標本</th>
<th align="right">表示</th>
<th align="right">UTF-8 bytes</th>
<th align="right">UTF-16 units</th>
<th align="right">Code Points</th>
<th align="right">Graphemes</th>
</tr>
</thead>
<tbody><tr>
<td>ASCII</td>
<td align="right">A</td>
<td align="right">1</td>
</tr>
<tr>
<td>ひらがな</td>
<td align="right">あ</td>
<td align="right">3</td>
<td align="right">1</td>
</tr>
<tr>
<td>合成済みのプ</td>
<td align="right">プ</td>
<td align="right">3</td>
<td align="right">1</td>
</tr>
<tr>
<td>フ + 結合半濁点</td>
<td align="right">プ</td>
<td align="right">6</td>
<td align="right">2</td>
<td align="right">1</td>
</tr>
<tr>
<td>合成済みのé</td>
<td align="right">é</td>
<td align="right">2</td>
<td align="right">1</td>
</tr>
<tr>
<td>e + 結合アクセント</td>
<td align="right">é</td>
<td align="right">3</td>
<td align="right">2</td>
<td align="right">1</td>
</tr>
<tr>
<td>𠮷（補助平面の漢字）</td>
<td align="right">𠮷</td>
<td align="right">4</td>
<td align="right">2</td>
<td align="right">1</td>
</tr>
<tr>
<td>顔</td>
<td align="right">😀</td>
<td align="right">4</td>
<td align="right">2</td>
<td align="right">1</td>
</tr>
<tr>
<td>日本国旗</td>
<td align="right">🇯🇵</td>
<td align="right">8</td>
<td align="right">4</td>
<td align="right">2</td>
<td align="right">1</td>
</tr>
<tr>
<td>肌色付きいいね</td>
<td align="right">👍🏻</td>
<td align="right">8</td>
<td align="right">4</td>
<td align="right">2</td>
<td align="right">1</td>
</tr>
<tr>
<td>男性技術者</td>
<td align="right">👨‍💻</td>
<td align="right">11</td>
<td align="right">5</td>
<td align="right">3</td>
<td align="right">1</td>
</tr>
<tr>
<td>女性宇宙飛行士</td>
<td align="right">👩‍🚀</td>
<td align="right">11</td>
<td align="right">5</td>
<td align="right">3</td>
<td align="right">1</td>
</tr>
<tr>
<td>虹の旗</td>
<td align="right">🏳️‍🌈</td>
<td align="right">14</td>
<td align="right">6</td>
<td align="right">4</td>
<td align="right">1</td>
</tr>
<tr>
<td>キス</td>
<td align="right">👩‍❤️‍💋‍👨</td>
<td align="right">27</td>
<td align="right">11</td>
<td align="right">8</td>
<td align="right">1</td>
</tr>
<tr>
<td>家族</td>
<td align="right">👨‍👩‍👧‍👦</td>
<td align="right">25</td>
<td align="right">11</td>
<td align="right">7</td>
<td align="right">1</td>
</tr>
<tr>
<td>キーキャップ 1</td>
<td align="right">1️⃣</td>
<td align="right">7</td>
<td align="right">3</td>
<td align="right">1</td>
</tr>
<tr>
<td>テキスト表示のハート</td>
<td align="right">♥︎</td>
<td align="right">6</td>
<td align="right">2</td>
<td align="right">1</td>
</tr>
<tr>
<td>絵文字表示のハート</td>
<td align="right">♥️</td>
<td align="right">6</td>
<td align="right">2</td>
<td align="right">1</td>
</tr>
</tbody></table></div>
<p>コードポイント列も実行時に確認しました。たとえば、<code>プ</code> は <code>U+30D7</code>、見た目がほぼ同じ <code>プ</code> は <code>U+30D5 U+309A</code>、家族は <code>U+1F468 U+200D U+1F469 U+200D U+1F467 U+200D U+1F466</code> です。6個の 😀 は <code>length === 12</code>、コードポイント数・書記素クラスタ数はともに 6 でした。</p>
<h2 id="参考文献・参考URL">参考文献・参考URL</h2><ul>
<li>wabi, 見た目は同じなのに検索でヒットしない：ファイルアップロード実装の落とし穴と設計を考える（本記事の着想元です。検索・正規化設計を主題とする発表でした）</li>
<li>Unicode Consortium, UAX #29: Unicode Text Segmentation（書記素クラスタの分割規則）</li>
<li>Unicode Consortium, UAX #15: Unicode Normalization Forms（NFC&#x2F;NFDなど）</li>
<li>Unicode Consortium, UTS #51: Unicode Emoji（絵文字シーケンス、ZWJ、Variation Selectorなど）</li>
<li>TC39, ECMAScript Language Specification: String type（ECMAScript文字列とUTF-16コードユニット）</li>
<li>MDN, String: length</li>
<li>MDN, Intl.Segmenter</li>
<li>MDN, String.prototype.normalize()</li>
</ul>
]]></content>
    <summary type="html">JavaScriptの length は「👨‍👩‍👧‍👦」を11と数えます。UTF-8バイト・UTF-16コードユニット・コードポイント・書記素クラスタの4つの数え方で絵文字や結合文字を測り、「1文字」が何を指すのかを確かめます。</summary>
    <category term="Frontend" scheme="https://future-architect.github.io/categories/Frontend/"/>
    <category term="JavaScript" scheme="https://future-architect.github.io/tags/JavaScript/"/>
    <category term="Unicode" scheme="https://future-architect.github.io/tags/Unicode/"/>
    <category term="文字列処理" scheme="https://future-architect.github.io/tags/%E6%96%87%E5%AD%97%E5%88%97%E5%87%A6%E7%90%86/"/>
  </entry>
  <entry>
    <title>Japan Datadog User Group Meetup#21@東京に、「全リクエストのレイテンシを保存する方針の検討」というテーマで LT 登壇しました</title>
    <link href="https://future-architect.github.io/articles/20260904a/"/>
    <id>https://future-architect.github.io/articles/20260904a/</id>
    <published>2026-09-03T15:00:00.000Z</published>
    <updated>2026-09-03T15:00:00.000Z</updated>
    <author><name>市川裕也</name></author>
    <content type="html"><![CDATA[<p>こんにちは、CSIG (Cyber Security Innovation Group) 所属の市川です。普段は脆弱性管理サービスの FutureVuls の開発・運用を担当しており、最近はパフォーマンス改善のリーディングをしています。</p>
<p>2026年8月26日(水)に開催された Japan Datadog User Group Meetup#21@東京 で、5 分間の LT をしてきたので、発表内容を軽くまとめておこうと思います。前回の #14@福岡 に続いて 2 回目の登壇です。</p>
<h2 id="発表内容">発表内容</h2><p>「全リクエストのレイテンシを保存する方針の検討」というテーマについて話しました。実際に導入した話ではなく、検討段階での共有及び相談という形で発表させていただきました。</p>
<h3 id="やりたかったこと">やりたかったこと</h3><p>「画面と API の両方を含む全リクエストのレイテンシを集計して、時間がかかっているリクエストについて分析をしたい」というのが出発点でした。この集計において、外せない要件が 2 つありました。</p>
<ol>
<li>複数のリクエストをまとめて 1 セッションとみなし、そのセッション全体の所要時間を計測したい</li>
<li>エンドポイントに付与されたパラメータ（例: <code>page</code> など）も一緒に取得して、フィルタ単位で集計したい</li>
</ol>
<img fetchpriority="high" class="bordered" src="/images/2026/20260904a/session-latency.png" alt="" width="511" height="493">

<p>この 2 つを Datadog の中だけ (例: ダッシュボードでの集計や、Endpoint 機能を利用したエンドポイント単位のレイテンシ集計など) で完結させるのは困難と考えました。特に要件1については、一度どこかにレイテンシの情報を保存したうえで、それらをまとめる集計ロジックを自前で組み、CI やローカルなど別の場所で実行するのが現実的です。</p>
<p>集計ロジックを自前で組む前提で考えた場合、これらの要件を実現するためには、<strong>自前のロジックでレイテンシを集計する際に情報を引っ張ってこられるよう、フィルタ情報を含めてレイテンシを一旦すべて保存できる場所</strong> が必要でした。</p>
<h3 id="考えられる実現方法">考えられる実現方法</h3><p>Datadog に集約する前提で考えると、やり方は大きく 2 つあると思っています。</p>
<ol>
<li>APM をフル活用する</li>
<li>Flex Logs に集約する</li>
</ol>
<p>順番に説明します。</p>
<h4 id="案①-APM-をフル活用する">案① APM をフル活用する</h4><p>保存については、次の 3 つを実施することで概ね全スパンを保持できます。</p>
<ul>
<li>ingestion rate と trace sample rate を 100% にする</li>
<li>トップスパンの retention rate を 100% にする</li>
<li>保存したいパラメータの情報 (例: <code>page</code> など) を、トップスパンの attribute に加える</li>
</ul>
<img class="bordered" src="/images/2026/20260904a/apm-span-attribute.png" alt="" width="1122" height="342" loading="lazy">

<p>パラメータが URL のクエリストリングに含まれている場合は勝手にスパンに付与されます。リクエストボディに入ってくる場合はアプリケーションのコード内でタグを付与する必要がありますが、いずれにせよスパンにフィルタ情報を持たせること自体は可能です。</p>
<p>以下のように、集計と検索用の API が用意されているため、保存した情報は API を通じて引っ張ってくることが可能です。</p>
<div class="code-block"><figure class="highlight bash"><input type="checkbox" id="code-wrap-14wuczj-1" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-14wuczj-1" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="comment"># 集計用</span></span><br><span class="line">curl -X POST <span class="string">&quot;api.datadoghq.com/api/v2/spans/analytics/aggregate&quot;</span></span><br><span class="line"><span class="comment"># 検索用</span></span><br><span class="line">curl -X POST <span class="string">&quot;api.datadoghq.com/api/v2/spans/events/search&quot;</span></span><br></pre></td></tr></table></figure></div>

<p>この案のメリットは、すでに APM を導入しているのであれば、その延長線上で始められる、ということです。</p>
<h4 id="案②-Flex-Logs-に集約する">案② Flex Logs に集約する</h4><p>2 つ目は、Flex Logs に構造化ログとして全件保存する方法です。</p>
<p>Flex Logs は、大量にあるが参照頻度は低いログ向けのティアで、今回のユースケースにもっとも合致するティアでした。詳しくは公式ブログをご覧ください。</p>
<div class="note-container note-info note-has-title"><div class="note-title"><span class="note-icon"></span>補足: Standard Logs と Flex Logs の違いについて</div><div class="note-body">

<p>Standard Logs はホットストレージで全機能が使える代わりに高価で、短期のトラブルシュート向けです。特に意識せずにログを保存した場合は、このティアに振り分けられます。</p>
<p>一方 Flex Logs は、コールド寄りのストレージとオンデマンド計算の組み合わせで、リアルタイム系の機能が使えない代わりに、安く長期保持でき、かつ高速な検索が可能です。</p>
<p>使い分けとしては、以下の画像のようなイメージです。</p>
<img class="bordered" src="/images/2026/20260904a/log-tier-usage.png" alt="" width="850" height="366" loading="lazy">

</div></div>

<p>保存の手順は、Flex Logs を有効化し、Flex Logs 用の Index を作成したうえで、その Index に振り分けられる attribute をログに付与する、という流れです。</p>
<p>検索のエンドポイントは Standard Logs と共通で、<code>filter.storage_tier</code> に <code>flex</code> を指定すると Flex ティアを検索できます。aggregate と search の両方に対応しているので、ログ取得の流れは案①とまったく同じです。</p>
<div class="code-block"><figure class="highlight bash"><input type="checkbox" id="code-wrap-14wuczj-2" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-14wuczj-2" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line"><span class="comment"># 集計用</span></span><br><span class="line">curl -X POST <span class="string">&quot;api.datadoghq.com/api/v2/logs/analytics/aggregate&quot;</span></span><br><span class="line"><span class="comment"># 検索用</span></span><br><span class="line">curl -X POST <span class="string">&quot;api.datadoghq.com/api/v2/logs/events/search&quot;</span></span><br></pre></td></tr></table></figure></div>

<h3 id="2-案の比較">2 案の比較</h3><p>2 案を並べると、こうなります。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 ① APM フル活用 / ② Flex Logs"><table>
<thead>
<tr>
<th></th>
<th>① APM フル活用</th>
<th>② Flex Logs</th>
</tr>
</thead>
<tbody><tr>
<td>コスト（オンデマンド）</td>
<td>$1.91 〜 $3.75 &#x2F; 1M spans &#x2F; 月</td>
<td>$0.9 &#x2F; 1M logs &#x2F; 月</td>
</tr>
<tr>
<td>保持期間</td>
<td>7 日 〜 30 日</td>
<td>3 か月 〜 15 か月</td>
</tr>
<tr>
<td>100% 保持の信頼性</td>
<td>中（tracer のレートリミッタや flush 失敗、巨大トレースの送信失敗などのリスクあり）</td>
<td>高</td>
</tr>
<tr>
<td>既存環境への副作用</td>
<td>あり（trace sample rate を 100% にすると、サービス全体の APM に影響が出る）</td>
<td>なし</td>
</tr>
</tbody></table></div>
<p>一番の争点は保持期間だと思います。1 か月以上情報を残したいのであれば Flex Logs の方が適しています。逆に、保持期間が短くて良いのであれば、APM を使用する形でも大きな問題はないと思われます。他の項目についても、Flex Logs の方が若干優れてはいますが、どちらでも問題ない範疇かと思います。</p>
<p>個人的には、以下の 3 つの理由より Flex Logs の方が今回のユースケースに適していると考えています。</p>
<ul>
<li>APM への副作用や、それに付随して発生するコストについて考慮しなくてよい</li>
<li>「ログに集約させる」方が直感的で分かりやすい（あくまで主観ですが）</li>
<li>今回のユースケースにおいては、Flex Logs にするデメリットがあまりない</li>
</ul>
<h2 id="おわりに">おわりに</h2><p>自分以外の方の発表だと、ALB ログとトレースを繋げる方法や、Datadog Cloud Cost Management による Datadog 自身のコスト分析の話が、特に興味深かったです。自社でも必要になるタイミングが来る可能性もあると感じたため、必要になったら導入したいです。当日の発表内容一覧は、JDDUG のブログ記事 から確認できます。</p>
<p>懇親会では、同じくアプリケーションのパフォーマンス改善を推進されている方と、優先度付けの方法などについても議論でき、実りの多い時間となりました。運営の皆様、会場を提供いただいた Wantedly 様、参加者の皆様、ありがとうございました。</p>
<p>また機会があれば、実際に Flex Logs を導入した後の話や、全然別のパフォーマンスの話も出来ればと思います。</p>
]]></content>
    <summary type="html">Japan Datadog User Group Meetup#21@東京 で「全リクエストのレイテンシを保存する方針の検討」というテーマで LT をしました。APM をフル活用する案と Flex Logs に集約する案を、コスト・保持期間・既存環境への副作用の観点で比較しています。</summary>
    <category term="DevOps" scheme="https://future-architect.github.io/categories/DevOps/"/>
    <category term="Datadog" scheme="https://future-architect.github.io/tags/Datadog/"/>
    <category term="オブサーバビリティ" scheme="https://future-architect.github.io/tags/%E3%82%AA%E3%83%96%E3%82%B5%E3%83%BC%E3%83%90%E3%83%93%E3%83%AA%E3%83%86%E3%82%A3/"/>
    <category term="ログ" scheme="https://future-architect.github.io/tags/%E3%83%AD%E3%82%B0/"/>
    <category term="登壇レポート" scheme="https://future-architect.github.io/tags/%E7%99%BB%E5%A3%87%E3%83%AC%E3%83%9D%E3%83%BC%E3%83%88/"/>
  </entry>
  <entry>
    <title>「レビューがしんどい」の正体を、認知的負債から考えてみた</title>
    <link href="https://future-architect.github.io/articles/20260903a/"/>
    <id>https://future-architect.github.io/articles/20260903a/</id>
    <published>2026-09-02T15:00:00.000Z</published>
    <updated>2026-09-02T15:00:00.000Z</updated>
    <author><name>小橋昌明</name></author>
    <content type="html"><![CDATA[<img fetchpriority="high" class="bordered" src="/images/2026/20260903a/top.jpg" alt="" width="600" height="600">

<p>夏休み自由研究連載 2026 の6本目です。</p>
<h2 id="はじめに">はじめに</h2><p>AI戦略推進G（AI Transformation Group）の小橋です。いまはめぐりめぐって最適化の業務を担当しています。</p>
<p>私がCursorによるAI駆動開発入門 を書いたのは2025年4月のこと。その後、AI駆動開発の波がフューチャーにも完全に到達しました。私が会社内で最初に使っていたのはGitHub Copilotですが、料金体系が従量課金制に移行した際にツールを移行し、8月からClaude Codeを使い始めたところです（ツール選択は全社一律というわけでは無く、私自身の移行は遅い方でした。人によってはその前からClaude Codeでゴリゴリ開発している人もいます）。</p>
<p>そんな中、私や周囲ではコードレビューをするのがしんどいという話が出てきました。コードを書くのが主業務になっているエンジニアは、生成AIの力を借りて今までよりも遥かに速くコードを書くことができますが、レビュワーはそうもいきません。この問題について、Technology Radar の中で見つけた「認知的負債」と絡めつつ考えてみたいと思います。</p>
<h2 id="レビューをするのがつらい原因">レビューをするのがつらい原因</h2><p>開発のボトルネックがコーディングからレビューに移行し、レビュワーの負担が増しているという話は、今年に入って多く見かけるものです。そのような記事の中から原因を見てみましょう。</p>
<h3 id="原因1：コード変更量が多い">原因1：コード変更量が多い</h3><p>LinearB の記事では、1つのPull Requestの行数が、AI不使用だと157行、AI支援ありだと408行、AIエージェントだとその間の293行となっています（p75 &#x3D; 小さい方から並べて75%の値）。上がってきたPRを見ようとしたときに、コードの変更規模が2倍以上だと、単純に労力がかかりますね。</p>
<h3 id="原因2：PR本文の説明が冗長">原因2：PR本文の説明が冗長</h3><p>コード自体に加えてPR本文にもレビューがつらい原因がありそうです。個人的には、ちょっとPRを開いて内容を確認しようとしたら、説明文の文章量に圧倒されて怖気づくことがありました。</p>
<p>GitHubの「エージェントが生成したPRをレビューする際のガイド」という記事 は主にレビュワー向けのことが書いてありますが、PRを提出する開発者に向けてもアドバイスが書いてあります。曰く、エージェントが作成したプルリクエストをオープンする前に、PRの本文を自分自身で編集しなさい。エージェントは自分が書いた変更内容を微に入り細を穿ち、詳細に全部説明してくる傾向があります。コードを見たほうが良く分かることでもPR本文に書いてきがちです。背景や文脈が必要な箇所に限って、diffにインラインコメントを付けるべきである……と。</p>
<p>今までコードレビューしてきた経験から言うと、AIは変更内容をよく記憶しているので、全ての変更をPRに載せてきます。さらにメリハリをつけず、すべてが同じ重要度であるかのように書きがちです。結果として、要点が分からない無駄に長いPR説明文になりがちという印象があります。思い切ってバッサリ内容を削るか、一旦担当者が自分で書いて（そうすれば自然と要点だけになる）その下にAIの長大コメントを添えるとかにするのが良いのかなと思います。</p>
<h3 id="原因3：間違っているコードが間違っていそうに見えない">原因3：間違っているコードが間違っていそうに見えない</h3><p>AIが一見綺麗で整ったコードを書いてくるせいで、間違っていることがすぐには発見できず苦労するという話です。AI製のコードには明白な間違いや不適切な命名が少なく、レビュワーは表面的な間違いではなく奥深くに潜んだ間違いを探す必要があるため、同じ量のコードをレビューする場合でもより注意深く見る必要があるでしょう。単純な量（行数）だけではなく、質的にもレビューはしんどいものに変化しているのでしょう。The AI Code Review Bottleneck, By the 2026 NumbersやCognitive Load in the AI Eraに記載があります。</p>
<h2 id="Technology-Radar-の「Codebase-cognitive-debt」を見る">Technology Radar の「Codebase cognitive debt」を見る</h2><p>AIのパワーにより、コードが桁違いの勢いで生成されるようになりました。その結果の1つが、今まで見てきたレビュワー側のしんどさです。そしてもう1つの帰結が、人間が本当に中身を理解しないうちに、コードだけがどんどん積み上がっていくという事態です。これがすなわち、認知的負債と呼ばれるものです。それでは、Technology Radar を見ていきましょう。</p>
<p>Codebase cognitive debt</p>
<h3 id="定義">定義</h3><p>本文では、定義は次のように書かれています。「コードの認知負債というのは、システムの実際の実装と、それがどのようになぜ機能しているのかというチームの共通理解との間に生じるギャップが増え続けることである」。これがあまりにも悪化し、ある限界に達すると、小さな変更を加えただけで予期しない障害が発生したり、バグ修正をしたつもりが他の部分でリグレッション（デグレ）を起こし始めたりする、そういう恐ろしい事態が起こると書かれています。</p>
<p>日本語による説明は例えば t_wada さんの「Agentic Software Engineering」のスライド などが良いと思います。</p>
<p>この問題がとりわけ色濃く出るのは、バグの検出の場面だと感じます。たとえば「この部分はバグではないか」とClaude Codeが指摘してくることがありますが、その指摘が正しいのかどうか、こちらには判断がつきません。人間の側にその挙動に関するメンタルモデルがないため、Claude Codeの言い分が正しいかどうかを判定できない、という問題です。</p>
<p>もし仮に、私たちが作っているソフトウェアの仕様や処理が、自分たちの脳みそのキャパシティに収まるものであれば、全く問題ありません。そのキャパシティの範囲でコードを認知し、把握すればよいだけの話になります。ただ実際には、私たちが作っているものは、脳みそのキャパシティに収まりきらないほど大きな規模であることがほとんどです。そうするとしっかりと腰を据えて、コードの中身についての理解を自分の中に育てていかなければいけません。</p>
<p>Cognitive Debt という概念が最初に提案されたのは、おそらく Margaret-Anne Storey という大学教授の記事でしょう。これは今年の2月に書かれた記事で、学生のチームが開発を進めていく途中で陥った事態について記載しています。</p>
<blockquote>
<p>しかし、7～8週目になると、あるチームが壁にぶち当たりました。単純な変更を加えるだけでも、予想外の不具合が発生しました。私が彼らと面談したとき、学生チームは技術的負債が問題の原因だと考えていました。汚いコード、下手なアーキテクチャ、性急な実装。しかしよく調べてみると、本当の問題が現れました。ある設計上の決定が何故なされたか、あるいはシステムの異なる部分がどうやって連携して動作しているのか、チームの誰も説明できなかったのです。コードは汚かったかもしれませんが、それ以上に問題だったのは、システムの中の理論やチームの共通理解が、完全にバラバラになってしまったことでした。</p>
</blockquote>
<p>この最初の記事がネット上で議論を巻き起こしたらしく、Storey教授は1週間ほど後に2番目の記事を書いています。技術的負債がコードの中の問題であるのに対して、認知的負債は人々の理解の中の問題であり、開発者の痛みとなって現れます。コードに変更を加えるときに自信が無くなる、レビューの負担増加、ストレスや疲労といった影響を引き起こします。あれ、レビューの話に戻ってきましたね。</p>
<h3 id="対策">対策</h3><p>Technology Radar の記事内では、対策として次の3つが挙げられています。</p>
<ul>
<li>コーディングエージェント向けのフィードバックセンサーの設置</li>
<li>チームの認知負荷のトラッキング（Team Cognitive Load）</li>
<li>アーキテクチャ適合度関数（Architecture Fitness Function）の活用</li>
</ul>
<p>「コーディングエージェント向けのフィードバックセンサー」とは持って回った言い方ですが、要するに、AIエージェントの結果を人間が見て軌道修正する、いわゆるhuman in the loopを少なくしたい、ということのようです。そのために、レビュー用のエージェントを導入して整備したり、コーディングエージェント自身が型チェックやリンターを呼び出してチェックできるようにしたりする、という話です。自動コーディングが回っている最中に、人間ではなく機械によるチェック機構を組み込むことで、人間が介入しなければならない箇所を減らそうという発想であり、これは納得感があります。</p>
<p>チームの認知負荷のトラッキングについては、正直なところこの概念が提唱された書籍『Team Topologies』を買ったきりで積んだままの状態なので、あまりよく分かっていません。Technology Radar からリンクをたどっていくと、開発者へのアセスメント、つまりアンケートを取ろうという話に見えます。開発やテスト、デプロイがどれくらい簡単にできるか、あるいは準備がどれくらい困難か、といった内容のアンケートのようです。ただ、こうしたアンケートで認知負荷が増大したことを検知できたとして、その後どう対処すべきかという部分こそ知りたいところだと感じます。</p>
<p>最後のアーキテクチャ適合度関数については、調べてもよく分かりませんでした。この語を提案したのが（Technology Radarを発行しているThoughtworks社のメンバーが書いた）「進化的アーキテクチャ」という本の中らしいので、バイアスがかかっている気がしなくもありません。</p>
<h2 id="ドキュメント">ドキュメント</h2><p>ここまでの議論から抜け落ちている重要な観点があると思っていて、それはドキュメンテーションです。私自身、ドキュメンテーション好き人間としては、人間がコードの実装を把握するための一番良い手段は適切なドキュメンテーションなのではないか、という疑問が湧いてきます。もちろん、そのドキュメントはAIが読んだり書いたりしやすいものであるべきでしょう。理想的なのはコードと同じリポジトリ内でmarkdownなどで管理する方式、すなわちDocs as Codeという話になるはずです。しかし、不思議なことにこのキーワードで検索してもあまり記事が出てきません。出てくるのは以下の記事くらいです。</p>
<p>https://www.m3tech.blog/entry/2026/03/12/115110</p>
<h2 id="おわりに">おわりに</h2><p>先ほどのGitHubの記事 でも、「レビュー用のCopilotを最初に実行して、明らかな誤りが無いかチェックしてもらいましょう」「クリティカルパスに絞って、入力から出力までを辿ってチェックしましょう」とのアドバイスがありました。人手によるレビューを極力減らして、AIにやってもらうこと、その精度を向上させることが大事なのでしょう。避けられない流れの中でソフトウェア品質をどう担保するか、もうしばらく考えてみたいと思います。</p>
]]></content>
    <summary type="html">AI駆動開発でコードレビューがしんどくなった原因を変更量・PR本文・間違いの見つけにくさの3つに整理し、Technology Radar の「Codebase cognitive debt（認知的負債）」と絡めて考えます。</summary>
    <category term="AIDD" scheme="https://future-architect.github.io/categories/AIDD/"/>
    <category term="Claude" scheme="https://future-architect.github.io/tags/Claude/"/>
    <category term="コードレビュー" scheme="https://future-architect.github.io/tags/%E3%82%B3%E3%83%BC%E3%83%89%E3%83%AC%E3%83%93%E3%83%A5%E3%83%BC/"/>
    <category term="生成AI" scheme="https://future-architect.github.io/tags/%E7%94%9F%E6%88%90AI/"/>
  </entry>
  <entry>
    <title>OSS監視ツールを活用してWebアプリのボトルネックを可視化してみた</title>
    <link href="https://future-architect.github.io/articles/20260902a/"/>
    <id>https://future-architect.github.io/articles/20260902a/</id>
    <published>2026-09-01T15:00:00.000Z</published>
    <updated>2026-09-01T15:00:00.000Z</updated>
    <author><name>高嶋ありさ</name></author>
    <content type="html"><![CDATA[<p>夏休み自由研究連載 2026 の5本目です。</p>
<h2 id="はじめに">はじめに</h2><img fetchpriority="high" src="/images/2026/20260902a/top.png" alt="" width="488" height="325">

<p>こんにちは、2026年7月にキャリア入社した高嶋です。夏休みの自由研究企画ということで、フューチャーに入社して初めてのブログを書きます。今回は、私が特に好きなテーマであるオブザーバビリティや興味のあったトレーシング技術を使って遊んでみました。</p>
<p>題材としてはISUCON10予選を使わせていただいています。選定理由は以下の3点です。</p>
<ol>
<li>ソースコードやAMIが公開されていて構築が容易</li>
<li>ボトルネックが作りこまれており可視化するのが楽しい</li>
<li>Webサーバ・アプリケーション・DBのシンプルな構成</li>
</ol>
<p>本記事ではオープンソースの監視ツールを用いてボトルネックを可視化した結果をご紹介します。</p>
<div class="note-container note-info"><span class="note-icon"></span><div>

<p>ISUCONとは、チームで制限時間内にWebアプリケーションの高速化を図り、性能スコアを競い合うプログラミング競技イベントです。</p>
</div></div>

<h2 id="可視化対象のアーキテクチャ">可視化対象のアーキテクチャ</h2><p>ベンチサーバとアプリサーバの2台構成で、アプリサーバにはnginx・Go・MySQLが載っています。また、ベンチを実行するとベンチサーバから各種エンドポイントへリクエストが投げられます。</p>
<p>今回はアプリサーバを対象に可視化を行いました。</p>
<img src="/images/2026/20260902a/image_2.png" alt="" width="1200" height="490" loading="lazy">

<p>インスタンス等の詳細です。matsuu&#x2F;aws-isucon が公開しているISUCON10予選のAMIを使っています。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 項目 / 値"><table>
<thead>
<tr>
<th>項目</th>
<th>値</th>
</tr>
</thead>
<tbody><tr>
<td>AMI</td>
<td><code>ami-03bbe60df80bdccc0</code>（ap-northeast-1）</td>
</tr>
<tr>
<td>OS</td>
<td>Ubuntu 18.04</td>
</tr>
<tr>
<td>インスタンスタイプ</td>
<td>c5.large（2 vCPU &#x2F; 4 GiB）</td>
</tr>
</tbody></table></div>
<h2 id="可視化内容の選定">可視化内容の選定</h2><p>トレーシングでミドルウェア間の遅延を見えるようにしたいと考えていたものの、遅延状況はアプリのエンドポイントによってまちまちです。そこでエンドポイントを横断した可視化と、特定のエンドポイントについてのトレーシングの2段構成で見ていくことにしました。</p>
<img src="/images/2026/20260902a/image_3.jpg" alt="" width="1920" height="1320" loading="lazy">

<div class="note-container note-warn"><span class="note-icon"></span><div>

<p>この方針では検知が難しい以下のようなケースもありますが、今回はスコープ外とします。</p>
<ul>
<li>nginxがリクエストを捨てているケース</li>
<li>特定のエンドポイントに依らずに問題が発生しているケース<ul>
<li>CPUやメモリ、ディスクI&#x2F;Oの枯渇、プロセス同士のリソースの取り合いなど</li>
</ul>
</li>
<li>同じエンドポイントでもレスポンスタイムに偏りがあるケース<ul>
<li>バッファプールが温まる前だけ遅い、GCのタイミングで跳ねるなど</li>
</ul>
</li>
</ul>
</div></div>

<h2 id="①エンドポイント別の遅延可視化">①エンドポイント別の遅延可視化</h2><p>以下のようなグラフを作成しました。</p>
<img src="/images/2026/20260902a/image_4.png" alt="" width="1292" height="481" loading="lazy">

<ul>
<li>X軸：レスポンスタイムの95パーセンタイル値（p95）</li>
<li>Y軸：そのエンドポイントのリクエスト数</li>
<li>丸のサイズ：そのエンドポイントのレスポンスタイムの合計</li>
</ul>
<p>3項目の関係がわかりやすいようにバブルチャートで表現しています。</p>
<p>丸のサイズは合計レスポンスタイム、つまりシステム全体の処理時間に対する影響を表しており、サイズの大きなエンドポイントほどチューニングした際の効果が大きいとみなせます。</p>
<p>たとえば一番右の丸は突出して遅いですが、リクエスト数はそこまで多くありません。一方で赤い丸はレスポンスタイムはそこそこですがリクエスト回数が多く、合計レスポンスタイムは大きくなっています。この場合、赤い丸を優先してチューニングすると良さそうです。</p>
<p>実アプリに置き換えて考えてみても、閲覧頻度が低くてとても遅いページを改善するより、閲覧頻度が高くそこそこ遅いページのチューニングをした方が全体的な満足度は上がりそうな気がします。</p>
<h3 id="アーキテクチャ">アーキテクチャ</h3><img src="/images/2026/20260902a/image_5.png" alt="" width="1920" height="835" loading="lazy">

<p>nginxのアクセスログをprometheus-nginxlog-exporterを用いて時系列メトリクスに変換し、Prometheusに取り込んでいます。またグラフはGrafanaで描いています。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 役割 / 使ったもの"><table>
<thead>
<tr>
<th>役割</th>
<th>使ったもの</th>
</tr>
</thead>
<tbody><tr>
<td>ログの出力</td>
<td>nginx 1.14（<code>log_format</code> をLTSVにして <code>$request_time</code> を出す）</td>
</tr>
<tr>
<td>アクセスログのメトリクス化</td>
<td>prometheus-nginxlog-exporter 1.11.0</td>
</tr>
<tr>
<td>収集・保存</td>
<td>Prometheus v3.14.0</td>
</tr>
<tr>
<td>可視化</td>
<td>Grafana 13.2.0</td>
</tr>
</tbody></table></div>
<p>ポイントは以下です。</p>
<p><strong>exporter側でパス正規化を行う</strong></p>
<ul>
<li><code>/api/estate/1234</code> のようなIDを含むパスをそのまま扱うと、1走行で1800種類以上のパスが出てバブルが数千個になってしまいます。prometheus-nginxlog-exporterのrelabel設定で <code>/api/estate/:id</code> のように畳むと15パスまで減りました。</li>
</ul>
<h2 id="②トレーシングで各ミドルウェアでの経過時間を可視化">②トレーシングで各ミドルウェアでの経過時間を可視化</h2><p>エンドポイント別の可視化で特に影響が大きいことが読み取れた <code>/api/estate/search</code> というエンドポイントについてトレーシングしてみました。</p>
<img src="/images/2026/20260902a/image_6.png" alt="" width="1200" height="450" loading="lazy">

<img src="/images/2026/20260902a/image_7.jpg" alt="" width="1920" height="960" loading="lazy">

<p>すると、GoからMySQLへ2回クエリを投げており、それらの実行時間が支配的であることがわかりました。ここで投げられているクエリのチューニングをすることで高速化ができそうです。</p>
<p>他のエンドポイントについてもみてみましょう。右のほうにある突出して遅いエンドポイント <code>/api/estate/nazotte</code> をトレーシングします。</p>
<img src="/images/2026/20260902a/image_8.png" alt="" width="1200" height="584" loading="lazy">

<img src="/images/2026/20260902a/image_9.jpg" alt="" width="1920" height="1182" loading="lazy">

<p>すると、GoからMySQLへ大量のクエリを投げていることがわかりました（図だと途中までしか映っていませんが、この下にもずっとSQLのスパンが続きます）。1つ1つのクエリにかかる時間は短いですが、件数が多いためトータルで見ると時間がかかっています。1回で済むはずのデータ取得が、ループの中で1件ずつ追加のクエリを発行してしまうことで「1 + N回」のクエリになってしまう、N+1問題と呼ばれるアンチパターンが発生しているように見えます。</p>
<p>このようにトレーシングを行うことで、nginx・Go・MySQLのどこにボトルネックがあるのかを直感的に確認できました。</p>
<h3 id="アーキテクチャ-1">アーキテクチャ</h3><img src="/images/2026/20260902a/image_10.png" alt="" width="1920" height="1108" loading="lazy">

<p>GoアプリケーションをOpenTelemetryで計装し、Tempoへスパンを送信しています。トレースの表示はGrafanaで行っています。</p>
<div class="scroll" tabindex="0" role="region" aria-label="アーキテクチャの表 役割 / 使ったもの"><table>
<thead>
<tr>
<th>役割</th>
<th>使ったもの</th>
</tr>
</thead>
<tbody><tr>
<td>トレースを受信、保存</td>
<td>Tempo 3.0.3</td>
</tr>
<tr>
<td>可視化</td>
<td>Grafana 13.2.0</td>
</tr>
</tbody></table></div>
<p>Go側に追加したモジュールは、数が多くなるので役割ごとに3つだけ挙げます。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 モジュール / バージョン / 役割"><table>
<thead>
<tr>
<th>モジュール</th>
<th>バージョン</th>
<th>役割</th>
</tr>
</thead>
<tbody><tr>
<td><code>go.opentelemetry.io/otel</code> &#x2F; <code>otel/sdk</code></td>
<td>v1.45.0</td>
<td>トレーサとSpanProcessorの本体</td>
</tr>
<tr>
<td><code>go.opentelemetry.io/otel/exporters/otlp/otlptrace/otlptracegrpc</code></td>
<td>v1.45.0</td>
<td>TempoへのOTLP&#x2F;gRPC送信</td>
</tr>
<tr>
<td><code>github.com/XSAM/otelsql</code></td>
<td>v0.43.0</td>
<td><code>database/sql</code> のラッパ</td>
</tr>
</tbody></table></div>
<p>ポイントは以下です。</p>
<p><strong>nginxのスパンはGoが代理で作る</strong></p>
<ul>
<li>nginx 1.14はOpenTelemetryに対応していないので、そのままではnginxのバーが出ません。Goへリクエストをプロキシするときに <code>X-Request-Start</code> というヘッダで時刻を渡し、Go側でその時刻を開始時刻とするスパンを作成しています。<ul>
<li>nginx 1.25.3から公式のOpenTelemetryモジュールが使えるためバージョンを上げてもよかったかもしれません…</li>
</ul>
</li>
</ul>
<p><strong>MySQLのスパンもGoが代理で作る</strong></p>
<ul>
<li>SQLドライバを <code>XSAM/otelsql</code> でラップするとSQL1本ごとにスパンが作られます。ただしotelsqlは渡された <code>context</code> から親スパンを探すため、<code>db.Get</code> のようなcontextを取らない呼び出しを <code>db.GetContext(ctx, ...)</code> のように書き換えました。<ul>
<li>MySQLもEnterprise Edition 8.1.0以降であればOpenTelemetryに対応していますが、Community Editionには無い機能です。</li>
</ul>
</li>
</ul>
<p><strong>注意</strong></p>
<p>ISUCON10予選アプリのGoは1.14.7で現行のOpenTelemetry SDKがビルドできないため、Go 1.27に上げてから計装しています。また、Echo v3系では公式の計装ライブラリ otelecho（v4専用）が使えないため、HTTPのスパンを作るミドルウェアを自作しました。</p>
<p>正直なところ、自分で実装するのであればここまで手を入れなければならない時点で挫折していましたが、今回はClaude Codeが頑張ってくれました。ミドルウェアのバージョンによってはもっと楽になると思います。</p>
<h2 id="さいごに">さいごに</h2><p>やはり見えなかったものが見えるようになるのはとても気持ちがいいと思いました！本記事ではミドルウェア内の話や、トレーシングに現れないボトルネック、時間経過での変化については触れませんでした。今後、それらについても可視化したいと考えています。</p>
<p>また、対象の設計や特性を知ること、どのような状態を検知したいのかという目的を明確にすることの重要性を改めて認識しました。ボトルネックの可視化を目的にするのであれば、ボトルネックとなりやすい箇所やそれを示す指標、それがどのような粒度で現れるのかを知っておく必要があります。これは今回の目的に限らず監視全般に言えることだと思います。</p>
<h2 id="参考">参考</h2><ul>
<li>ISUCON10 予選（isucon&#x2F;isucon10-qualify）</li>
<li>matsuu&#x2F;aws-isucon — 歴代ISUCONの公開AMI</li>
<li>prometheus-nginxlog-exporter</li>
<li>OpenTelemetry Go</li>
<li>XSAM&#x2F;otelsql</li>
<li>Grafana Tempo</li>
</ul>
]]></content>
    <summary type="html">ISUCON10予選のアプリを題材に、Prometheus・Grafana・OpenTelemetryといったオープンソースの監視ツールでWebアプリのボトルネックを可視化してみました。エンドポイント別の遅延と、ミドルウェアをまたぐトレーシングの2段構えで見ていきます。</summary>
    <category term="DevOps" scheme="https://future-architect.github.io/categories/DevOps/"/>
    <category term="Go" scheme="https://future-architect.github.io/tags/Go/"/>
    <category term="Grafana" scheme="https://future-architect.github.io/tags/Grafana/"/>
    <category term="OpenTelemetry" scheme="https://future-architect.github.io/tags/OpenTelemetry/"/>
    <category term="オブサーバビリティ" scheme="https://future-architect.github.io/tags/%E3%82%AA%E3%83%96%E3%82%B5%E3%83%BC%E3%83%90%E3%83%93%E3%83%AA%E3%83%86%E3%82%A3/"/>
  </entry>
  <entry>
    <title>AI時代のデータガバナンスを再考</title>
    <link href="https://future-architect.github.io/articles/20260901a/"/>
    <id>https://future-architect.github.io/articles/20260901a/</id>
    <published>2026-08-31T15:00:00.000Z</published>
    <updated>2026-08-31T15:00:00.000Z</updated>
    <author><name>真野隼記</name></author>
    <content type="html"><![CDATA[<img fetchpriority="high" src="/images/2026/20260901a/top.jpg" alt="" width="1200" height="655">

<p>夏休み自由研究連載 2026 の4本目です。</p>
<h2 id="はじめに">はじめに</h2><p>TIG DX所属の真野です。</p>
<p>2026年7月に公開した、データガバナンス設計ガイドライン の派生物です。</p>
<p>大AIエージェント導入ブームがやってきました。その地ならしとして、データマネジメントもセットで整備しようという流れがあります。ここでどこまで本質的にデータを整えられるかが、企業にとって今後の勝負の分かれ目になるでしょう。</p>
<p>ところで、データガバナンスを定石に従って検討していくと、大半が構造化データの扱いに目が向きがちです。データマネジメントの標準体系であるDMBOKでも、非構造データをメインに扱うのは、11の知識領域のうち「ドキュメントとコンテンツ管理」の1領域だけです。</p>
<p>一方で、AIエージェントに業務をさせるには、業務フロー、判断基準、社内用語の意味といった暗黙知が要ります。こうした情報はデータベースではなく、PowerPointやExcelなどの社内文書やチャット・メールに含まれていたり、そもそも言語化されていない場合も多いです。</p>
<p>構造化データと、社内文書などの非構造データに、改めてどういう力点・順番で取り組むべきでしょうか？ 他にもいくつか論点があります。ここでは論点を3つに絞り再考します。</p>
<h2 id="【問い1】構造化データからか？-非構造データからか？">【問い1】構造化データからか？ 非構造データからか？</h2><p>単純にどっちから進めるべきか話す前に、少し問題を整理します。</p>
<ul>
<li><strong>構造化データを整備するとは？</strong><ul>
<li>販売計画、売上実績、生産計画、製造原価といったSystem of Record由来のファクトデータを、AIが使いやすい形で保管するということ</li>
</ul>
</li>
<li><strong>非構造データを整理するとは？</strong><ul>
<li>AIにコンテキストを上手く与え、業務内容を理解してもらうこと</li>
</ul>
</li>
</ul>
<p>事業目的や業務内容を理解したAIでも、正しい受注実績が取得できなければ、業務利用に耐えられる判断はできません。逆に、ファクトデータだけが揃っていても、業務の文脈を知らないAIには「どのデータを、どんなルールで見ればよいか」が分かりません。片方だけやれば成果が出る関係では当然ながら無いため、限られた体制でどういう濃淡で力点を置いていくかという話になります。</p>
<p>問い自体もアップデートすると、AIに良い判断をさせるために必要な要素は何か？ から分解して、必要な要素を順序立てて揃えていく話になります。おそらく、必要なファクトデータやそのメタデータを揃え、AIが必要十分にアクセスできる権限設計あたりからが手堅いでしょう。業務ルール？プロンプトに書き殴って動かすところから検証すれば良いのです。</p>
<h3 id="非構造データの難しさとは">非構造データの難しさとは</h3><p>まず前提として、非構造ファイルの管理はAI以前から存在します。情報資産管理のルールや部署ルール(このフォルダにこの種のファイルを置く、作成中のものは「_作成中」を付ける、など)といった形で、非構造データにもすでに規約はあるわけです。ないのは、それを機械が読める形に格上げする仕組みです。</p>
<p>では非構造データを一括りに「難しい」と言ってよいかというと、一概にそうではありません。データが <strong>誰に帰属するか</strong> で並べてみると、レベル感がまちまちだと分かります。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 対象 / 例 / 帰属先 / 基盤への載せ方 / 想定するガバナンスの難易度"><table>
<thead>
<tr>
<th>対象</th>
<th>例</th>
<th>帰属先</th>
<th>基盤への載せ方</th>
<th>想定するガバナンスの難易度</th>
</tr>
</thead>
<tbody><tr>
<td>構造化データ</td>
<td>売上実績、原価、生産計画</td>
<td>業務システム</td>
<td>そのまま管理</td>
<td>低</td>
</tr>
<tr>
<td>トランザクション帰属の非構造データ</td>
<td>検査画像、帳票スキャン</td>
<td>業務トランザクション</td>
<td>ポインタ+メタデータ</td>
<td>中</td>
</tr>
<tr>
<td>組織帰属の非構造データ</td>
<td>提案書、設計書、議事録、マニュアル</td>
<td>部・チーム</td>
<td>正本管理+抽出</td>
<td>高</td>
</tr>
<tr>
<td>個人帰属の非構造データ</td>
<td>チャット、メール</td>
<td>個人</td>
<td>原則そのまま載せない</td>
<td>超高</td>
</tr>
</tbody></table></div>
<p>表の通り、非構造データの難易度はどこに帰属するかでも決まります。</p>
<ul>
<li><strong>トランザクション帰属の非構造データ</strong><br>実は構造化データの親戚です。工場ラインの検査画像は「検査」というトランザクションの産物なので、検査IDや日時、ライン、判定結果というメタデータが自然に付きます。DBにはポインタとメタデータを置き、実体はオブジェクトストレージに置けば、構造化データのガバナンスにほぼ相乗りできます。</li>
<li><strong>組織帰属の非構造データ</strong><br>提案書やマニュアルはチームの成果物であり、おそらく作成した個人ではなく部門に紐づきます。ここから企業独自の考え方・ルール・業務フローを抽出できるかが、AI活用の勝負どころだと思っています。ただし現実のフォルダは「_最終_v2_修正済」が乱立し、同じ規程のコピーが部署ごとに散らばり、3年前のマニュアルが最新版として参照されたりします。RAGの前処理として、正本の置き場、ステータスの命名、オーナーの明示といった最低限のドキュメントガバナンスが要ります。つまり、先ほどの「すでにある規約」を機械可読に格上げする仕事がここに来ます。</li>
<li><strong>個人帰属の非構造データ</strong><br>チャットやメールは、個人への紐づきが強すぎます。プライベートの雑談や、その場だからこそ言えた発言が混ざるためです。利用規約や労務の論点以前に、心理的に受け入れにくいはずです。さらに言うと、監視されていると感じた瞬間に人は書かなくなるので、チャットをAIに読ませて暗黙知を得ようとすると、その源泉が枯れて本末転倒になりそうです。ここは「原則やらない」から始めるのが良いと考えていますが、第三の道は後述します。</li>
</ul>
<p>同じ組織帰属でも扱いやすさに差があります。設計書や仕様書はシステム側に揃っていて、従来からデータカタログのテクニカルメタデータやビジネスメタデータのインプットでした。そのため、設計書からメタデータへの変換をAIに行わせて基盤へ振り下ろす、という関係になるでしょう。「売上」という言葉に社内で複数の定義がある、といった<strong>意味の揺れ</strong>も、この素材からセマンティックレイヤーを整備するという流れが考えられそうです。</p>
<p>難しいのは、業務の判断基準やドメイン知識(オントロジーやナレッジグラフに落とし込みたいもの)で、こちらは事業部門のドキュメントやベテランの頭の中に眠っています。同じ「非構造の社内文書」でも、基盤側で閉じて取り組めるものと、事業部門に散らばっていて手が届きにくいものがあるので、本来はこの2つも区別したほうが良いでしょう。</p>
<div class="note-container note-tip note-has-title"><div class="note-title"><span class="note-icon"></span>AI-Readyな社内文書管理と従来型の違い</div><div class="note-body">

<p>人間の新人なら、ドキュメントが主要な業務の7〜8割をカバーしていれば上々で、分からないことがあると「これは最新ですか」などと自発的に質問してくれます。</p>
<p>AIの場合は欠けている部分を質問せず、憶測で作業を続けてしまい、精度を下げる要因となることが多いでしょう。つまり「だいたい書けば、あとはOJTで」は成立せず、何らかの理由で文書化するコスパが悪いロングテールをどう埋めるかという問題が残ります。ロングテールを人手でやり切るのは現実的ではないので、最終的にはメタデータの収集や下書きをAI自身に行わせて、人は確認に回る形になると思っています。もちろん、ロングテールの例外処理は引き続き人間が行う、というのは1つの方針ではあります。</p>
</div></div>

<h3 id="構造化データからか？-非構造データからか？-の答え">構造化データからか？ 非構造データからか？ の答え</h3><p>ここまで踏まえた上で、構造化データ・非構造データのどちらから整備すべきか？の見解です。</p>
<ul>
<li>着手は表の帰属順の浅い方から。構造化データ → トランザクション帰属の非構造データ → 組織帰属の非構造データ。個人帰属は後回し。難易度もそうですし、費用対効果も出やすいと思うためです</li>
<li>ただし、組織帰属の非構造データのRAG・ナレッジDB化はそこまで実験コストが大きくないので、基盤整備と並行して試すのもありかと思います。とはいえ、出力品質などの課題が出てからの方がゴールが明確になるとは思います</li>
</ul>
<h2 id="【問い2】AIに使わせる側の統制は何からやるべき？">【問い2】AIに使わせる側の統制は何からやるべき？</h2><p>AIに使わせる側の論点は、たとえばこういうものです。RAGを全社中央にひとつ構えるか、部門ごとに持たせるか。中央に置くと統制しやすい反面、業務の文脈が薄まります。部門ごとに置くと文脈は濃くなりますが、管理されないRAGが乱立しがちです。SaaS組み込みエージェントを使ってもよいか？棲み分けは、データがそのSaaSの中で完結する業務はSaaS側、部門横断が必要な業務はデータ基盤側、という整理が出発点になりそうです。</p>
<p>こうした論点は色々ありますが、何からやるべきかと問われれば、まずは「AIを試して学ぶを推奨すべきか、統制を取るべきか」の方針を決めることだと考えています。以降で深掘りします。</p>
<h3 id="AIを試して学ぶを推奨すべきか、統制を取るべきか">AIを試して学ぶを推奨すべきか、統制を取るべきか</h3><p>AIに使わせる側の統制をどうするか、苦慮している組織は多いです。試して学ぶを推奨することで、PoCの乱立を心配する方もいるはずです。試させれば「本番データを早くつなぎたい」という要望だけが強くなり、統制する側が対応に四苦八苦します。チームごとにエージェントもモデルもオーケストレーションツールもばらばらで、監査ログが揃っているかも分かりません。アクセスが急に増えて、基幹システムに想定外の負荷がかかる心配もあります。</p>
<p>かといって、個別案件をひとつずつ審査する許可制は、詰まりやすく、遅く、そして申請する側に不満が溜まります。だれも好き好んで恨まれたくないです。あるべき道は、あらかじめ承認済みのゴールデンパスを敷いておき、道の上は申請不要、道を外れるときだけ審査する形だと思っています。</p>
<ul>
<li><strong>サンドボックス</strong>: マスキング済みデータと、承認済みのモデルとエージェント実行環境。申請不要で誰でも試せるなど</li>
<li><strong>読み取り専用</strong>: レプリカ経由で本番データを参照できる。軽い届出で可。基幹システムへの負荷はレプリカとゲートウェイのレート制御で吸収するなど</li>
<li><strong>チェックゲート</strong>: 本番接続、書き込み、自動実行。ログ、権限、オーナーを付けた上で昇格を審査する場も検討する</li>
</ul>
<p>見落とされがちなのは、サンドボックスに置くデータの整備です。古い断片データしかない環境では、試しても有効な学びになりません。しかし、サンドボックスに本番に近い鮮度と整合性を持つデータを置くなら、万が一の流出を考えて、サンドボックスの利用にも制限を設けたくなります。適切なマスキング済みデータセットをどう用意するかが鍵です。もし、最新データが無いダミーデータばかりですと、そのサンドボックス環境はおそらくほぼ使われません。ジレンマです。</p>
<p>テストデータの整備がプロダクト開発の土台であるのと同じ意味で、これはAI時代のデータ利活用戦略の重要な作業になると考えています。考えるだけでめちゃくちゃ大変そうで辛い感じです。ゴールデンパスを準備すれば解決です、といった簡単な話ではなく、推進力が試されます。</p>
<h2 id="【問い3】権限設定は依然として関門であり、どうすれば広げられるのか">【問い3】権限設定は依然として関門であり、どうすれば広げられるのか</h2><p>AIにアクセス権限を付与しないと何も動きませんが、すべてを見せて良いわけではないのは普遍的ですので、ここは引き続き大きな論点です。</p>
<p>セキュリティの鉄則は最小権限の原則です。必要な人に、必要なものだけ、必要な期間だけ。一方でデータ民主化やAI活用の要求は逆です。部署を横断して広く読めなければ、横断的な業務改革も、組織の全体像を踏まえたAIの回答も生まれません。この綱引きが、権限設計のジレンマです。</p>
<p>現実の大企業では、ほぼ確実に細かく制御しているのではないでしょうか。長年の運用でアクセス制御には、退職者の残骸、兼務のための例外付与、プロジェクト単位の場当たり設定が積もっています。だから「既存の権限設定を流用するか、再設計するか」が論点に上がるわけですが、流用でよいのは既存の権限設計が信頼できる場合だけで、この論点が上がる時点でたいてい信頼できません。</p>
<p>では再設計して広げましょう、と言っても進まない理由があります。各事業部がデータオーナーとして権限申請の可否を判断する構図では、広げて得をするのは利用者側で、事故のときに詰められるのはオーナー側だからです。データ流出が起きれば「なぜ全社員向けの緩い設定にしたのか。重要ならもっと閉じておけばよかったのに」と後から言われかねません。また、事故は目立ちますが、広げたおかげで生まれた価値は誰にも見えません。この非対称性の下では、合理的なオーナーは今まで通りの縄張りで権限を設定する方向に倒れます。その結果、データ基盤はできたのに今まで通りのことしかできず、「何のためにやっているんだ」という状態に落ちます。</p>
<p>つまりこれは、オーナー側のやる気とか勇気の問題ではありません。仕組みの問題です。</p>
<h3 id="公開範囲を広げるための3つの仕組み">公開範囲を広げるための3つの仕組み</h3><p>非対称性を潰すには、3点をセットで入れるのが良いと思っています。従来から言われている一般論に近しいポイントです。</p>
<ul>
<li><strong>お墨付き</strong><br>リスクを取ってよいという基準を明文化し、経営名義で出します。具体的には、データ分類(公開、社内、機微、極秘など)を再定義した上で、「機微・極秘に該当しないものは社内公開がデフォルト」という原則を掲げる形です。ポイントは「開けてよい」ではなく「閉じる側に理由を書かせる」への反転で、挙証責任を移動させます。事故が起きたときに個人を詰めない、と先に宣言しておくことまで含めてお墨付きです。リスクをデータマネジメント側が引き取るとも言え、中々スパイシーです。</li>
<li><strong>監査ログ</strong><br>誰が、いつ、何を、何の目的でアクセスしたかを残します。利用申請と利用ログのセットがあるから開けられる、という順序です。ここでひとつ指摘したいのは、AIエージェント経由のアクセスは、人間の閲覧よりも構造的に監査しやすいことです。人が画面で見て記憶する行為はログに残せませんが、エージェントのツール呼び出しは全件記録できます。「AIに読ませるのは怖い」という直感とは逆に、監査可能性の面ではAI経由のほうが統制しやすい面があります。ログは、事故時の説明可能性を担保して個人の責任を薄める仕組みです。</li>
<li><strong>可視化</strong><br>データカタログで、部署ごとの公開状況を客観的に見せます。ある部署はデータ種別の8〜9割を公開していて、別の部署は1割しか公開していない、という事実が並べば、「なぜ少ないのか」は自然に問われます。オーナーシップへの健全な刺激になりますが、公開率を評価指標にした瞬間、中身のないメタデータや形だけの公開が量産されるので、あくまで事実の可視化に留めるのが良いと思います。可視化は、「広げても得しない」問題に評判というリターンを作る仕組みです。</li>
</ul>
<p>まとめると、お墨付きがリスクを経営に引き取らせ、ログが個人の責任を薄め、可視化がリターンを作るという感じです。</p>
<h3 id="ガバナンスの仕事をAIにやらせる">ガバナンスの仕事をAIにやらせる</h3><p>ところが、前節の処方箋には抜け道があります。閉じる側に理由を書かせても、分類する権限がオーナーにある限り、詰められたくないオーナーの合理的な逃げ道は <strong>すべてを機微に分類すること</strong> です。組織的なデータリテラシが成熟しないと、どうしても慎重になります。本当に機微じゃないデータなんて存在するの？と考えるとうーんとなりますしね。</p>
<p>しかも分類やメタデータ付与は、データガバナンスの中で誰もやりたがらない最大のボトルネックです。ビジネスメタデータをカタログに手入力してもらう運用は、私の知る限りなかなか成り立ちません。</p>
<p>そのため、将来的にはガバナンスの仕事をAIにやらせる方向に進むでしょう。</p>
<ul>
<li><strong>分類</strong>: 公開区分のルールを定義して、AIに一次判定させます。たとえば、個人情報を含むもの、ユーザーの同意範囲を外れる使い方になるもの、購入データでライセンス上二次利用できないもの、未公開の財務情報に該当するものは狭く。個人情報がなく、ライセンス上使えて、自社に知財があるものは広く、という要領です</li>
<li><strong>メタデータ</strong>: 設計書、仕様書、ダッシュボードといった既存の資料からAIがメタデータの下書きをかき集め、人間は最後の承認だけを行います。問い1で書いた「ロングテールは人手ではやり切れない」問題の答えがこれです</li>
</ul>
<p>人がやるべき仕事は、個々の分類ではなく「AIが区別しやすい分類ルールとは何か」を考えることに変わります。そして責任の所在も変わります。分類の責任は個々のオーナーから、分類ロジックを担保するデータ基盤側へ移り、そのロジックを経営が承認する形になります。お墨付きの対象が、個別の判断からロジックそのものに変わるわけです。人は個別判断で詰められますが、経営承認されたロジックに従った結果では詰められません。</p>
<div class="note-container note-tip note-has-title"><div class="note-title"><span class="note-icon"></span>集めると機微となるデータ</div><div class="note-body">

<p>たとえば営業の受注データや工場の生産予定は、1件ずつは機微ではなくても、大量に集計すると業績が推定できてしまい、未公開の財務情報に近づきます。個々の権限判断がすべて正しくても、集合が機微になるわけです。ゲートウェイでの出力チェックや、短時間に大量へ読み出す振る舞いの検知が部分的な対策となりそうです。このあたり、どうすべきかは今後のテーマになりそうだなと思います。</p>
</div></div>

<h2 id="データの帰属は可変的である">データの帰属は可変的である</h2><p>問い1で整理した帰属レイヤーは、データを静的に分類する枠のように見えます。しかし知識は帰属を移転します。個人のチャットでの気づきが議事録になり、部門のマニュアルになり、全社の規程になっていく。この流れを見ると、ガバナンスの仕事は帰属の判定ではなく、<strong>個人の知を組織の正本へ昇格させるプロセスの設計</strong> なのではないかと思えてきます。</p>
<p>これは問い1で「原則やらない」としたチャットの問題に、第三の道を開きます。チャットをAIに読ませて暗黙知を吸い上げるのではなく、AIが昇格候補を見つけて「この議論、ナレッジ化しませんか」と提案し、本人が承認したものだけが組織帰属へ昇格する形です。監視ではなく提案なので、萎縮効果を避けながら暗黙知を回収できます。運用に慣れて精度が上がれば、承認を省略できる範囲も広がっていくはずです。</p>
<p>正直に書くと、ここは私もまだ実装しきれていません。まとめるボットを作ること、昇格先とプロセスを設計すること、現場に「ここに知識を集める」と浸透させること。どれも地道な壁です。ただ、これを早く取り入れた企業とそうでない企業では、組織の知識がAIに使える形で貯まる速度に差がついていくと考えています。</p>
<h2 id="Governance-as-Code-来るか？">Governance as Code 来るか？</h2><p>ルールの管理そのものにも同じ流れが来ると考えています。データガバナンスを三権分立になぞらえると、ルールを定める立法と、運用を監査する司法がガバナンスで、実装して運用する行政がデータマネジメントです。</p>
<p>立法の中身は今はたいてい自然言語の文書で管理されていて、変更の経緯がクローズドなため、従う側から見ると「なんでこんな面倒くさいことをやるのか」が分からないままルールだけが提示されます。できれば無視できないかと常に考えます。</p>
<p>ソフトウェア開発がソースコードでやっているように、ガバナンスのルールもコードとして差分管理できれば(governance-as-code)、v1.0からv1.1への差分と議論の経緯、それに伴う基盤設定の変更までがつながって見え、従う側の納得感が上がります。ガバナンス自体の透明化や可視化が求められる時代です。背景が分かるとAIの追随もしやすそうです。新時代の幕開けかもしれません。</p>
<h2 id="まとめ">まとめ</h2><p>主張のまとめです。</p>
<ol>
<li>ファクトデータ、非構造は帰属の浅い、扱いやすいものから整えよう</li>
<li>AI利用は個別審査ではなく、サンドボックスと本番利用のための条件を準備しよう</li>
<li>権限は精神論ではなく仕組みで広げよう</li>
</ol>
<blockquote>
<p>AIが素案を提案し、人が承認し、経営がロジックを引き取る。</p>
</blockquote>
<p>…という話をしましたが、AI駆動開発と同様に人間の役割が、作業者から承認者へ、さらに承認基準の設計者へと一段ずつ上にあがっていきます。AI時代のデータガバナンスも抽象度が上がり、仕事は一時的にはむしろ増えてきそうです。がんばりましょう。</p>
<p>最後まで読んでいただき、ありがとうございました！</p>
]]></content>
    <summary type="html">AIエージェント導入を見据えたデータガバナンスの論点を3つに絞って再考します。構造化データと非構造データのどちらから整備するか、AIに使わせる側の統制、権限をどう広げるかを扱います。</summary>
    <category term="DataEngineering" scheme="https://future-architect.github.io/categories/DataEngineering/"/>
    <category term="AIエージェント" scheme="https://future-architect.github.io/tags/AI%E3%82%A8%E3%83%BC%E3%82%B8%E3%82%A7%E3%83%B3%E3%83%88/"/>
    <category term="データガバナンス" scheme="https://future-architect.github.io/tags/%E3%83%87%E3%83%BC%E3%82%BF%E3%82%AC%E3%83%90%E3%83%8A%E3%83%B3%E3%82%B9/"/>
    <category term="データマネジメント" scheme="https://future-architect.github.io/tags/%E3%83%87%E3%83%BC%E3%82%BF%E3%83%9E%E3%83%8D%E3%82%B8%E3%83%A1%E3%83%B3%E3%83%88/"/>
  </entry>
  <entry>
    <title>スケジューリングをAIに任せてみたら、仕事の進め方ごと変わった話</title>
    <link href="https://future-architect.github.io/articles/20260831a/"/>
    <id>https://future-architect.github.io/articles/20260831a/</id>
    <published>2026-08-30T15:00:00.000Z</published>
    <updated>2026-08-30T15:00:00.000Z</updated>
    <author><name>片岡久人</name></author>
    <content type="html"><![CDATA[<img fetchpriority="high" src="/images/2026/20260831a/top.jpg" alt="" width="1024" height="559">

<p>夏休み自由研究連載 2026 の3本目です。</p>
<h2 id="はじめに">はじめに</h2><p>こんにちは。製造エネルギーグループの片岡久人です。</p>
<p>テーマは <strong>「スケジューリングをAIに任せられないか」</strong> です。やってみたところ、任せること自体はおおよそできたのですが、できあがったものは、当初やりたかったこととは少し違うところに着地しました。結論としては、スケジュールを組ませるために文脈を溜めていったら、<strong>スケジュール以外の仕事もAIに渡せるようになっていた</strong>、という話になります。</p>
<p>そこに至るまでに、何が足りなくて、何を足して、次に何が見えたのか。その順番で書いていこうと思います。できあがった仕組みそのものは、付録にまとめました。</p>
<p>最小構成で始める手順も、後ろのほうに書いています。フォルダ2つとMarkdown 1枚だけなので、よければ試してみて、感想などもらえるとうれしいです。</p>
<h2 id="前提">前提</h2><p>使っているのは、次の2つだけです。</p>
<ul>
<li><strong>Obsidian</strong> — Markdownを書くためのエディタ。実体はただのテキストファイル群で、プラグインは入れていません</li>
<li><strong>Claude Code</strong> — ローカルのファイルを読み書きできるAIのCLI（Claudeの契約があれば、追加の費用はかかりません）</li>
</ul>
<p>どちらも特殊な使い方はしていないので、バージョンによる違いはあまり気にしなくて大丈夫です。ファイルの置き場所も、手元のフォルダであれば何でも構いません。</p>
<p>Markdownが書ければいいので、エディタはVS Codeなど別のものでも動きます。私がObsidianを使っているのは、<strong>タスクや日々の記録が相互にリンクする形になるため、リンクをたどって行き来しやすい</strong>からです。</p>
<h2 id="スケジューリングを楽にしたい">スケジューリングを楽にしたい</h2><p>スケジューリングって大変ですよね。日次の段取り、週次や月次の見通し、さらに長いスパンの計画と、仕事をしている限り避けては通れません。しかも状況は日々変わりますし、考えるスパンごとに頭の使い方も変わってくるので、コンテキストスイッチのコストも高いです。</p>
<p>これをできるだけ楽にしたい。AIならどうにかしてくれるんじゃないか。そんな期待をもって取り組んでみました。</p>
<h2 id="まずは日次の段取りを任せてみる">まずは日次の段取りを任せてみる</h2><p>いきなり長いスパンの計画は難しいので、まずは日次から試すことにしました。その日の予定と、手元にあるタスクの情報を渡して、「今日の段取りを組んで」と投げてみます。</p>
<p>やってみると、それっぽいものは出てきました。ただ、中身の質としてはそれなりで、そのまま使えるものではありません。手を入れる前提の叩きが出てくる、という感じです。</p>
<p>それでも、<strong>ゼロが1になっていると、次の作業に取りかかりやすい</strong>です。何もないところから始めるよりは、ずっといい感じでした。日々の、「まず何をやって、次に何をやって」と予定を立てる作業が、<strong>出てきた叩きを見て直す作業に変わりました</strong>。この段階で、感覚としては結構楽になりました。</p>
<p>中身の質を上げるには、<strong>こちらからもっと詳しい文脈を渡してあげる必要があります</strong>。何を抱えていて、どれが急ぎで、次に何をするつもりなのか。それを知らない相手に、精緻な計画は立てられません。</p>
<p>というわけで、そこを埋めにいこうと思いました。</p>
<h2 id="タスクの文脈を渡す仕組みを作る">タスクの文脈を渡す仕組みを作る</h2><h3 id="タスクの情報を書き溜める場所を作る">タスクの情報を書き溜める場所を作る</h3><p>そこで、<strong>タスクの情報を書き溜める場所</strong>を作ることにしました。ここで初めてMarkdownとフォルダが出てきます。</p>
<ul>
<li>1タスク1ファイル。次にやること・期限・優先度・状態を持たせる</li>
<li>状態はフォルダで分ける（<code>Inbox</code> &#x2F; <code>Active</code> &#x2F; <code>Done</code> など）</li>
</ul>
<p>フォルダで状態を分けたのは、整理のためというより <strong>「今読ませたい分だけ渡したかったから」</strong> です。全部読ませると、遅くなるうえに、関係ない情報に引っ張られた計画が出てきます。逆に、進行中のものだけが入ったフォルダを作っておけば、あとは「ここだけ読んで」で済みます。</p>
<p>タスクファイルは、こんな形をしています。</p>
<div class="code-block"><figure class="highlight markdown"><input type="checkbox" id="code-wrap-tx544h-1" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-tx544h-1" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line">---</span><br><span class="line">id: &quot;20260824<span class="emphasis">_01&quot;</span></span><br><span class="line"><span class="emphasis">title: &quot;技術ブログ（夏休み自由研究連載）の記事を書く&quot;</span></span><br><span class="line"><span class="emphasis">status: &quot;Active&quot;</span></span><br><span class="line"><span class="emphasis">priority: &quot;High&quot;</span></span><br><span class="line"><span class="emphasis">next_</span>action: &quot;初稿を読み返して、リンクと出典を埋める&quot;</span><br><span class="line">due<span class="emphasis">_date: &quot;2026-09-05&quot;</span></span><br><span class="line"><span class="emphasis">created_</span>at: &quot;2026-08-24&quot;</span><br><span class="line">---</span><br><span class="line"></span><br><span class="line"><span class="section"># 思考ログ・ブレスト</span></span><br><span class="line"></span><br><span class="line"><span class="section">## 目的</span></span><br><span class="line"><span class="bullet">-</span> 連載の1本として、スケジューリングをAIに任せた話を書く</span><br><span class="line"><span class="bullet">-</span> 仕組みの紹介ではなく、「なぜこうなっていったのか」の順で書く</span><br><span class="line"></span><br><span class="line"><span class="section">## 完了条件</span></span><br><span class="line"><span class="bullet">-</span> [x] 章立ての確定</span><br><span class="line"><span class="bullet">-</span> [x] 全章のドラフト</span><br><span class="line"><span class="bullet">-</span> [ ] 公開前の最終確認（固有の情報が残っていないか）</span><br><span class="line"></span><br><span class="line"><span class="section">## 試行履歴・ブロッカー</span></span><br><span class="line"><span class="bullet">-</span> 2026-08-30: 章立てを口述で固めて、初稿まで書いた</span><br></pre></td></tr></table></figure></div>

<p>先頭のYAML部分（frontmatter）が、AIに読ませる構造化された情報です。下の自由記述は、人間が読むためのメモであり、同時にAIに渡す背景でもあります。</p>
<p>ちなみにこれは、まさにこの記事を書くために置いてあるタスクファイルです。</p>
<h3 id="入力もAIに任せる">入力もAIに任せる</h3><p>ここまでは想定どおりでした。想定と違ったのはこの先です。</p>
<p>当初は、<strong>タスクの情報は自分でMarkdownに書き込むもの</strong>だと思っていました。ところが、そうはなりませんでした。結局、<strong>その入力もClaudeに任せる</strong>形に変わっていきました。</p>
<p>理由は単純です。やり取りの中には、<strong>タスクについての暗黙的な観点や考え方</strong>が入っています。</p>
<p>自分でファイルを開いて書くと、整理された<strong>結論だけ</strong>が残ります。「次にやること：レビュー結果を確認する」。これはこれで間違っていないのですが、なぜそれが次なのか、何を懸念しているのか、どういう条件なら方針を変えるのか、といったあたりは頭の中に残ったままになります。</p>
<p>一方、Claudeと会話しながらファイルを更新していると、<strong>そこに至った考え方まで文脈として書き残ります</strong>。会話では自然とそういうことも喋っているので、それがそのまま残る形になります。</p>
<p>つまり、置き場を作ることと、<strong>そこへの入れ方</strong>は別の問題だったわけです。そして精緻な計画につながったのは、フォーマットを整えたことよりも、<strong>言語化していない前提まで残る入れ方に変えたこと</strong>のほうでした。</p>
<p>このあたりから、使い方が「人が書いてAIが読む」から「<strong>AIが読み書きする</strong>」に移っています。当時は意識していませんでした。ただ、AIがファイルを触るようになったことで、このあと任せられる仕事がどんどん増えていきます。振り返ると、そこへの分かれ目がここでした。</p>
<h2 id="文脈が溜まると、任せられる範囲が広がる">文脈が溜まると、任せられる範囲が広がる</h2><p>タスクに関するやり取りを全部Claude経由でやっていると、<strong>「ここまでコンテキストがあるのであれば、あとは進められるんじゃないか」</strong> と思えるものが出てきます。</p>
<p>たとえば、技術的に実現できるのかどうかを確かめるために一次情報を探してもらう。タスクを一段ブレークダウンしてもらう。詰まりそうなポイントを先に挙げてもらう。そういったことが頼めるようになります。</p>
<p>共通しているのは1つです。<strong>自分で考える前に、先にアウトプットを出させる</strong>。私は出てきたものを見て「これでいい」「これじゃない」を判断する側に回ります。そのまま使えるものが出てきたら、もうけもんくらいの感覚でいます。</p>
<p>任せる単位にはコツがあると思っていて、タスク丸ごとは渡しません。<strong>「次にやること」1個</strong>の単位で渡すようにしています。タスク自体は自分がやるしかない仕事でも、その一手だけなら渡せることは多いです。</p>
<div class="note-container note-warn"><span class="note-icon"></span><div>

<p><strong>先にアウトプットが出ていると、それに引っ張られる</strong>ことは無きにしもあらずです。まっさらな状態で考えたときと同じ結論になるとは限りません。</p>
<p>なので、<strong>出てきたものを理解したうえで見る／判断は自分が持つ</strong>、を条件にしています。逆に言えば、<strong>「これじゃない」と言えるのは、自分が何を伝えたいかを持っているとき</strong>だけです。ここに気を付けないと、速いだけで質が落ちてしまうので、注意しています。</p>
</div></div>

<p>ここまでくると、感覚としては、<strong>雑にタスクを投げても、いい感じに進めてくれるパートナーが1人いる</strong>ような状態になりました。</p>
<h2 id="今の運用と、出力に持たせている決めごと">今の運用と、出力に持たせている決めごと</h2><p>現状では、<strong>段取りやスケジュールというマネジメント側の仕事</strong>と、<strong>実作業そのもの</strong>の両方を、AIが一部進めてくれる形になっています。やりたかったのはスケジュールを組ませることだけだったので、当初の想定からはだいぶ広がりました。</p>
<p>朝は「今日の計画」と伝えると、外部の予定と進行中のタスクを突き合わせた時間割の叩きが出てきます。私はそれを見て、順番を入れ替えたり、無理のある枠を削ったりするだけです。夜は「終業」と伝えると、その日終わったタスクを完了フォルダへ移したうえで、何がどこまで進んで、何が残ったかを書き出してくれます。この2つの呼びかけは、繰り返し使うプロンプトとして登録してあります（付録にまとめています）。</p>
<p>出てくるものには、いくつか決めごとを持たせています。</p>
<ol>
<li><strong>読ませる範囲は、外部の予定と進行中のタスクだけ</strong>。それ以外は読ませていません</li>
<li><strong>分からないことは埋めない</strong>。始業時刻を申告していなければ、その枠は空欄のまま残します</li>
<li><strong>完了の根拠を書く</strong>。「終わった」ではなく、「どこまで到達して、何が未充足のままクローズしたか」まで残します</li>
<li><strong>できなかったことは、できなかったと書く</strong>。手をつけられなかった枠は、翌日も同じように出てきます</li>
</ol>
<p>地味ですが、2番目が大事です。ここを推測で埋めさせると、記録としての価値がなくなります。3番目と4番目があるおかげで、翌朝の計画が前日の続きから始まります。</p>
<p>こうした決めごとを足しながら回しているうちに、対象そのものも広がっていきました。最初にできたのは日次だけでしたが、<strong>週次のタスク棚卸しも同じ仕組みに乗せることができ</strong>、冒頭に書いたスケジューリングのつらさも軽減できました。</p>
<h2 id="振り返って大きかったこと">振り返って大きかったこと</h2><p>ここまでの流れは、こういうことだったと思っています。</p>
<blockquote>
<p><strong>スケジュールを組ませるために文脈を溜めたら、その文脈が他の仕事にも使えた。</strong></p>
</blockquote>
<p>任せられる範囲が広がったのは、AIが賢くなったということももちろんあるのですが、<strong>こちらが渡せる文脈が増えたから</strong>でもあります。振り返ると、大きかったのは次の2つです。どちらも最初から設計したわけではなく、そのときどきで足りないものを足していったら、結果としてこの形に落ち着いています。</p>
<p><strong>その1：今アクティブな分だけ渡す</strong></p>
<p>関係ない情報が混じるほど出力はぶれますし、入力が増えればそれだけコストもかかるため、全部は読ませないようにしています。状態でフォルダを分けているのは、「今読ませたい範囲」を指定するためです。</p>
<p><strong>その2：AIにファイルを読み書きさせる</strong></p>
<p>「入力もAIに任せる」で書いたように、Claudeとの会話を通してファイルをいじることで、<strong>言語化していない分まで記録できる</strong>ようになりました。自分で書くと結論だけが残りますが、会話を通すと、そこに至った考え方も一緒に残ります。</p>
<div class="note-container note-warn"><span class="note-icon"></span><div>

<p>ただし、記録がそのまま溜まっていくだけだと、読み返さないファイルが増えていくことになります。<strong>終わったタスクから、次に使えそうなところだけを別の場所に抜き出しておく</strong>、という作業は別でやっています。</p>
</div></div>

<h3 id="うまくいかなかったこと">うまくいかなかったこと</h3><p>正直なところも書いておきます。</p>
<p><strong>架空の予定や実績を書いてしまう</strong>。これがいちばん困りました。始業時刻や空き時間が分からないと、それらしく埋めてきます。記録としては最悪なので、<strong>「実在する事実だけで組む」「分からなければ聞く」「レポートの根拠は実際に完了へ動かしたものだけ」</strong> をルールとして明文化して、ようやく落ち着きました。</p>
<h3 id="どこまで効くのか">どこまで効くのか</h3><p>もうひとつ、適用限界の話です。私の仕事は、技術的に可能かどうかを調べる、エラーの原因を追う、あるべき姿と現状の差分を埋める、といった<strong>検証しやすく前例の多いもの</strong>が多いので、この形がよく効きます。</p>
<p>一方、何を問題として設定するか、どちらを取るかを決める、といった仕事では効き幅は小さいと感じています。しかもこちらは、間違っていたことに気づくのが遅くなりがちです。<strong>易しい仕事で身についた軽いレビューの癖を、そのまま持ち込むのが危ない</strong>。今のところ、これがいちばんの注意点です。</p>
<p>ではそこに意味がないかというと、そうでもありません。<strong>任せられる仕事を速く終わらせるのは、考える仕事に使う時間と頭を空けるため</strong>でもあります。</p>
<h2 id="参考にした考え方">参考にした考え方</h2><p>この仕組みは、AIと壁打ちしながら作りました。とはいえAIが出してくる案は、<strong>すでに誰かが考えたことの延長</strong>です。似たようなことを考えている人が先にいるから、それらしい形が返ってくるわけで、実際、作っている途中で「その考え方にはこういう名前がついている」と教えてもらいました。</p>
<p><strong>Second Brain（第二の脳）</strong>、<strong>PARA</strong>、それから <strong>構造化したMarkdownをLLMに直接読ませる</strong>という考え方（Andrej Karpathy 氏が2026年4月に出した提案）あたりです。私は原典の詳細まで当たれていないので中身の紹介はしませんが、興味のある方は元をたどってみてください。リンクは末尾に置いておきます。</p>
<h2 id="最小構成で始める">最小構成で始める</h2><p>大掛かりなものは要りません。次の5ステップで1周できます。</p>
<ol>
<li>Obsidianを入れて、vault（＝ただのフォルダ）を作る</li>
<li>フォルダを <strong>2つだけ</strong> 作る（<code>Active</code> と <code>Done</code>）</li>
<li>Markdownを1枚作って、今抱えている仕事を1つ書く。次にやること・期限だけでいいです</li>
<li>Claude Code に <strong>「この <code>Active</code> フォルダだけ読んで、今日の段取りの叩きを作って」</strong> と投げる</li>
<li>出てきたものを、その場で直す</li>
</ol>
<p>ここまでで1周です。「まずは日次の段取りを任せてみる」に書いたとおり、<strong>何もないところから始めなくてよくなったぶんの効果は、この時点でもう出ています</strong>。設計は後回しで構いません。</p>
<div class="note-container note-warn"><span class="note-icon"></span><div>

<p>ここに載せたものはあくまで個人の運用例で、そのまま動くことを保証するものではありません。ルールの明文化（「うまくいかなかったこと」で書いた「架空の記録を作らない」など）は、環境に合わせて自分で足していく必要があります。</p>
</div></div>

<h2 id="さいごに">さいごに</h2><p>自由研究として始めた話ですが、やってみて思ったのはこういうことでした。</p>
<blockquote>
<p><strong>AIに任せられる仕事の範囲は、こちらが渡せる文脈の量で決まる。</strong></p>
</blockquote>
<p>もちろんAIの賢さも関係しています。ただ、同じAIに同じことを頼んでも、渡している文脈の量で返ってくるものは変わります。私の場合は、スケジュールを組ませたいという入口から文脈を溜めはじめて、気づいたら任せられる仕事の範囲のほうが広がっていました。</p>
<p>そして、任せる方向に進むほど、自分の仕事は確認に寄っていきます。作業レベルのことは、文脈さえ渡せば適切にやってくれる。そうなると大事になるのは、<strong>出てきたものをどういう観点で見られるか</strong>です。速く作れることよりも、良し悪しを判断できることのほうが、これからは重要になるのだろうと思っています。</p>
<p>この記事も同じやり方で書いています。章立てを口述して、叩きを出させて、違うところを直す。最初に返ってきた構成は「仕組みの説明」から入るものでしたが、「なぜこうなっていったのか」の順で書きたかったので、丸ごと組み替えるといった感じで変更を加えました。</p>
<p>今後考えてみたいこととしては、このような個人のタスク管理をどうやってチーム単位の管理に広げるのか、もっとうまい仕事の渡し方はあるのか、みたいなあたりです。そこはまだ手探りです。</p>
<p>もし試していただけた方や、すでに似たような仕組みを作って回している方がいたら、感想や、どうやっているのかをぜひ聞かせてください。</p>
<p>長い記事を最後まで読んでいただき、ありがとうございました。この記事が、みなさんのAI活用の役に立てば幸いです。</p>
<h2 id="付録-できあがったvaultの全体構成">付録: できあがったvaultの全体構成</h2><p>本文では順番に足していった話をしたので、最後に現在の形をまとめておきます。</p>
<div class="code-block"><figure class="highlight text"><input type="checkbox" id="code-wrap-tx544h-2" class="code-wrap-input code-wrap-narrow" aria-label="コードの折り返しを切り替える"><label class="code-wrap-label" for="code-wrap-tx544h-2" title="コードの折り返しを切り替える"></label><table><tr><td class="code"><pre><span class="line">vault/</span><br><span class="line">├── CLAUDE.md          # AIへの常設の指示書（運用ルール）</span><br><span class="line">├── 01_Daily/          # 1日1ファイル（月ごとにサブフォルダ）</span><br><span class="line">│   └── 2026-08/</span><br><span class="line">├── 02_Tasks/          # 1タスク1ファイル。フォルダ＝状態</span><br><span class="line">│   ├── 01_Inbox/      # 未計画</span><br><span class="line">│   ├── 02_Active/     # 進行中 ← 日次計画で読むのはここだけ</span><br><span class="line">│   ├── 03_Done/       # 完了（月ごとにアーカイブ）</span><br><span class="line">│   └── 04_Blocked/    # 人の判断待ちで自走できない</span><br><span class="line">├── 90_Attachments/    # 特定タスクの証跡・作業素材</span><br><span class="line">└── 91_Reference/      # 複数タスクで再利用する知識</span><br></pre></td></tr></table></figure></div>

<p>状態はこう動きます。</p>
<pre class="mermaid" data-mermaid="12d1f1778e722a43cc32444d0e98ef0678cf1c6787f595e039dcf86f549754b4">stateDiagram-v2
    [*] --> Inbox
    Inbox --> Active
    Active --> Blocked: 人の判断・承認待ち
    Blocked --> Active: 解消
    Active --> Done
    Done --> [*]</pre>

<p><strong>状態をフォルダとファイル内の両方に持たせています</strong>。フォルダで持つのは「読ませる範囲を切り出す」ため、ファイル内（frontmatter）で持つのは「AIがパースできる形にする」ためです。二重管理なので、移動のたびに両方を書き換えます。手間ではありますが、2つは目的が違うため、片方に寄せると片方が不便になります。</p>
<p><code>CLAUDE.md</code> には、AIに毎回説明しなくて済むように運用ルールを書いています。抜粋するとこんな内容です。</p>
<details><summary>CLAUDE.md に書いているルール（抜粋）</summary>

<ul>
<li>日次の時間割を作るときは、進行中フォルダだけを読む。未計画・完了は読まない（コンテキストを膨らませないため）</li>
<li>架空のスケジュール・実績を作らない。実在する事実だけで組み、分からなければ聞く</li>
<li>業務レポートの根拠は、実際に完了フォルダへ移動したタスクだけ</li>
<li>日次計画とタスクの深掘りは、編集するファイルを分ける</li>
<li>新規ファイルはテンプレートからコピーして作り、勝手に項目を増やさない</li>
<li>ファイル名は <code>日付_連番_タイトル.md</code> で統一する</li>
</ul>
</details>

<p>定型のルーチンは、繰り返し使うプロンプトとして登録してあります（Claude Code の「スキル」の仕組みです）。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 呼び出し / やること"><table>
<thead>
<tr>
<th>呼び出し</th>
<th>やること</th>
</tr>
</thead>
<tbody><tr>
<td><code>/morning</code></td>
<td>前日レポートの埋め戻し → 期限超過チェック → 今日の時間割を生成</td>
</tr>
<tr>
<td><code>/evening</code></td>
<td>完了タスクを完了フォルダへ移動 → 今日のレポートを生成</td>
</tr>
<tr>
<td><code>/kickoff</code></td>
<td>進行中タスクの「次にやること」を仕分けし、渡せるものを先に進めさせる</td>
</tr>
<tr>
<td><code>/weekly-review</code></td>
<td>週次の棚卸し（期限の再交渉、未計画の整理、完了分のアーカイブ）</td>
</tr>
</tbody></table></div>
<p>呼び出し名は自分で決められます。本文で「今日の計画」「終業」と書いていたのは、それぞれ <code>/morning</code> と <code>/evening</code> のことです。</p>
<h2 id="参考">参考</h2><ul>
<li>Tiago Forte『Building a Second Brain』（2022）<ul>
<li>第二の脳、PARA の元になっている書籍です</li>
</ul>
</li>
<li>Andrej Karpathy 氏によるLLM知識ベースの構想<ul>
<li>小〜中規模ならRAGを使わず、Markdownを直接読ませるという提案です</li>
</ul>
</li>
</ul>
]]></content>
    <summary type="html">スケジュールを組ませるためにタスクの文脈をMarkdownへ溜めていったら、スケジュール以外の仕事もAIに渡せるようになっていた、という話です。Obsidian と Claude Code だけで組んだ仕組みと、そこに至るまでに何が足りず何を足したのかを書いています。</summary>
    <category term="AIDD" scheme="https://future-architect.github.io/categories/AIDD/"/>
    <category term="Claude" scheme="https://future-architect.github.io/tags/Claude/"/>
    <category term="Obsidian" scheme="https://future-architect.github.io/tags/Obsidian/"/>
    <category term="タスク管理" scheme="https://future-architect.github.io/tags/%E3%82%BF%E3%82%B9%E3%82%AF%E7%AE%A1%E7%90%86/"/>
  </entry>
  <entry>
    <title>ラジカルAIプログラミング実践編 — 1人PoCから考えるマルチエージェント開発の「統治と委任」</title>
    <link href="https://future-architect.github.io/articles/20260828a/"/>
    <id>https://future-architect.github.io/articles/20260828a/</id>
    <published>2026-08-27T15:00:00.000Z</published>
    <updated>2026-08-27T15:00:00.000Z</updated>
    <author><name>井上拓</name></author>
    <content type="html"><![CDATA[<img fetchpriority="high" src="/images/2026/20260828a/top.jpg" alt="" width="1024" height="559">

<p>夏休み自由研究連載 2026 の2本目です。</p>
<p>こんにちは、井上です。</p>
<p>ループエンジニアリングからグラフエンジニアリングへ——生成AIによる開発自動化の議論は、この1年で急速に解像度を上げています。論点は「AIをどう使うか」から「AIの実行をどう統治するか」へと移り、人間がすべての判断点に立つ Human in the Loop（HITL）から、ループの外から監督する Human on the Loop（HOTL）へ、という整理も広く語られるようになりました<sup id="fnref:1">1</sup>。</p>
<p>当ブログの2025年11月公開記事 ラジカルAIプログラミング では、人間は「What」と「Why」の明文化・ビジョン設定に専念し、実装の裁量はAIに委ねるという開発観を提示しました。今回紹介するツール開発は、この思想を企画段階から取り入れ、単一セッションでの開発を超えてマルチエージェントの決定論的ワークフローとして実践してみた試みです。</p>
<p>一方で、こうしたAI統治の議論の多くは、月間数千億トークンを消費するような大規模組織の実践から語られています。本稿はその対極、<strong>1名・約1週間で仕上げるツール開発光速イテレーション</strong>というミクロな実践から、同じ問いを考えてみる試みです。規模は小さくとも——むしろ小さいからこそ——見えてきた構造があり、それは突き詰めると「統治と委任」、すなわち経営でいう「ガバナンスと権限委譲」という、人間の組織論と地続きの話でした。</p>
<h2 id="何を作っていたか">何を作っていたか</h2><p>発端は些細な “思い付き” でした。複数のコード生成AIセッションを並行して使っていると、あるセッションの回答を別のセッションへ転記する作業が地味に面倒で、だったらその転記自体をAIに代行させればいいのでは、と思いついたのが始まりです。実装にはClaude Codeを使っていますが、本稿の主題は汎化できるテーマと考えましたので、以降は単に「コード生成AI」、略してAIと呼びます。</p>
<p>最初は同じモデルの2セッションを向かい合わせ、応答を相互に自動転記するだけのPoCでした。ところがこのAI同士の会話の中で、AI自身が印象的な指摘を返してきます。当時のログから引用します。</p>
<blockquote>
<p>AとBは同じベースモデル（重み）を共有しているため、人間の異なるレビュアー同士が持つような認知的多様性はありません。（中略）つまりここでの価値は「思考の多様性」ではなく、役割分担に伴うインターフェースの強制（責務境界・情報の非対称性・確認プロトコルの明文化）から来ていると考えるのが妥当だと思います。</p>
</blockquote>
<p>「マルチエージェントの価値は多様性ではなく、<strong>情報の非対称性の設計</strong>にある」。頼んでもいないのにAIが自分たちの構成の限界を言語化してきたこの指摘は、結果的にこのツール開発全体を貫く設計思想になりました。</p>
<p>これを踏まえ、方向性を「会話を続けるPoC」から「成果物を段階的に引き渡すワークフロー基盤」へ転換しました。機能配置は次の通りです。</p>
<ul>
<li><strong>企画層</strong>: 最上位モデルが方針とタスク分解を担当</li>
<li><strong>実行層</strong>: タスク単位で個別セッションを起動し、実装を担当</li>
<li><strong>レビュー層</strong>: 実行層とは別セッション（別モデル）が成果物を検証</li>
<li><strong>トリアージ層</strong>: 想定外の事態の一次判断を、これも別モデルが担当</li>
</ul>
<p>さらに、この基盤の開発自体に開発中の基盤を使う、ドッグフーディングの形で開発を進めました。設計・実装・レビュー・指摘対応はAIに任せ、人間が担うのは企画方針の決定と各段階の受入レポートのレビュー・承認のみ。感覚としては、開発会社に外部委託し、提案依頼と受入検収だけを自社で行うイメージ（ふだんは我々がむしろ仕事を受ける側の進め方）に近いものです。</p>
<figure><img src="/images/2026/20260828a/cockpit.png" alt="" width="1200" height="665" loading="lazy"><figcaption>進捗を観測するコックピット画面。各タスクの成否・やり直し回数・トークン消費が一覧でき、人間はここで受入レポートを確認する。なお、UI設計はAIに一任し、渡したのは目的と参考の画面キャプチャ1枚だけで、レイアウト・配色・機能仕様はすべてAIが設計した。</figcaption></figure>
<h2 id="ミクロな実践でも、「統治」の形に収束した">ミクロな実践でも、「統治」の形に収束した</h2><p>興味深いのは、この構成を統治論から演繹して設計したわけではない、という点です。「人間が介在しなくても自律的に回り続ける仕組み」を素朴に目指した結果として、役割はこう分離されていきました。</p>
<div class="scroll" tabindex="0" role="region" aria-label="表 統治機能 / 本実践での対応物"><table>
<thead>
<tr>
<th align="left">統治機能</th>
<th align="left">本実践での対応物</th>
</tr>
</thead>
<tbody><tr>
<td align="left">ルール定義（何が正しいか）</td>
<td align="left">企画層による方針・実行計画・指示書</td>
</tr>
<tr>
<td align="left">適合判定（違反・逸脱の検知）</td>
<td align="left">レビュー層と受入ゲート</td>
</tr>
<tr>
<td align="left">実行</td>
<td align="left">実行層の個別セッション</td>
</tr>
</tbody></table></div>
<p>大規模組織のAI統治で語られる「ルール定義・適合判定・実行の分離」と、実質的に同じ形です。1名・1週間のミクロなPoCでも同じ構造に行き着いたということは、これは規模の産物ではなく、<strong>AIの実行を自律させようとしたときに必然的に要請される構造</strong>なのだと考えています。マルチエージェントハーネスの設計論が繰り返し似た形（プランナー／ワーカー／ジャッジ）に収束するのも、同じ力学でしょう。</p>
<p>そして人間の位置は、自然と「ループの中」から「ループの外」へ移りました。HOTLへの移行は、目指して起きたというより、自律化を進めた結果として残った人間の仕事が「企画」と「検収」だった、という順序です。</p>
<h2 id="事故が教えてくれた、統治の解像度">事故が教えてくれた、統治の解像度</h2><p>とはいえ、概念図の上で統治が成立していることと、実際に統治が効いていることは別物でした。ドッグフーディング中の事故がそれを教えてくれます。</p>
<h3 id="ルールは「書かれている」だけでは効かない">ルールは「書かれている」だけでは効かない</h3><p>レビューで差し戻しを出した際、指摘内容を修正担当のAIへ引き継ぐ設計のはずが、実際にはその指摘が再実行時の指示に一切渡っておらず、修正担当が同じ問題を延々と繰り返す状態に陥っていたことがありました。フィードバックループは「存在すること」ではなく「実際に配線されていること」を確認しなければ意味がない——ルールや指摘の伝達経路そのものを検証対象にする必要がある、という教訓です。統治の議論で「ルールの由来や効き方を追跡可能にせよ」と言われるのは、まさにこの問題だと実感を持って理解できました。</p>
<h3 id="AIは自分の足場を壊しうる">AIは自分の足場を壊しうる</h3><p>「設定ファイル群の記法を新形式に一括変換する」タスクを任せたAIが、変換対象の中に自分自身の実行を支える設定ファイルを含めて書き換えてしまい、以後の処理が「空の設定」を読んで何もせず完了扱いになる、という事故もありました。「自分が今使われている土台には手を出さない」というのは、人間の開発では明文化されない暗黙のルールです。AIへの委任範囲を設計する際は、こうした自己言及が起きる境界を洗い出し、明文化しておく必要があります。</p>
<h3 id="やり直しは安い">やり直しは安い</h3><p>一方で、希望の持てる発見もありました。処理量の見積もり超過でタスクが中断した際、実は作業は完了しコミット済みで、同じタスクを再登録するとAIは既存の成果物を認識し、初回よりずっと低いコストで完了まで到達したのです。成果物さえ永続化されていれば、失敗からの再実行は高くつきません。人間の介入なしにAIが走り続けられる度合い——いわばAIの実行密度を支えるのは、高度な制御よりもまず「リトライが安い」構造なのだと学びました。</p>
<p>これは見方を変えると、<strong>生成AIの推論も純粋なシステム処理の一つとして捉え、チューニングできる</strong>という示唆です。適切なトランザクション制御をあらかじめ設計しておけば、異常系が発生してもデータの完全性は保たれ、冪等な再実行が可能になる——バッチ処理やジョブ設計で積み上げられてきたシステム処理設計のノウハウは、そのままマルチエージェントのフロー設計にも生かせます。AIだからと特別視せず、従来の設計資産を持ち込めることを実感した出来事でした。</p>
<h2 id="論点-統治の源流に、人間は何を置くべきか">論点: 統治の源流に、人間は何を置くべきか</h2><p>さて、ここからが本稿でいちばん考えたかったことです。</p>
<p>AI統治の議論では、「人間が定義した一次情報（SSOT）と、機械が自動生成した派生データを厳密に区別し、自動生成物を判断の根拠にしない」という原則が語られることがあります。統治の崩壊——出所不明の情報が根拠として増殖していく事態——を防ぐ、という問題意識には全面的に同意します。</p>
<p>ただ、この原則を厳密に適用した未来には、私は懐疑的です。AIの生成物をSSOTに昇格させるため、人間が全量レビューするのだとしたら、<strong>人間が処理すべき情報量はHITLと変わらず、律速点がループの中から承認プロセスへ移動しただけ</strong>になってしまいます。実際、1週間のドッグフーディングで生成された設計書・実装・レビューレポートの総量は、1人の人間が精読できる量をあっさり超えました。ツール開発という、ミクロな実践ですらそうなのです。</p>
<p>では、どう考えるか。推論の源流をたどれば人間の意思・判断があるべきだ、という点は揺るぎません。しかしそこに置くべきは、「目的」に始まり、「方針」や「前提」といった<strong>きわめてミニマムな原則だけ</strong>でよいのではないか。そこからAIが推論し具体化した成果物は——適切な検証を経る前提で——たとえAIの生成物であってもSSOTとして扱ってよいのではないか。これが、今回の実践を通じて私が持った仮説です。</p>
<h2 id="統治と委任-—-人間の組織が、すでに答えを持っている">統治と委任 — 人間の組織が、すでに答えを持っている</h2><p>この仮説は、実は新しい話ではありません。人間の組織が何百年もやってきた「統治と委任」そのものです。</p>
<p>最終承認者が経営者であるようなプロジェクトを考えてみてください。経営者がすべての成果物を自らレビューするのは不可能です。実際には、信頼できる部門のメンバーに確認させ、その報告——つまり<strong>要約と解釈</strong>——をインプットとして承認します。統治は「全量を自分で見る」ことではなく、「信頼できる検証構造を設計し、読める粒度の報告を受け、権限を適切に委任する」ことで成立してきました。</p>
<p>同じ設計がAIの統治にも適用できるはずです。今回の実践でいえば、レビュー層に<strong>敵対的検証</strong>の役割を与える——実装担当とは別のモデルに「この成果物の欠陥を探せ」という立場で確認・サマリをさせる——ことで、経営者が受け取る「信頼できる部下の報告」に相当するものを作れます。人間はその報告を読んで承認する。これは「ちゃんと読まずに承認」とは違います。<strong>読める分量に凝縮された、検証済みの報告を読んで承認する</strong>のです。</p>
<p>もちろん、委任には設計が要ります。承認が形骸化したとき実害を被るのは人間であり、それを防ぐ責務も人間にあります。だからこそ、すべてを同じ重さで承認するのではなく、<strong>リスクレベルに応じて承認権限をAIに委任する／しないを切り分ける</strong>ことが重要になります。本番環境に触れる変更は人間が握り、開発環境内で完結する中間成果物はAIの相互検証に委ねる、といった具合です。これも人間の組織における職務権限規程と、考え方は何も変わりません。</p>
<h2 id="これからのマルチエージェント開発">これからのマルチエージェント開発</h2><p>最後に、今回の実践から見えた気づき・見通しを3点にまとめます。</p>
<p><strong>1. 伝送路はコモディティ化し、価値は統治層へ移る。</strong> 今回自作したセッション間の転記機構のようなものは、すでに公式機能として整備が始まっており<sup id="fnref:2">2</sup>、いずれ「作る」ものではなく「使う」ものになります。残るのは「何を、どのタイミングで、誰（どの役割・どのモデル）に渡し、何を渡さないか」という情報の非対称性の設計——すなわち統治と委任の設計です。競争力の源泉、つまり差別化要素はここに移っていくと見ています。</p>
<p><strong>2. 統治は「配線の検証」から始まる。</strong> ルールを書くこと、フィードバックループを設計図に描くことは出発点にすぎません。それが実際に効いているか——指摘は次の実行に渡っているか、AIが自分の足場に触れない境界は機能しているか——を検証する仕組みまで含めて、はじめて統治と呼べます。ミクロな実践でも、事故はすべて「書かれていたが、配線されていなかった」場所で起きました。</p>
<p><strong>3. HOTLは大規模開発特有のものではない。</strong> 1名・1週間のツール開発でも、観測手段（コックピット）と受入ゲートさえ用意すれば、人間がループの外から統治する体制は成立しました。むしろ小さく始めて、自分の手元の小規模開発で「統治の事故」を安全に経験しておくことが、来たるべき大規模なマルチエージェント開発への最良の準備になると感じています。</p>
<h2 id="おわりに-—-生成AIと人間のチームワークの追求">おわりに — 生成AIと人間のチームワークの追求</h2><p>コピペ代行の思いつきから始まった1週間は、最終的に「AIをどこまで信じ、何を委ねるか」という問いに行き着きました。</p>
<p>生成AIの出力をすべて疑い、全量を人間が確認する道は、安全に見えて、実際にはAIの能力を人間の処理能力の枠内に閉じ込める道です。逆にすべてを盲信する道は、統治の崩壊に至ります。その間にある道——源流にミニマムな人間の意思を置き、検証構造を設計した上で、抽象レベルの意思入れと結果の確認・承認によって協調する道——を探ることが、マルチエージェント開発の本題になっていくのだと思います。</p>
<p>人間の組織が「統治と委任」のバランスで成果を出してきたように、生成AIとの間にも同様のバランスは設計できる。それを信じられるだけの手応えが、今回のミクロな実践にはありました。</p>
<div id="footnotes"><hr><div id="footnotelist"><ol style="list-style:none; padding-inline-start: 0;"><li id="fn:1"><span style="vertical-align: top; padding-inline-end: 10px;">1.</span><span style="vertical-align: top;">例えば AI Engineering Summit Tokyo 2026 における外山英幸氏（株式会社ビズリーチ 執行役員CTO）の講演「AI駆動開発が変える、大規模開発の前提」（https://speakerdeck.com/visional_engineering_and_design/aie2026 ）。本稿の統治に関する用語整理の一部は本講演を参考にしています。</span> ↩</li><li id="fn:2"><span style="vertical-align: top; padding-inline-end: 10px;">2.</span><span style="vertical-align: top;">例えばClaude Codeの cross-session messaging。</span> ↩</li></ol></div></div>]]></content>
    <summary type="html">マルチエージェントの開発基盤を1名・約1週間で作り、その基盤自体の開発に使ってみました。企画・実行・レビュー・トリアージを別セッションに分けた構成、ドッグフーディング中に起きた事故、そこから見えた「統治と委任」の設計について書いています。</summary>
    <category term="AIDD" scheme="https://future-architect.github.io/categories/AIDD/"/>
    <category term="AIエージェント" scheme="https://future-architect.github.io/tags/AI%E3%82%A8%E3%83%BC%E3%82%B8%E3%82%A7%E3%83%B3%E3%83%88/"/>
    <category term="設計" scheme="https://future-architect.github.io/tags/%E8%A8%AD%E8%A8%88/"/>
  </entry>
</feed>