アルゴリズムとデータ構造連載

monotone minima による高速化について

アルゴリズム 最適化
目次

はじめに

2021年4月入社の山田です、アルゴリズムとデータ構造連載の6日目です。

私は学生時代競技プログラミングに打ち込んでおりました。今回フューチャー技術ブログでアルゴリズムの記事を書く機会を頂きとても嬉しいです! よろしくお願いします!

内容

本記事では、最適化問題を解く上でのシンプルな高速化手法である monotone minima について説明します。
対象とする問題について紹介した後、 monotone minima のアルゴリズムの説明、そしてなぜ高速化が達成されるのかを説明します。

例題と問題の定式化

まず、イメージしやすいよう以下のような例題を考えてみます。

A市では大通り (ここでは X 軸とします) に沿って N 軒の家が並んでいます。 A市には M 個のコンビニエンスストアが存在し、 N 軒の各家の住人はそれぞれ家に最も近いコンビニエンスストアを普段利用しています。 A市は家ごとにどのコンビニを普段利用しているかを調査することにしました。

家の座標 (pi,0) (1≤i≤N) とコンビニの座標 (xj,yj) (1≤j≤M) が与えられるので、各家 i についてどのコンビニを利用しているかを求めてください。
(簡単のため座標は、 pi≤pi+1 および xj≤xj+1 が成り立つように並べられているものとします。)

簡単に図で例を示します。A市は2次元平面で表され、赤い丸が家、青い丸がコンビニを表しています。
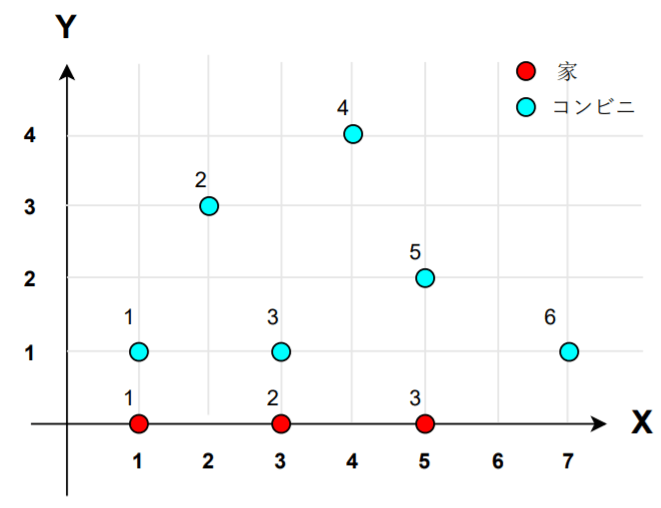
問題イメージ

それぞれの赤い丸 i に対して、 最も距離が近い場所にある青い丸 j を見つけるということが今回の問題で求められていることです。
ここで、この問題はより一般的にこのように言い換えることができます。

関数 f(i,j) (1≤i≤N,1≤j≤M) について、各 i ごとに最小の値を実現する j の値を求めてください。
( i,j は整数 )

例題では f(i,j) は 家 i と コンビニ j の距離です。
この問題は特に何も制約がない場合、 (i,j) のペアを全て試す O(NM) 時間のアルゴリズムによって解くことができます。
しかし、今回の例題のような場合には f(i,j) の持つ良い性質によって、より高速に問題を解くことが可能です。

monotone minima

では例題の関数 f(i,j) の持つ性質とはどのようなものでしょうか。
それは以下の性質です。

i0≤i1 であるような任意の i0,i1 (1≤i0,i1≤N) に対して、
f(i0,j) の最小を与える j を j0、 f(i1,j) の最小を与える j を j1 とした時に、 j0≤j1 を満たす。

以降、これを性質 (A) とします。
実際に先程図示した例で見てみましょう。 家とコンビニの距離 f(i,j) を表にするとこのようになります。
赤い文字で示されているところが最小値です。
(注:わかりやすいように実際には距離(ユークリッド距離)の2乗を示しています。)
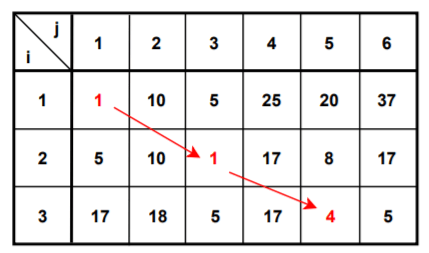
家とコンビニの距離

i が大きくなるにつれて、 最小を達成する j の値も大きくなっていることがわかると思います。
これはどのような入力に対しても成り立ちます。

f(i,j) が性質 (A) を持つとき、 monotone minima と言われるアルゴリズムが適用でき、 O(N+Mlog⁡N) 時間で問題を解くことができます。
monotone minima は i を適切な順番で計算していくことによって、計算の必要な j の範囲を絞っていき、効率的に計算するアルゴリズムです。
monotone minima のアルゴリズムを擬似コードで以下に示します。

// i0 <= i <= i1 を満たす i について答えを求めていく関数
// この時、 j0 <= j <= j1 を満たす j について考えれば十分ということが分かっている
def monotone_minima(i0, i1, j0, j1):
// 対応する i の範囲が存在しない
if(i0 > i1) return

// i0 と i1 の真ん中に存在する im に注目する
im = (i1 - i0) / 2 + i0
// f(im, j) が最小となるような j (j0 <= j <= j1) を全探索する
jm = calc_argmin_f(im, j0, j1) // f(im, jm) が最小だとわかった
answer[im] = jm // 答えを格納

// 探索の領域を im を中心に半分に分割する
// i0 <= i < im の範囲の答えを再帰的に求める
// この時、性質(A)から答えは j0 <= j <= jm の中に存在する
monotone_minima(i0, im - 1, j0, jm)

// im < i <= i1 の範囲の答えを再帰的に求める
// この時、性質(A)から答えは jm <= j <= j1 の中に存在する
monotone_minima(im + 1, i1, jm, j1)

// 問題全体としては、全ての i (1 <= i <= N) ついて答えを求めたい
// はじめは 1 <= j <= M を満たす全ての j について考えなければ行けない
def solve_all():
monotone_minima(1, N, 1, M)

solve_all()によって全ての i についての答えを計算できます。
性質 (A) からこのアルゴリズムが正しい答えを計算することがわかります。

高速化が達成される理由

では、これでなぜ高速化が達成されるのでしょうか? 問題の分割されていく流れに注目して計算にかかる時間を考えてみます。
f(i,j) の値が書かれた表をイメージして図示していきます。
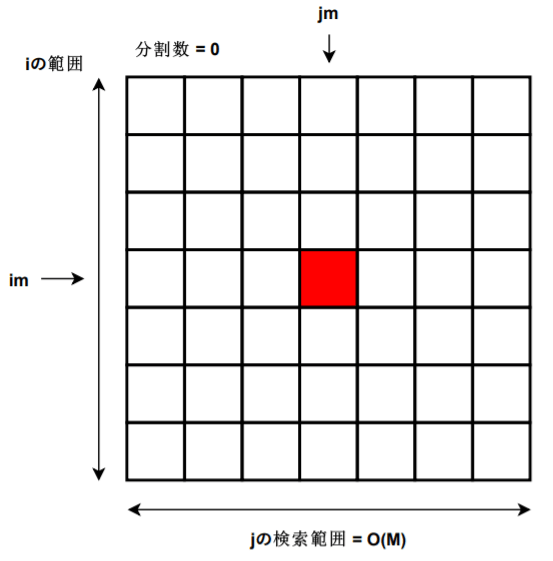
始めは全く範囲が分割されていない状態からスタートします。

範囲が分割されていない初期状態

擬似コードにあったように、 i の範囲の中心の im について、 f(im,j) を最小にする jm を j (1≤j≤M) を全探索して求めます。この操作は明らかに O(M) 時間です。
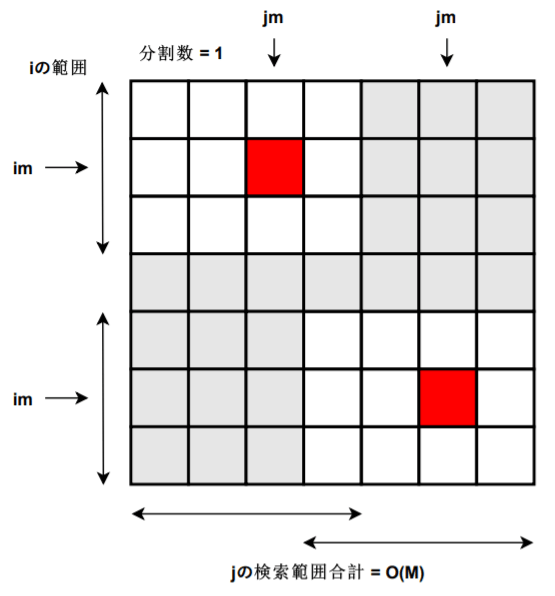
次に一段階範囲を分割した(一段階再帰した)状態について見てみます。

一段回分割した状態

分割されたそれぞれの範囲で jm の計算が行われます。この時行われる2つの j の全探索について、探索範囲の重複を無視するとやはり合計で O(M) 時間の計算になっていることが分かります。
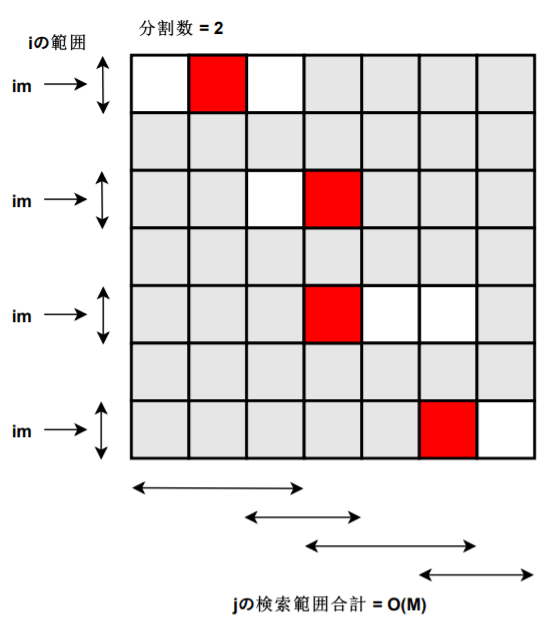
さらに分割して、

分割した範囲で計算

区間は4つに分かれましたが、やはり重複を無視して見ると jm の計算は合計 O(M) 時間で収まっています。そして、これらの分割は、Nを毎回半分づつにしているため、最大 O(log⁡N) 回しか起こりません。
各分割で無視された重複箇所の合計は O(N) 個になることに注意すると monotone minima のアルゴリズムは、全体 O(N+Mlog⁡N) 時間になることがわかります。
これは O(NM) 時間からの高速化に成功しています。

まとめ

今回は最適化問題を解くシンプルな高速化手法 monotone minima について説明しました。

monotone minima はシンプルながら強力な手法で、動的計画法への興味深い応用も存在します。

いずれ他の記事でそちらにも触れていけたらと思います。ありがとうございました!

参考

週刊 spaghetti_source / Totally Monotone Matrix Searching (SMAWK algorithm)
Kyopro Encyclopedia of Algorithms / Monotone minima
動的計画法高速化テクニック(オフライン・オンライン変換)