- 林知範
- 約 7,800 文字
目次
こんにちは、2026 年 8 月にキャリア入社した林です。
ジョインしたてでチームメンバーにフォローアップしてもらうことが多い中で、何か還元できることはないかと考えました。チームメンバーと会話する中でこれからクラウドインフラを学びたいメンバーがいたので、クラウドインフラを触る上で先に知っておくと良い心構えを講義形式でインプットすることにしました。
本記事では、その講義で扱った題材をピックアップして複数回にまとめていきたいと思います。これからクラウドインフラを学びたいと思っている方や触りたてという方に向けて、基礎を固める役に立てれば幸いです。
全体構成
講義形式ということで下記のような章立てとしています。網羅性を重視するよりも私の経験から知っておくと良いトピックを重視した構成としています。(以降、クラウドインフラを提供するサービスをクラウドと呼びます。)
- 1章 オンプレミスとクラウドの違いを知る(違いを知る)
- 2章 壊れる前提で、強くする(耐障害性)
- 3章 セキュリティの基本原則(セキュリティ)
- 4章 壊れてはいけないもの(データと状態)
- 5章 なぜ、インフラをコードにするのか(IaC)
- 6章 見えないものは、直せない(運用と観測性)
- 7章 何を任せ、何を手元に残すか(マネージド)
Part1 の本記事では 1 章から 3 章を扱います。
1章 オンプレミスとクラウドの違いを知る
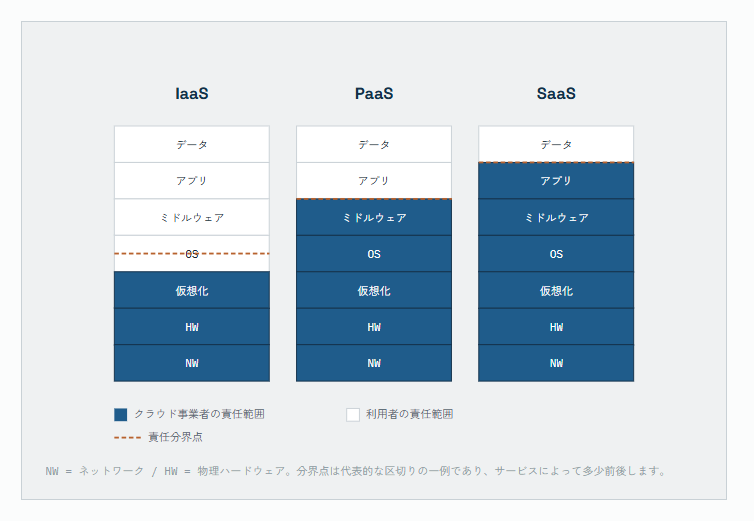
この章では、オンプレからクラウドに変わることで何が変わるのか俯瞰する内容としています。特に触れておきたかったのは責任共有モデルです。クラウドは「クラウド事業者に任せる部分」と「利用者が管理する部分」が混在するサービスです。クラウドを利用すればセキュリティ含めすべてやってくれると思われがちですが、サービス形態によって事業者が管理してくれる範囲が異なります。
これはよく耳にする IaaS / PaaS / SaaS というサービス形態の違いで区分されています。下図のように青の事業者が責任を持つ範囲が広いほど利用者が背負う責任は狭くなります。
利用するサービスに対してどこから責任を負わなければいけないのかを把握することがクラウドを触る第一歩と言ってもいいのではないでしょうか。
深掘り①:フルマネージドサービス
クラウドを知っていくとフルマネージドサービスという単語も出くわすことがあります。私は以前、上記の区分と何が違うのかを混乱したことがあるので関連する概念として簡単に触れておきます。
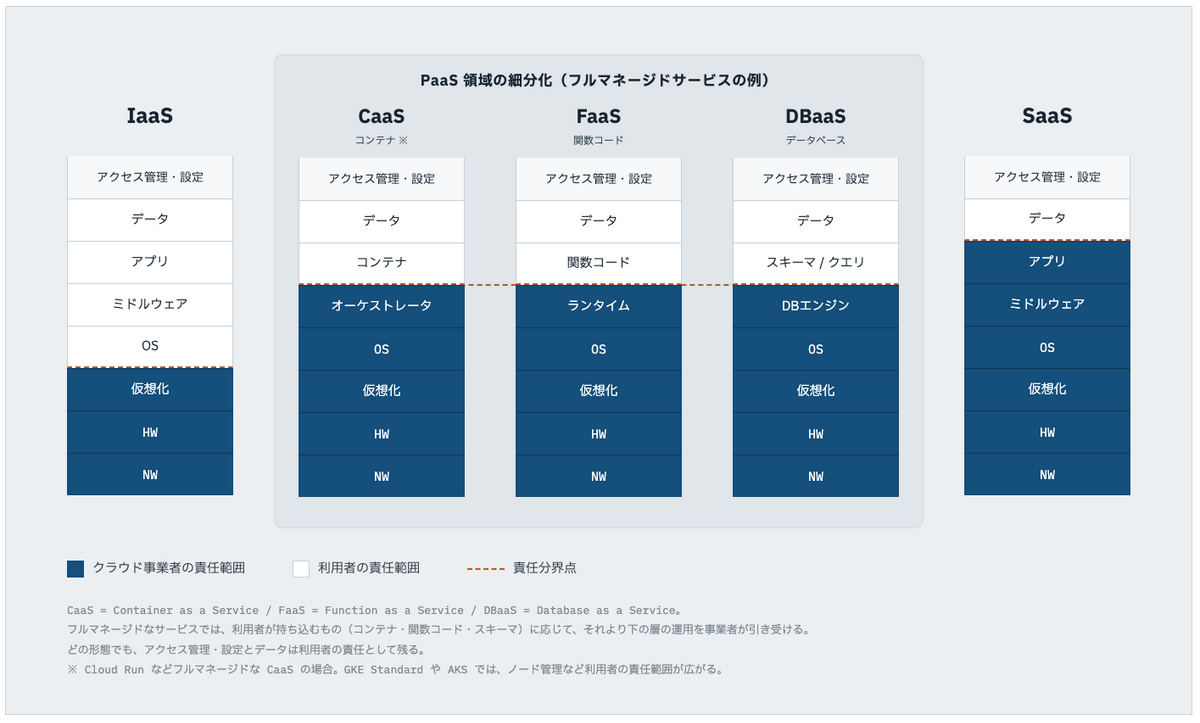
フルマネージドサービスは、インフラやミドルウェアの運用保守の大部分をクラウド事業者が自動化・代行するサービス形態です。IaaS / PaaS / SaaS が「どの層までをクラウド事業者に任せるか」というサービス形態の区分であるのに対して、フルマネージドは「運用の手間をどこまでクラウド事業者が引き受けるか」という度合いを表す言葉で、両者は別の軸の話です。
とはいえ、入門の段階では 「PaaS に近い位置づけで、運用保守の自動化がさらに進んだもの(PaaS+α)」 というイメージを持っておけば十分です。その中でも用途ごとに専門化したサービスとして、下図のような 3 種類が例として挙げられます。
- Container as a Service
- コンテナ単位でアプリケーションを持ち込み、実行と管理をするプラットフォーム
- Function as a Service
- 特定処理のコード(関数)をイベント駆動で実行するサーバーレス実行環境
- Database as a Service
- データベースの構築、バックアップ、スケーリングなどの保守運用を事業者が代行するサービス
ただし、同じ分類のサービスでも運用の手間は一様ではありません。例えば、CaaS には Kubernetes のクラスタを提供する GKE(Standard モード)や AKS のように、ノードの管理など利用者側の運用範囲が比較的広いものも含まれます。「CaaS だからフルマネージド」とは限らないので、サービスごとに利用者が何を管理する必要があるかを確認しましょう。
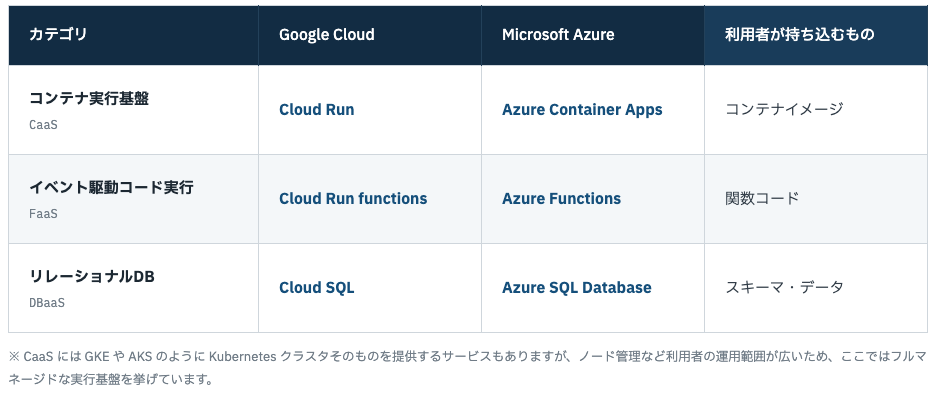
最後に Google Cloud と Azure で該当するサービス例を挙げます。個人的に Google Cloud 推しなので、CaaS といえば Cloud Run をぜひ知ってほしいです。その理由は、デプロイや運用の容易さやスケーラビリティ、コストの低さなどどれを取っても申し分ないと思っているからです。また、下記の表には掲載していませんが、NewSQL なら **Spanner**、DWH なら BigQuery が Google Cloud のフルマネージドサービスとして有名です。
このように 1 つのクラウドで主要なサービスの特性を理解しておくと、他クラウドの類似サービスを扱う際にも構造や役割の推測が容易になります。クラウドを知っていく上で業務に近かったり興味を惹かれるクラウドをどれか 1 つを深掘りしてから他クラウドにも手を伸ばすことをお勧めします。
2章 壊れる前提で、強くする
この章では、クラウドにおける耐障害性の基本思想とそれを実現する設計パターンを整理した内容としています。ここではステートレス設計をピックアップします。ステートレス設計は、分散システムにおける耐障害性を確保するために不可欠な要素となっています。
利用者からのリクエストを受け付けるサーバーが複数台存在するケースで、ステートフルな構成では特定のサーバーがダウンした際にそのメモリやローカルディスクに保持されたセッション情報が失われて、同一ユーザーからのリクエストを代替サーバーで引き継げないといったことが生じます。これに対してステートレスな構成ではノード間に機能上の個体差が存在せず、ロードバランサーが異常ノードを検知した瞬間にトラフィックを正常ノードへ切り替えるだけで復旧を完結させることができます。
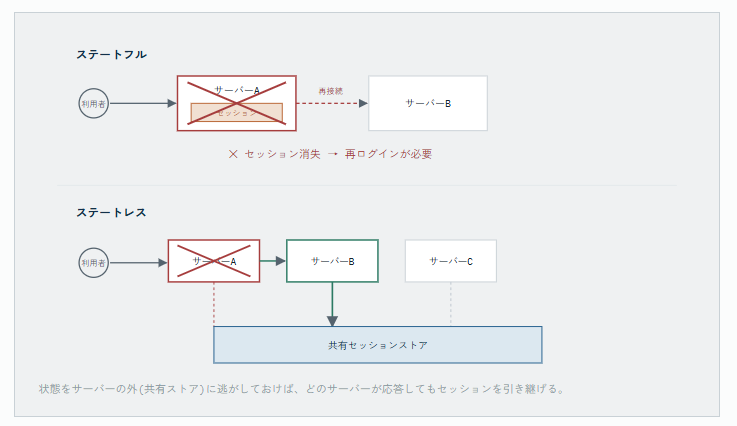
ステートをどこに逃がすかという具体的な実装はプロバイダーやアーキテクチャによって異なります(例えば、セッションやファイルは DB やキャッシュ、オブジェクトストレージなどの外部ストアに移すなど)が、ここで押さえておきたいのはサーバー自身は使い捨てにできる状態を保つという考え方そのものです。この考え方はスケーラビリティの前提とも言えるので、次で簡単に触れておきます。
深掘り②:スケーラビリティ
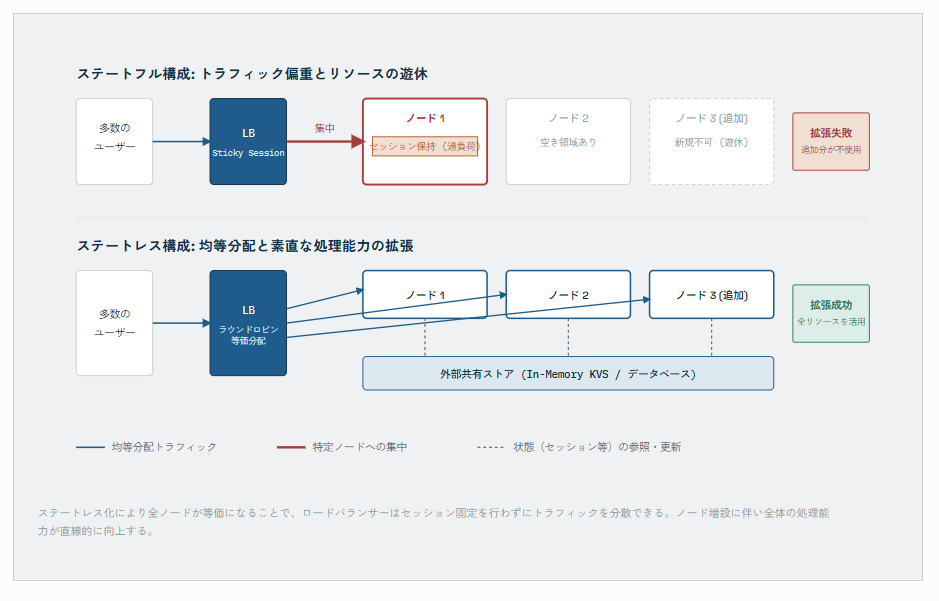
ステートレスな構成は、クラウドを触る上でよく耳にするスケーラビリティとも非常に関連性が高いです。スケーラビリティとは、システムの負荷増大に応じてリソースを追加して、処理能力を柔軟に拡張できる能力を指します。
計算リソースを追加して処理能力を高める水平スケーリング(スケールアウト)を成立させるには、すべての計算リソースは機能的に等価、つまり内部に状態を持たずに処理できることが求められます。これによりロードバランサーが特定のユーザーを特定ノードに依存せずトラフィックを分散できるため、計算リソースを追加した分だけ処理能力を拡張できます。
この内部に状態を持たない = ステートレスな構成であるため、スケーラビリティを得るための前提となるアーキテクチャになります。
3章 セキュリティの基本原則
この章では、クラウドの責任共有モデルにおいて利用者が責任を負う範囲を守るための、基礎的な原則を整理した内容としています。クラウドを安全に触る上で知っておくと良いセキュリティ観点の知識を詰め込んだので、他章より厚めにまとめます。
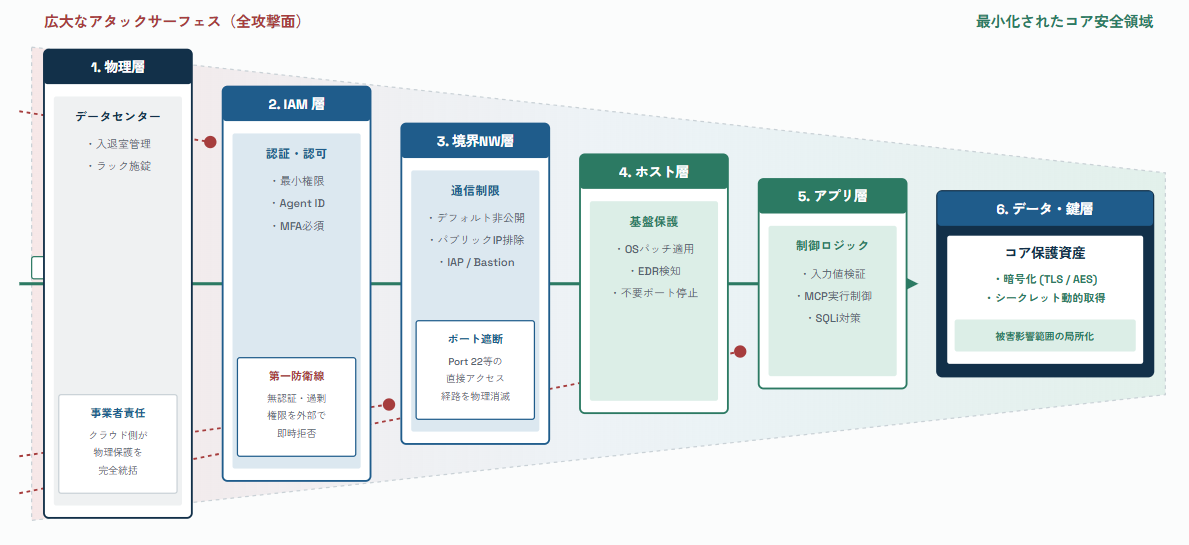
クラウドにおけるセキュリティ対策の目的は、大きく「攻撃を受けにくくする(予防)」と「何か起きた時に気づき、対処する(検知・対応)」の 2 つに分けられます。本章ではまず予防の考え方として、第三者が攻撃に利用できる面であるアタックサーフェイスを小さくするための 3 つのポイントに触れます。
- 最小権限の原則(IAM 層)
- ネットワーク境界設計(境界 NW 層)
- シークレット管理(データ・鍵層)
まずは、最小権限の原則です。クラウドを触る上で認証/認可(誰が何をできるかを制御する仕組み)が必要不可欠になります。この認証認可を司るサービスを IAM(Identity and Access Management)と言い、特定のアカウントに対して権限を付与することで制御を実現しています。
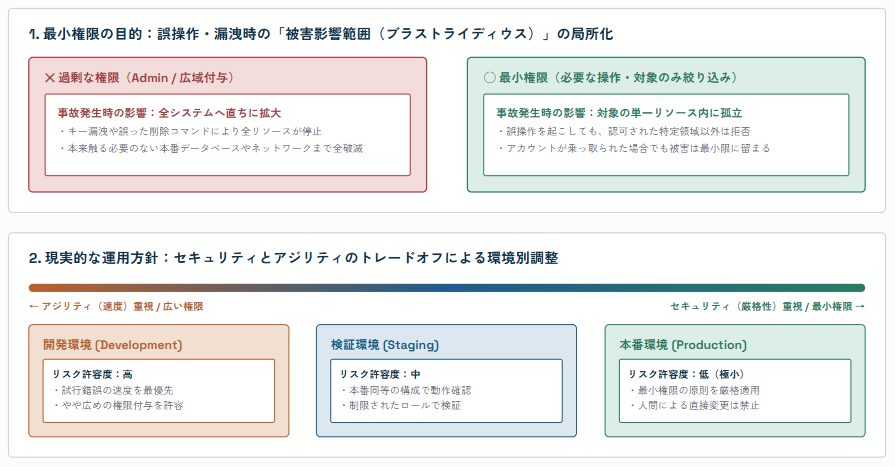
権限を付与する際に「必要最低限に留める」というのが最小権限の原則の根幹となります。なぜ必要最低限にするのかというと、アカウントの誤操作や認証情報の漏洩が生じた際の被害範囲の拡大を防ぐためです。
ただ、毎回本当に必要最低限で権限付与することはセキュリティを高める一方で開発や検証作業のアジリティを低下させるといったトレードオフを生じさせます。そのため、どの環境にも一律でこの原則を適用するというよりも開発 / 検証 / 本番といった環境の差異に応じて「どこまでリスクを許容できるか」を検討した上で権限付与の程度を変えることが現実的な運用となります。
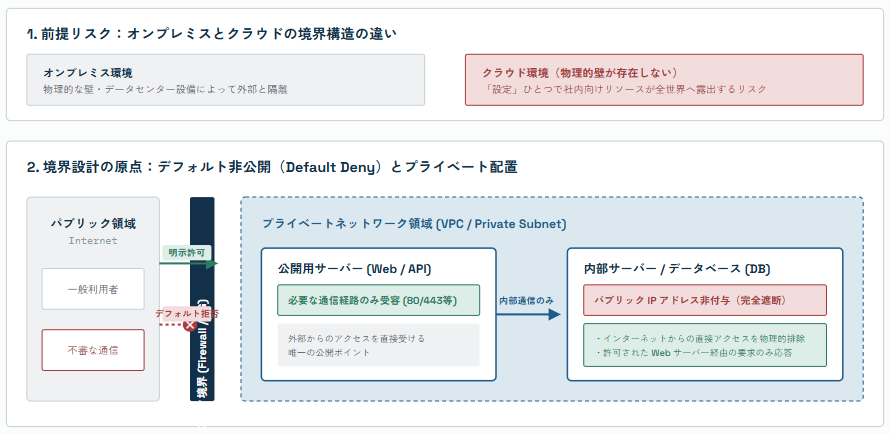
次はネットワークの境界設計です。クラウドにおけるネットワーク制御では、パブリック(公開)とプライベート(非公開)の領域を明示的に切り分け、通信経路を制御することが基本になります。
アクセスを許可する際の原則は「デフォルトで非公開とし、必要な通信のみを後から開ける」ことです。なぜデフォルト非公開にするのかというと、オンプレミス環境のような物理的隔絶が存在しないクラウドでは、設定変更ひとつで社内向けリソースが全世界へ露出してしまうためです。データベースや内部向けサーバーに安易にパブリック IP アドレスを付与せず、プライベートネットワーク内に配置した上で、許可された通信経路のみを明示的に開ける設計が求められます。
最後にシークレット・認証情報の扱いです。クラウドを触っているとデータベースへのアクセス情報やアカウントの認証キーなどの公開すべきではない情報に触れる機会が増えます。これらの情報は、公開されてしまうと想定以上の被害を被る可能性の高い情報なので扱いはより一層慎重になる必要があります。
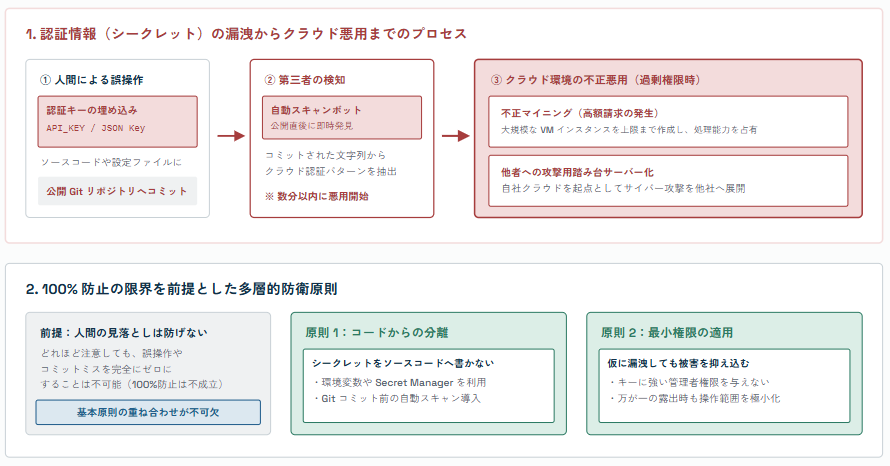
被害の具体例として、アカウントの認証キーの漏洩によってクラウド環境が悪用されるといったことがあります。アカウントの認証キーとは、特定の文字列や JSON ファイルであることが多く、それさえあれば該当のアカウントとして認証でき権限を行使できるものを指します。アカウントに過剰な権限を付与した状態で認証キーを払い出し、これを誤って公開リポジトリにコミットしてしまったとします。悪意のある第三者がこれを発見してしまえば、そのアカウントに付与されている権限を行使できてしまいます。例えば、VM を可能な限り作成してマイニング用の処理サーバーとしたり、他社を攻撃するための踏み台サーバーにするといった悪用方法があります。
こういったセキュリティインシデントを 100% 発生させないということは難しい話です。人間が操作していれば見落としや誤操作は発生しうるものだからです。具体例に出たアカウントの認証キーについては払い出さないことを第一の選択肢としつつ、シークレット・認証情報を扱う際には、こちらで記載した基本原則を守ることでそのリスクを低くしながら運用することが非常に重要となります。
深掘り③:AI エージェント専用の識別子
少し前までクラウド上で権限が付与される対象は人間用のアカウントかマシン用のアカウントでした。しかし、AI エージェントがアプリケーションに組み込まれることが多くなってきた昨今では、エージェント専用のアカウントを割り当てて管理するサービスも出てきました。Google Cloud で言えば、Agent Identity といったサービスが存在します。従来のマシンアカウントでは要件を満たせないエージェントの挙動に対して制御や追跡が可能となります。
深掘り④:AI エージェントによるクラウド操作の代行
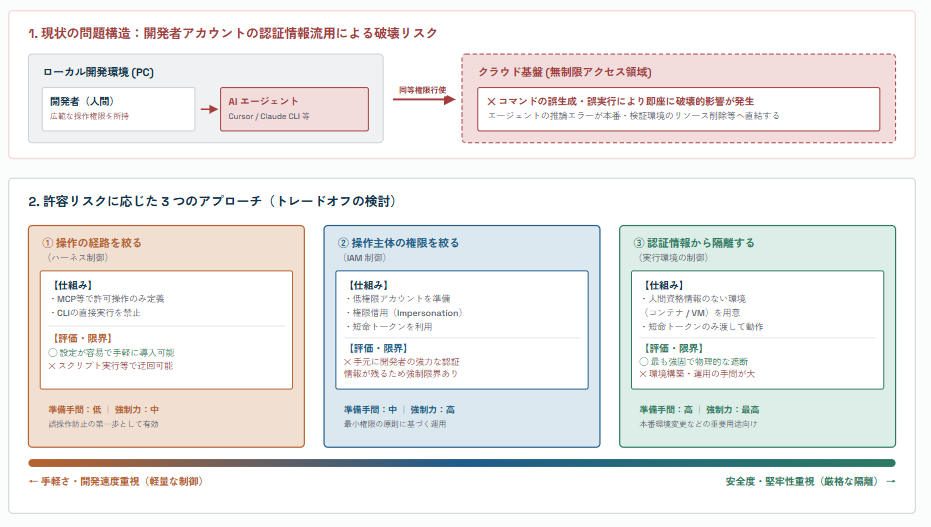
Cursor や Claude などをエディターやターミナルで動かして、人間の操作を代行させることが当たり前になってきました。その一例として、開発者であればクラウドへの操作もエージェントに代行させることがあると思います。この時エージェントは誰の権限を使ってクラウドに操作をするかというと、多くの場合に開発者自身(人間用アカウント)の認証情報を流用してクラウドを操作しています。
手元の開発作業を円滑に進めるため、人間用のアカウントには開発環境全体の閲覧や変更といった広い権限が割り当てられている場合が多いと思います。この状態でエージェントがコマンドの生成や実行を誤ると、意図しないリソースの削除や構成変更が即座に実行されるリスクが生じます。
このリスクを抑えるには、エージェントがクラウドを操作する際に許容する操作と許容しない操作の境界をどのように強制するかが問題となります。ここで押さえておきたいのは、ローカルでエージェントを動かしている限り、エージェントは開発者と同じ環境・同じ認証情報を使える状態にあるということです。以下のような対策を複数組み合わせて、許容できるレベルまでリスクを下げるという考え方が重要です。
- 操作の経路を絞る(ハーネスでの制御)
- MCP サーバー上に許容する操作だけを定義してそこを経由させ、エージェント側の設定で CLI の直接実行を禁止
- 誤操作の防止には手軽で効果的だが、スクリプト経由などで迂回される余地は残る
- 操作する主体の権限を絞る(IAM での制御)
- 人間用アカウントではなく、低権限のアカウントとして操作させる
- Google Cloud では権限借用を用いて、認証キー無しで短い期間有効なトークンを利用可能
- ただし、人間用アカウントの認証情報が手元に残るため、強制力はない
- 人間の認証情報から隔離する(実行環境での制御)
- 人間用アカウントの認証情報がないコンテナや VM でエージェントを動かし、最低限の権限を持つ短命なトークンだけを渡す
- 最も強固な一方で、準備と運用の手間がかかる
すべてを常に実施する必要はなく、環境に応じたリスク許容で判断するのがよいと思います。重要なのは、「エージェントは自分と同じ権限を持っている」ことを意識した上で、どこまで任せるかを自分で決めることです。
深掘り⑤:パブリック IP アドレスの不付与
VM などにインターネット経由でアクセスする際にパブリック IP アドレスは便利です。しかし、インターネット経由で自分がアクセスできるということは他者もアクセスできる可能性があるとも言えます。他者がアクセスできる可能性が 0% でないなら、適切なセキュリティ設定をする必要があります。
その適切なセキュリティ設定を考えることももちろんですが、まずはパブリック IP アドレスが本当に必要かどうかを検討します。例えば、開発作業用の VM を作成して SSH したいといったケースを考えます。パブリック IP アドレスを付与したくなるところですが、昨今のクラウドではパブリック IP アドレスを付与しなくても VM に SSH 可能なサービスや機能があるので、そのサービスの利用検討から始めることをお勧めします。
主要なクラウド事業者では、パブリック IP アドレスを持たない VM へ安全に接続するための専用機能を提供しています。
Google Cloud:IAP(Identity-Aware Proxy)
- インターネット経由で Google の認証/プロキシ基盤に接続してから、Google 専用のネットワークを通って VM の内部 IP に安全にアクセスできる
- IAP を利用することでパブリック IP アドレスの付与なしに VM へ SSH 可能となる
Azure:Azure Bastion
- パブリック IP アドレスは必要だが、VM に付与するのではなく Azure Bastion にのみ付与する
- Azure Bastion はインターネット経由でアクセスしたいリソースの前段に置かれ、アクセスポイントを集約する
- VM にパブリック IP アドレスを付与するのと異なり、22 番ポートを公開せずに 443 番ポートでのアクセスになるため 22 番ポートを直接露出することで生じるリスクを回避できる
インターネット経由でリソースにアクセスする際は、対象のリソースに必ずパブリック IP が必要ということにとらわれず、提供されている機能やサービスを駆使してアクセスできないかをまずは検討してみてください。
深掘り⑥:シークレット/認証情報のアプリケーションでの取り扱い
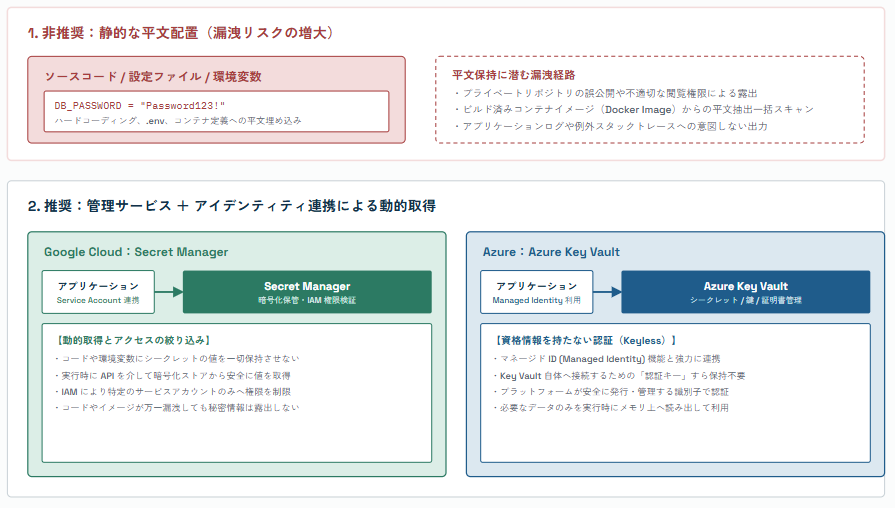
深掘りの最後は、データベースのアクセス情報や外部 SaaS の API キーなど、アプリケーションで扱わざるを得ないシークレットや認証情報についてです。アプリケーションでこういった情報を使いたい時の安易な選択肢として、アプリケーションコードへのハードコーディングや設定ファイル・デプロイ定義に平文で書くことが考えられます。
上述した通り、シークレットや認証情報は漏洩により大きな被害をもたらす可能性があります。漏洩の 1 つの原因は平文での設定です。コンテナ内だから安全だろう、プライベートリポジトリだから誰にも見られないだろう、そういった考えから平文のまま扱うことは漏洩リスクを高めます。
主要なクラウド事業者ではシークレットや認証情報を安全に扱うためのサービスを提供しています。
- Google Cloud:Secret Manager
- API キーやデータベースの接続文字列などの秘密情報を、暗号化した状態で一元管理するサービス
- アプリケーションのコードやコンテナの環境変数に平文で値を保持させる代わりに、アプリケーション実行時に API を介して動的にシークレットを取得する構成をとる
- IAM と連携させることで、特定のサービスアカウントを持つアプリケーションのみに読み取り権限を絞り込むことが可能となる
- Azure:Azure Key Vault
- シークレット、暗号化キー、API キーや証明書を安全に保護・一元管理するためのマネージドサービス
- マネージド ID(Managed Identity)機能と組み合わせることで、Key Vault 自体にアクセスするための認証キーすらアプリケーション側に保持させる必要がなくなる
- アプリケーションは実行時に自らのマネージド ID を用いて Azure Key Vault へ認証して、必要な秘密情報のみをメモリ上に読み出して利用する
これらのサービスを使うメリットは、平文を置かないことだけではありません。シークレットをバージョン管理できるため、定期的なローテーションや、漏洩時の差し替えがしやすくなります。また、誰がいつシークレットにアクセスしたかを監査ログで追えるようになります。
ソースコードや静的な設定ファイルへシークレットを平文で記述する運用は漏洩のリスクを高めるため、管理サービスで一元管理した上で実行時に取得する構成を設計の基本として採用してみてください。
おわりに
これからクラウドを触りたい・知りたい方向けに私の経験から知っておくと良い心構えを Part1 として「オンプレミスとの違い」「耐障害性の基本思想」「セキュリティ」の 3 つの観点でまとめました。
少し心構えから脱線して具体の話もありましたが、ここまで読んでくださった方が少しでも勇気と自信を持ってクラウドを触れるマインドセットになっていれば幸いです。Part2 にもご期待ください!