- 宮下悠希
- 約 4,500 文字
目次
はじめに
本記事では、なぜITコンサルを主軸とするフューチャーが独自のAIアクセラレータ開発に踏み出したのか、その背景と独自開発のハードウェア『Mark-I』の全貌についてご紹介します。
なぜ、ITコンサルが「ハードウェアの自作」に挑むのか?
フューチャーの本業はITコンサルティングおよびシステムインテグレーション(SI)です。一般的なイメージであれば、「最先端のAIモデルをどうビジネスに適用するか」というソフトウェアやクラウドのレイヤーに終始するのが自然かもしれません。
しかし、私たちが「チップのアーキテクチャ設計」というハードウェアの領域にまで踏み込んだのには、実務上の課題に根ざした理由があります。
それは、「ソフトウェアだけの最適化では、間もなく限界が訪れる」 という現実があるからです。今後、自動運転、ロボティクス、スマート工場といった物理世界(フィジカル空間)にAIが溶け込んでいく時代において、求められるのは「リアルタイムな処理」と「限られた電力での動作」です。
既存の汎用的なハードウェア(GPUなど)の上にソフトウェアを載せるだけでは、データ転送やOSのオーバーヘッドによる「遅延(レイテンシ)」を完全になくすことは困難です。私たちが目指すのは、フューチャーが培ってきた課題解決力に、「計算機そのものを自社でデザインし、低遅延を極限まで追求する力」 を掛け合わせることです。
ビジネスの現場で真に必要とされる計算機を、ハードウェアの形から自作して届ける。このアプローチこそが、フューチャーが次世代のサービスやシステムを支えていくための重要なアプローチとなっています。
なぜ、今「FPGAでAIアクセラレータ」なのか?
消費電力などのリソースが限られた環境において、いかに高速に推論するか。この難題を「ハードウェアから解決する」ために、私たちが選定したのがFPGA(Field Programmable Gate Array) です。
一般的なGPUは、あらかじめ用意された大量の小さな演算コア(回路)を使い、「ソフトウェアの命令」によって膨大なデータを並列に計算する構造です。同時に大量の演算ができる反面、命令コードを読み込まないと実行できないノイマンボトルネックと言われる遅延や電力消費を減らしにくい欠点を持ちます。一方で、FPGAは、回路の接続を直接プログラムすることで命令コードを使わずに計算を行える方式であるため、処理の遅延(レイテンシ)が極めて少なく、マイクロ秒単位の低レイテンシと低消費電力化を同時に実現できます。
必要な回路だけを作るため無駄がなく、CPU/GPUのように複雑なOSやソフトウェアレイヤーを介さない「フルハードウェア制御」への落とし込みが可能です。そのため、処理の遅延(レイテンシ)を小さく抑えられるだけでなく、負荷による処理時間のばらつきが極めて少なく、「リアルタイム保証(デッドライン保証)」を満たすための予測可能性(確実性)が非常に高い という強みを持っています。
この「低遅延」と「優れたリアルタイム保証(デッドライン保証)のしやすさ」こそが、ミリ秒・マイクロ秒単位の応答が求められるエッジAI領域において、私たちがFPGAを採用する大きなメリットとなっています。
自社開発AIアクセラレータ『Mark-I』の紹介
こうした思想のもと、フューチャーが独自にアーキテクチャ設計から手がけた初代AIアクセラレータが 『Mark-I』 です。
Mark-I構成図
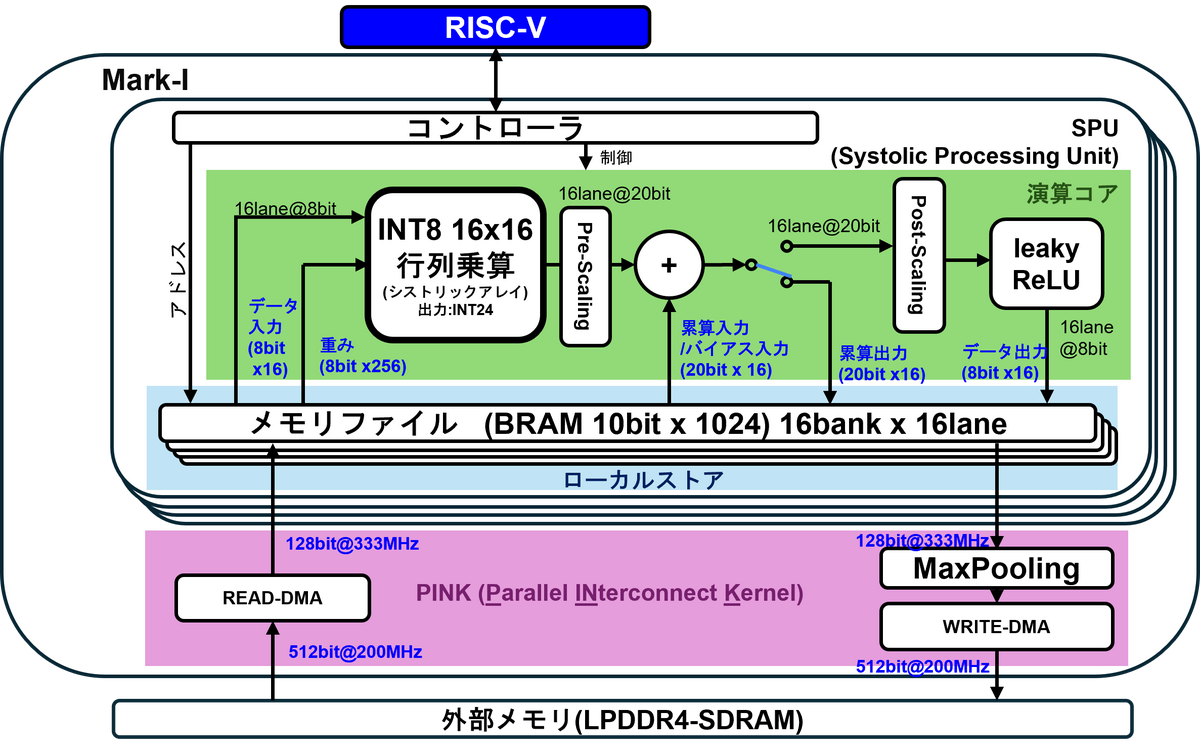
アーキテクチャと内部構成
『Mark-I』は、高負荷な積和演算の高速化と、データ転送のボトルネック解消を同時に実現するため、主に以下の3つのコンポーネントを軸に設計されています。
- 独自演算コア「SPU(Systolic Processing Unit)」
ディープラーニングにおける膨大な行列乗算を効率化するため、16×16 の INT8 のシストリックアレイ を採用しています。データを一方向・格子状に効率よく流しながら積和演算を連続処理することで、メモリへのアクセス回数を劇的に減らしています。さらに、MaxPoolingやLeaky ReLUといった活性化関数回路もアレイの直後にハードウェアとして組み込んでおり、推論の一連のプロセスを止めることなくワンストップで高速処理します。 - 高速データ転送ユニット「PINK(Parallel INterconnect Kernel)」
どれだけ演算器が高速でも、外部メモリ(LPDDR4-SDRAM)とのデータ供給が追いつかなければ「待ち時間」が発生してしまいます。これを防ぐのが、独自に組み込んだAXI4 512-bitのデータ転送ユニット「PINK」 です。PINKは演算コアの裏側で完全に並列動作し、次の演算に必要なデータや重み情報をあらかじめローカルストアに先読みすることで、データ転送によるボトルネックを極限まで排除しています。 - 内蔵「RISC-V コントローラ」とランタイムソフトウェア
ハードウェア全体を統括し、柔軟な制御を担うのが内蔵されたRISC-Vコントローラです。ハードウェア側から複雑な条件分岐や制御ロジックを排除し、少ないリソース(低消費電力)で高クロックでも安定して動作する回路設計を両立するため、本アーキテクチャでは内蔵のRISC-Vコントローラに制御の複雑性を担当させる設計を採用しています。モデル開発、量子化、チューニングなども独自に行っており、出来上がったAIモデルの演算フローをソフトウェア側で緻密にコントロールし、ハードウェアの演算リソースを最大限に引き出せるようにしています。
主要スペック(2026年2月時点仕様)
※詳細については、フューチャー株式会社 プレスリリース(2026年2月27日発表) をあわせてご参照ください。なお、さらなる高速化・高性能化に向けて現在も開発を進めています。
| 項目 | 仕様 | Item | Specification |
|---|---|---|---|
| 対応FPGA | Efinix Ti375 | FPGA Platform | Efinix Ti375 |
| 演算性能 | 1.36TOP/s(INT8) | Compute Performance | 1.36TOP/s(INT8) |
| コア周波数 | 333MHz | Core Frequency | 333MHz |
| 演算アーキテクチャ | SPU 8×16×16 シストリックアレイ | Compute Architecture | SPU 8×16×16 systolic array units |
| ローカルメモリ | 合計 18.8Mbit(各SPU:2.3Mbit) | Local Store | 18.8Mbit total(2.3Mbit per SPU) |
| データ転送 | PINK:AXI4 512-bit データ転送ユニット (演算と並列動作) | Data Transfer Engine | PINK:AXI4 512-bit data transfer unit (operating in parallel with computation) |
| 対応畳み込みサイズ | 1×1, 3×3 | Supported Conv Sizes | 1×1, 3×3 |
| プーリング | なし、2×2 Max Pooling | Pooling | None, 2×2 Max Pooling |
| 活性化関数 | なし、ReLU、Leaky ReLU | Activation Functions | None, ReLU, Leaky ReLU |
| 処理単位 | 入出力とも16チャネル単位で処理 (不足分はゼロ埋め) | Processing Unit | Processed in 16-channel blocks (zero-padded when not aligned) |
実証デモによる動作比較
ここでは、実際にMark-Iを用いたリアルタイム顔認識のデモ動画を紹介します。
画面左側の 『CPU上でのソフトウェア実行』 では、アクセラレータなどの専用ハードウェアを用いずに処理させているため、演算負荷の高さから動作が追いつかず、フレームレートが1 FPSにとどまっています。一方で、画面右側の 『Mark-IによるFPGA実行』 では、専用に設計されたハードウェア回路の特性を活かすことで、フレームレートが 15 FPSへと向上(約15倍の処理効率)しています。
カメラが捉えた対象を遅延なく認識・追従し続ける様子から、特定の用途に向けて構成された専用回路による処理がエッジAI処理においてどのような効果をもたらすか、その挙動の違いが確認できます。
リアルタイムジェスチャー認識(パンチゲーム)デモ
続いて、Mark-Iの応答性を応用した、リアルタイムでのジェスチャー認識によるゲーム形式のデモ動画を紹介します。
このデモでは、カメラを通じて入力される画像から「手のこぶし」をリアルタイムに検出し、特定のジェスチャー(パンチ動作)をトリガーにして得点が加算されるシステムを構築しています。
遅延の発生しやすい環境ではユーザーの素早い動きと画面上の判定にズレが生じてしまいますが、FPGAを用いた低遅延処理によって、繰り出されたパンチの瞬間を捉え、即座にゲームスコアへ反映させています。
未来への挑戦:研究機関としての知見を深める産学連携体制
最先端の計算機科学を探求し、より深い知見を社内に蓄積・還元するため、私たちは大学との強力な産学連携体制を敷いています。フューチャーのメンバー自らが「客員研究員」や「受託研究員」として各大学の研究活動へ参画し、最先端技術の共同研究を強力に推進しています。現在、以下の3名の専門研究員を中心に、次世代アーキテクチャの種まきを進めています。
- 東京科学大学 客員研究員
スピントロニクス技術とインメモリコンピューティング(IMC)を融合させた、次世代ハードウェアアーキテクチャ開発を推進しています。(2026年4月〜) - 千葉工業大学 受託研究員
リアルタイムAIを支える次世代シーケンス処理コアの研究、およびSSM-FPGAによるリアルタイム音楽生成アクセラレータの開発を担っています。(2025年9月〜) - 千葉工業大学 受託研究員
FPGAの上限に挑むための超高密度な回路実装や、演算リソースを限界まで引き出す超並列計算アーキテクチャの最適化を研究しています。(2025年9月〜)
既存のシリコンアーキテクチャの枠を超え、学術界の知見と融合しながら自社メンバーが深く技術を探究することで、エッジAI領域におけるハードウェアの可能性を一歩先へと押し進めています。
まとめ
私たちが手掛けているAIアクセラレータの開発は、単なるコア技術の実験にとどまりません。ここで蓄積された知見や成果は、将来的にフューチャーグループが提供する多様なITソリューションにおいて、エッジ領域での課題解決や新たな価値提案を支えるための技術的選択肢を広げることにつながっています。
ソフトウェアとハードウェアの両面からアプローチすることで、これまでアプローチが難しかった低遅延推論や効率化の可能性が見えてきます。フューチャーはこれからも、既存の枠組みにとらわれず、次世代のコンピューティング技術を先駆けて探究・実証し、社会やビジネスへ新たな可能性を還元できるよう、研究開発を進めていきます。