- 永井優斗
- 約 9,200 文字
目次
はじめに
Future Value Group(FVG)&CodeCamp兼務出向中の永井です。
私は、関数型プログラミングのコードを読むのがあまり得意ではありませんでした。読むことはできるのですが、すんなり読めない。今でもちょっと苦手意識があります。
この記事は、その苦手意識の正体を考えてみた記録です。プログラミングパラダイムの歴史を解説する記事ではありません。読み方が増えてきた背景だけ、必要な範囲で確認します。追いかけたいのは「コードを読むとき、私たちは頭の中で何をしているのか」という問いのほうです。
なお、歴史的な事実には出典を付けましたが、「パラダイムごとに、コードへ投げる問いが違うのではないか」という記事の中心部分は、筆者の仮説であり考察です。研究で証明された話ではありません。
この記事では、特に断りがない場合はTypeScriptを使ってコード例を記載します。
以下、商品の配列をitemsと書きます。配列の要素である商品Item型は次のとおりです。
type Item = { active: boolean; price: number }; |
この記事のコードは、断りがない限りこのitemsを集計する同じ処理です。パラダイムごとの説明で別の題材を使うときは、その都度そう書きます。
mapもfilterもreduceも知っている、はずなのに
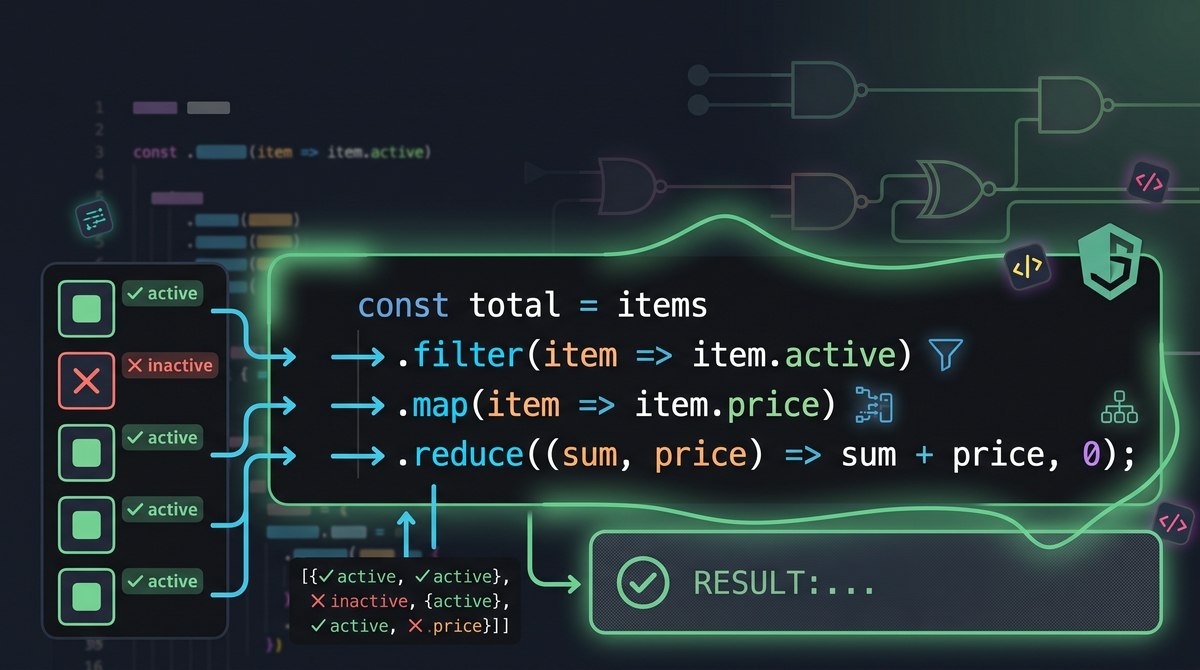
mapは知っています。filterも知っています。reduceも一応使えます。1つずつなら、何をするものか説明もできます。それなのに、こう書かれると少し頭を使います。
const total = items |
一方、こちらは比較的すんなり読めます。
let total = 0; |
やっていることは、ほぼ同じです。有効なitemの価格を合計している。それだけです。
では、この差はどこから来るのでしょうか。
「関数型プログラミングの知識が足りないから」だと、私はずっと思っていました。ただ、原因は知識の量ではなく、読み方のほうにあるのかもしれない。そう思うようになりました。
「読める」とき、頭の中で何をしているのか
自分が後者のコードをどう読んでいるかを意識してみると、だいたい、こんな感じです。
- totalは0
- itemを1つ取り出す
- activeかどうか確認する
- priceをtotalに足す
- 次のitemへ
変数の状態を保持して、1行ずつ実行を進めている。追っているのは、一貫して同じ問いです。
次に何が起きるのか?
では、前者のコードを同じやり方で読むとどうなるか。
「まずfilterが実行されて、配列が1つできて。次にその配列に対してmapが実行されて、また別の配列ができて。最後にreduceが……」読めます。読めますが、しんどい。filterが返す配列と、mapが返す配列。この2つの中間状態を、頭の中で持ち回ることになるからです。しかも合計の意味を読む段階では、その中間配列の中身まで追う必要はありません。
そこで、視点を変えてみます。
items(全部のitem) |
処理の順番そのものが消えるわけではありません。ただ、ここで見ているのは、ある値が別の値へ変換されていく流れのほうです。
こう見ると、中間配列を保持する必要がなくなります。各段階で「いま何という値なのか」だけ分かればいい。
関数型が読みにくかったのではなく、命令型のための読み方を関数型のコードにも当てはめていた。単に道具が合っていなかっただけかもしれないのです。
そして次に気になったのが、「読み方が複数ある」とはどういうことなのか、でした。それを考えるために、プログラミング・パラダイムの背景を少し調べてみます。
人は、巨大化するプログラムをどう理解しようとしてきたのか
ここからは背景の話です。年表は追わず、人間がプログラムを理解するために何をしてきたかという一点だけを、駆け足で見ていきます。
命令型 ― 次に何が起きるのか
出発点は、機械への命令の列です。メモリの状態を、上から順に書き換えていく。
let a = 1; |
a = bだけを見ても、入れ替えの途中だとは分からないのが面白いところです。「aをbにする」としか書いていません。定型として覚えていなければ、1行ごとに頭の中の値を更新していくことになります。tmpは1、aは2、bは1。追っている問いは終始これです。
次に何が起きるのか?
機械の状態を、命令の列で順に書き換えていく。読み手も頭の中にメモリを用意して1行ずつ実行する、機械に近い読み方をします。ここが出発点です。このあと出てくる4つは、それぞれ別の出自を持っていて歴史としては一本の線ではありませんが、共通点があるかどうかは並べたあとで戻ります。
構造化プログラミング ― 制御はどう流れるのか
先に、gotoの話をします。正直に書くと、私は仕事でgotoを書いたことが一度もありません。「指定した行へ飛べ」という命令で、行にラベルを付ければどこからでもジャンプできます。冒頭と同じ集計を擬似コードで書くとこうなります。
total = 0 |
for文もwhile文も使わずに、繰り返しが作れています。問題は読むときです。gotoはどこからでも飛び込めるので、ある行に来たとき何が成り立っているかを、飛び元まで遡って確かめないと分かりません。行は上から下へ並んでいるのに、実行の流れはそのとおりに進まない。その差を読み手が埋めることになります。1968年のDijkstraによるgoto批判1は、このあたりを扱ったものとして有名です。
同じ集計を、TypeScriptで素直に書くとこうなります。
let total = 0; |
中括弧の外から飛び込んでくる経路がないので、ループへの入り方と繰り返す範囲が構文から読み取れます。
制御はどう流れるのか?
プログラムを、決まった形の部品(順次・分岐・反復)だけで組み立てる。大事なのは、どの部品も「入口が1つ、出口が1つ」だという点です。中身を読まずに「itemsを一周して何かする箱」として畳んでおける。名前を付けてsumActivePrices(items)のように切り出せば、呼ぶ側は1行だけ読めばよくなります。この分解を主役にした書き方は、手続き型と呼ばれることもあります。
どの処理に分解されているのか?
オブジェクト指向 ― 誰がこの責任を持っているのか
構造化の流儀なら、注文のキャンセルはこう関数で書けるはずです。
type Order = { status: "open" | "cancelled" }; |
ところが実際には、こう書かれているのを見ることが多い気がします。
class Order { |
order.cancel()のほうです。動きは同じですが、この書き方はOrderがcancelの受け手になっていることを決めています。実際の処理をOrder自身が持つのか、別のオブジェクトへ頼むのかまでは決まりません。決まっているのは、まず誰に言えばいいかです。#付きフィールドはクラスの外から触れないので、「statusへ代入しているのはどこか」を探す範囲もクラスの中だけで済みます(いつ書き換わるかは、呼んでいる側を見に行く必要があります)。
なぜ、キャンセルする責任(役割)をOrderが持っているのか?
もう1つ、cancelAll(targets)のように渡されたものを片端からキャンセルする関数を考えます。target.cancel()が実際にどの実装を呼ぶのかは、このコードを読んでも決まりません。ループの範囲は構文から読めますが、呼ばれる中身のほうは実行時に差し替わる。呼ぶ側が相手の正体を知らなくて済む、という利点と引き換えです。
誰がこの責任を持っているのか?
これは教科書でいうカプセル化とポリモーフィズムの話です。
関数型 ― この値は何から何へ変換されるのか
冒頭のfilter/map/reduceを、名前を付けた関数で書き直してみます。
const isActive = (item: Item) => item.active; |
isActiveもtoPriceも変数に入っていて引数として渡せます。冒頭のfilter/map/reduceが成り立つのは、関数そのものが値だからです。
total(初期値0)をtotal += item.priceで書き換える関数は、同じ引数{ active: true, price: 400 }で2回呼ぶと1回目はtotalが400、2回目は800になります。何回呼んだかが結果に影響する。一方(sum, price) => sum + priceは、同じ2つの数値を渡せば何度呼んでも同じ値を返し、外の状態も読み書きしない純粋関数です。
この値は、何から何へ変換されるのか?
純粋な式なら、書き換えの履歴でなく定義と入力を見れば答えが出ます。追いかける方向が「実行の流れ」から「値の来歴」へ変わるわけです。小さな変換を繋ぐ関数合成でも同じことが起きます。activeItems → prices → sumと繋げば、見るのは各関数の入口と出口だけで済みます。構造化の「入口が1つ、出口が1つだから箱として畳める」の、値についての版だと思っています。
宣言型 ― 何が欲しいのか
ここまでのコードには程度の差はあれ「どうやるか」が書いてありました。それを書かない選択肢があります。
SELECT |
SQLでは、どのインデックスを使うか、どの順で探すかを何ひとつ指定していないのに動きます。同じことをTypeScriptの命令型のループで書けば、1件ずつ見て条件で弾いて集めて並べ替える手順が全部並びます。
SQLを読む際の問いは、
何が欲しいのか?
になります。
書き手は手順を決める権利を手放し、読み手はその分身軽になります(性能を調べるときは実行計画という手順を覗きに行くことになりますが…)。背景には1970年の関係モデル2があり、機械の内部でのデータの表現や編成が変わっても、アプリケーションへの影響を抑えることが目指されました。この枠に入るのはSQLだけではありません。HTMLの<ul><li>も「こういう構造である」としか書いておらず、どう描画するかはブラウザが決めます。フロントエンドのテンプレート構文もこの延長線上です。あとで戻ってきます。
「読むための問い」を並べてみる
ここまでを、一度並べてみます。
| パラダイム | コードを読むときの問い |
|---|---|
| 命令型 | 次に何が起きる? |
| 構造化 | 制御はどう流れる? |
| 手続き型 | どの処理に分解されている? |
| オブジェクト指向 | 誰がこの責任を持っている? |
| 関数型 | この値は何から何へ変換される? |
| 宣言型 | 何が欲しい? |
この表は、パラダイムの厳密な定義ではありません。 そもそも分類の軸が揃っていませんし、互いに重なってもいます。1つのコードを、複数の見方で読むこともできます。
そもそも「プログラミング・パラダイム」という言葉の使い方自体にも批判があるようです。この語を広めたのは、1978年のチューリング賞講演でのRobert W. Floyd3でした。ただ、その使い方はもとにした哲学の概念から離れてしまっている、という指摘が最近も出ています4。
やりたいのは分類ではなく、選択です。「このコードには、どの問いを投げると読みやすいか」を選びたいだけです。
そしてFloydの講演には、この記事の関心に近い一文があります。プログラミング全体の進歩が新しいパラダイムを必要とするなら、プログラマ個人の進歩は「自分のパラダイムのレパートリーを広げること」を必要とする、という趣旨です。原文では次のように言っています。
… advancement of the art of the individual programmer requires that he expand his repertory of paradigms.
レパートリー、という言い方が気に入っています。持ち札が複数あって、場面で選ぶ。私が言いたいことも、たぶんこれに近いのだと思います。
命令型のところで「共通点があるかどうかは、あとで戻ります」と書きました。命令型を出発点にすると、あとの4つはどれも、この記事で取り上げた側面に限れば読み手の追跡範囲を狭める方向に働いています。 中括弧の外から飛び込まれない。代入箇所がクラスの中に収まる。純粋関数の範囲では、値が書き換わらない。手順そのものを書かない。手段はばらばらですが、状態遷移を端から端まで追わなくて済む場面が増える、という点では重なります。
TypeScriptへ帰ってくる
背景の話はここまでにして、普段書いている言語へ戻ります。
まず、冒頭のコードをもう一度読んでみます。
const total = items |
最初はこれを「filterが実行されて、次にmapが実行されて」と順番で追っていました。今度は問いを変えて、「この値は何から何へ変換される?」を投げてみます。
- items … すべての商品
- filterのあと … 有効な商品
- mapのあと … その価格
- reduceのあと … 合計
4行を、4つの状態の名前として読む。こう読むと、途中の配列の中身や、sumが各時点でいくつなのかは追わなくて済みます。
白状すると、これで劇的に速く読めるようになったわけではありません。ただ、自分がどこで手間をかけていたかは見えました。さきほど「中間状態を頭の中で持ち回る」と書きましたが、まさにそれをやめられる、という話です。
同じことは、他の書き方にも当てはまりそうです。TypeScriptはマルチパラダイム言語なので、1つのリポジトリの中に複数の思考モデルが同居しています。
読むモードのほうを、意識的に切り替えてみます。
- for文やwhile文を見たら → 次に何が起きる?
- classを見たら → 誰がこの責任を持っている?
- map / filter / reduceや関数合成を見たら → この値は何から何へ変換される?
- テンプレート構文(Vue.jsなど)を見たら → 何が欲しい?
宣言型の章で「あとで戻ってきます」と書きました。ここで戻ります。画面まわりは、2つの問いを続けて使うことになるからです。
さっきの有効な商品を、そのまま画面に出してみます。
// itemsはref、computedはvueからのimport(いずれも省略) |
<ul> |
(ここだけItem型に画面表示用に id と name も持たせています。)
上は冒頭と同じfilterです。ここは「この値は何から何へ変換される?」で読めます。商品の一覧が、有効な商品の一覧になる。
下はHTMLにv-forが足されただけの形です。さっきの<ul><li>と同じで、「画面をどう書き換えるか」は書いてありません。商品が増えたときにDOM(画面を組み立てている要素のまとまり)へ何を追加するか、減ったときに何を消すか。そういう手順はどこにもない。
書いてあるのは「activeItemsがこうなら、画面はこう見える」という対応関係だけです。こちらは「何が欲しい?」で読む。 SQLやHTMLと同じです。
前の章では、パラダイムごとに別の題材を使いました。gotoの擬似コード、order.cancel()、SQL。ばらばらの世界の話に見えたかもしれません。
でも実際に書いているコードでは、1つのファイルの中に2つの読み方が並んでいます。 問いを切り替える、というのはこういう場面のことです。
コードによって、有効な問いが違う。それだけの話です。
ただし一対一で決まるわけでもありません。for文を「入力を出力へ変換している」と読んでも構いませんし、見通しがよくなる場面もあります。先に投げる問いを変えてみると、ほぐれることがある。それくらいに思っています。
「プログラミングを学ぶ」を考え直す
私はいま、研修に関わる仕事をしています。そこで気になっているのが、学習の順番の話です。
初学者は、たいてい構文から学びます。変数、if文、for文、関数、class。そのあとmapやfilterが出てきます。カリキュラムとしては自然です。ただ、この順番には隠れた前提があると思っています。「構文を学べば、いずれ読めるようになる」という前提です。
私はこの前提を疑っています。「mapの使い方を知っている」ことと、「値の変換としてコードを読める」ことは、別の能力です。 私自身がまさにそうでした。mapの引数も戻り値も説明できるのに、mapで書かれたコードは読みにくかった。構文の理解が、読み方の理解へ自動で変換されるわけではない。両者のあいだには、意識的に踏まないと渡れない段差があります。
だとすると、カリキュラムに足りないのは構文の説明ではなく、その段差を渡る練習なのかもしれません。「このコードは、どの問いで読むと楽になるか」を、構文と同じくらい意図的に教える余地があるはずです。
プログラミングを学ぶとは、構文を増やすことだけではない。コードに対して立てられる問いのレパートリーを増やすことなのではないか。
さきほど並べた程度の問いを場面で選べることも、コードを読む力の一部だと思います。逆に言えば、構文をすべて知っていても、この選び方を知らないだけで「読めない」状態に留まる人がいる、ということでもあります。私はそのことに、自分がハマるまで気づいていませんでした。
近い領域の研究はあります。Elliot SolowayとKate Ehrlichは1984年の研究5で、熟練したプログラマが「プログラミング・プラン」と呼ばれる型を頭の中に持っていることを示しました。読み手が持っている型が理解を助ける、という点では関心が重なります。ただしこれは「パラダイムごとに問いを切り替えると読みやすくなる」ことを証明するものではありません。
もっと単純に、慣れの問題という説明もありえます。関数型のコードを1万行読めば、問いなど意識しなくても読めるようになるかもしれない。それはそのとおりだと思います。ただ、慣れを待つのと、問いを言葉にして渡すのとでは、そこに至るまでの時間が違う気がしています。言葉にできるものを、慣れだけに委ねる必要はない。 それが、この記事で言いたかったことです。
AIに書いてもらったコードで、同じことが起きた
生成AIにコードを書いてもらう機会が増えました。そこで困ったのが、自分なら書かない書き方が返ってくることです。最初の例で言うなら、for文で書くつもりだった集計が、filterとreduceで返ってくる。動くし、短い。なのに読むのに時間がかかる。
冒頭のコードと、構図は同じです。やっていることは分かる。書き方が自分の読み方と噛み合っていないだけです。
AIが、自分がスッと読めないコード(filterやreduce)を出してきたとき、私は最初こう思いました。「プロンプトで『for文を使って書いて』と指示すればいいだけじゃん」と。
実際、AIは賢いので指示通りに命令型で書き直してくれます。それで仕事は進みます。ただし、これでは「自分の理解できる枠(パラダイム)」の中に、わざわざAIを押し込めているだけではないのでしょうか。
これはfilterやmapがfor...ofより優れている、という話ではありません。どちらもJavaScriptの標準的な書き方です。filterやmapは元の配列を書き換えずに新しい配列を返すので読みやすい場面がありますが、コールバックの中や要素そのものまで不変になるわけではありません。走査の回数で言えばfor...ofのほうが少なくて済みます。
引っかかったのは、そこではありません。私が「読みにくいから」という理由だけで書き直させていたことのほうです。設計上の判断ではなく、自分の読み方の都合で選んでいた。
Floydも、他人のコードや自分とは違う慣習に触れることで新しいパラダイムを得る場面を書いています。生成AIで変わったのは、接触そのものよりもその頻度ではないでしょうか。自分で本や言語を選ぶより前に、違う書き方が日々のレビュー対象として混ざってくる。選んでいないパラダイムのほうから、何度も降ってくる。 レパートリーが足りないと、それを弾いてしまいます。
もちろん、AIが出してきたコードをそのまま受け取ればいいわけでもありません。型とテストが通るかは当然として、知らないライブラリを勝手に足していないか、その依存のライセンスは通るか、入力の扱いが雑になっていないか。確かめることはむしろ増えています。
変えたいのは、その手前です。「読みにくい」で弾いてしまう前に、読み方のモードを切り替えてみる。書く作業を任せる場面が増えるほど、それが要るようになるのかなと思いました。
おわりに
最初の話に戻ります。
私は、関数型プログラミングのコードを読むのが苦手です。この記事を書いても、そこは変わりませんでした。変換が何段も重なったコードや、型の定義だけで処理が表現されている箇所を見ると、いまでも目が滑ります。
変わったのは、詰まったときの一手です。前は「知らない書き方があるはずだ」と思って調べに行きました。いまは先に、自分がそのコードを命令型の読み方で追っていないかを疑います。それで解決しないことも多いのですが、少なくとも調べる先は変わりました。
コードが読めないとき、私たちはたいてい「知らない構文があるのだろう」と考えます。もちろん、それが原因のこともあります。
でも、ときにはもう1つ問いかけてみてもよいのかもしれません。
「私はいま、このコードにどんな問いを投げかけながら読んでいるのだろう?」
- 1.Edsger W. Dijkstra, "Go To Statement Considered Harmful", Communications of the ACM, Vol. 11, No. 3, 1968, pp. 147-148. doi:10.1145/362929.362947 / 本人による草稿 EWD215 は テキサス大学オースティン校のアーカイブで読めます。 ↩
- 2.E. F. Codd, "A Relational Model of Data for Large Shared Data Banks", Communications of the ACM, Vol. 13, No. 6, 1970, pp. 377-387. doi:10.1145/362384.362685 ↩
- 3.Robert W. Floyd, "The Paradigms of Programming", 1978年チューリング賞講演。Communications of the ACM, Vol. 22, No. 8, 1979, pp. 455-460. doi:10.1145/359138.359140 ↩
- 4.Peyman M. Kiasari, "Are Programming Paradigms Paradigms? A Critical Examination of Floyd's Appropriation of Kuhn's Philosophy", 2025. arXiv:2505.01901 ↩
- 5.Elliot Soloway, Kate Ehrlich, "Empirical Studies of Programming Knowledge", IEEE Transactions on Software Engineering, Vol. SE-10, No. 5, 1984, pp. 595-609. doi:10.1109/TSE.1984.5010283 ↩