- 山田勇一
- 約 8,500 文字
目次
はじめに
前回の「セキュリティ要求は、待ってくれない」では、セキュリティをサービスレベル設計の観点から捉え直し、事業者がどこまで投資し、どういう状況になったらサービスを止めるのかを決めることの大切さを書きました。
この秋も、国内では不正アクセスによる情報漏えいの報道が相次ぎました。また、広く使われている開発言語の重大な脆弱性が公表される前後に、多くの事業者が被害を防ぐため予防的にサービスを止める動きも見られました。
では、システムを設計し、作り、維持する側の私たちエンジニアやアーキテクトは、何を考え、どこに手を打つべきなのでしょうか。相次ぐ報道に危機感を覚えたこともあり、実務の目線からセキュリティの全体像を何回かに分けて整理します。
全体としては、次のような順番で辿っていく予定です。
- 第1回: セキュリティの考え方と、共通の前提(今回)
- 第2回: 利用者のリテラシーと、事業者のガバナンス
- 第3回以降: クライアント、サーバー、基盤・ネットワーク、SaaS、IDaaS、生成AI、運用・監視などの観点から複数回に分けてまとめる予定です
何度も書きましたが私はセキュリティの専門家ではなく、業務システムの構想や設計に関わっている技術者です。この連載も、私自身が学び直しながら頭の中を整理するために書いています。記事の作成には生成AIの力も借りています。誤りや、実務で外せない観点があれば、ぜひ教えてください。
業務は作るがプロトコルを作ることは稀
一部の専門領域を除けば、アプリケーションエンジニアが暗号方式や認証プロトコルそのものを作ることはありません。素人が独自の暗号や認証プロトコルを発明することは、セキュリティの世界で「やってはいけないこと」の筆頭に挙げられます。
では、SIerやサービスベンダーに所属するエンジニアやアーキテクトは何をしているのかといえば、すでに世の中で確立され、検証されてきた「プロトコル」と、それを実装した「プロダクト」の最適な組み合わせを考える仕事をしています。
通信を守るならTLSを使い、認可を委譲するならOAuth 2.0を、認証を連携するならOpenID Connectを使う。手段としてのプロトコルは公開されており誰でも閲覧できるものです。私たちが頭を悩ませるのは、「それをどのプロダクトで実現し、自分たちのシステムにどう組み込むか」という一点です。
自由なOSSと手軽なマネージド
プロダクトの組み合わせを考え始めると、多くの場合、2つの選択肢の対立構造に行き着きます。
片方には、IaaSやオンプレミスの上にOSSを自前で構築・運用する形があります。初期構築や維持・保守の手間と人的コストはかかるものの、自分たちの都合に合わせて自由に組めます。もう片方には、PaaS(マネージドサービス)やSaaSに任せる形があります。初期投資が安くすぐに立ち上げられるものの、利用規模が大きくなると割高になることもあり、機能や運用の面でもサービス側の制約を受けます。
セキュリティの観点で見ると、この対立はそのまま「責任共有モデルの境界線をどこに引くか」という問いになります。
OSやミドルウェアのパッチ適用から自分たちで面倒を見るのか、ランタイムやDBの保守までクラウド事業者に任せるのか、認証基盤や業務機能を丸ごと借りるのか。自由度を取るほど「自分たちで守り続ける範囲」が広がり、手軽さを取るほど「ベンダーの仕様と価格体系に委ねる範囲」が広がります。どちらが優れているという話ではなく、どこにコストと責任を置くかの選択です。なお、どれを選んでも、預けるデータそのものや、アカウント・権限の設定は利用者側の責任として残ります。
AIを使ってもこの構造は変わらない
最近は生成AIの進化が目覚ましく、コードを書いたり設定ファイルを生成したりする手間は劇的に下がりました。ただ、ことセキュリティ要素が絡む領域においては、AIを使ったとしても先ほどの構造はまったく変わらないと考えています。
理由は単純で、「作るコスト」は下がっても、「守り続けるコスト」は消えないからです。
前回の記事でも触れましたが、セキュリティの要求水準は、自分たちの事業が何も変わっていなくても、外部の攻撃者の都合で勝手に上がります。しかも今は、攻撃する側もAIを使って幅広いサイトの穴を高速に探し回っていると言われています。作った時点では安全だったものが、半年後には危険な状態になることが普通に起きます。
ちなみに、非エンジニアがAIで業務システムを自作する動きに、私はセキュリティの観点から否定的です。AIが出したコードが安全かどうかを作った本人が判断できず、脆弱性情報やライブラリの更新を一人で追い続けることになるからです。そこまで面倒を見れば本業が疎かになり、本末転倒だと思うのです。
エンジニアにできることは「見極め」しかない
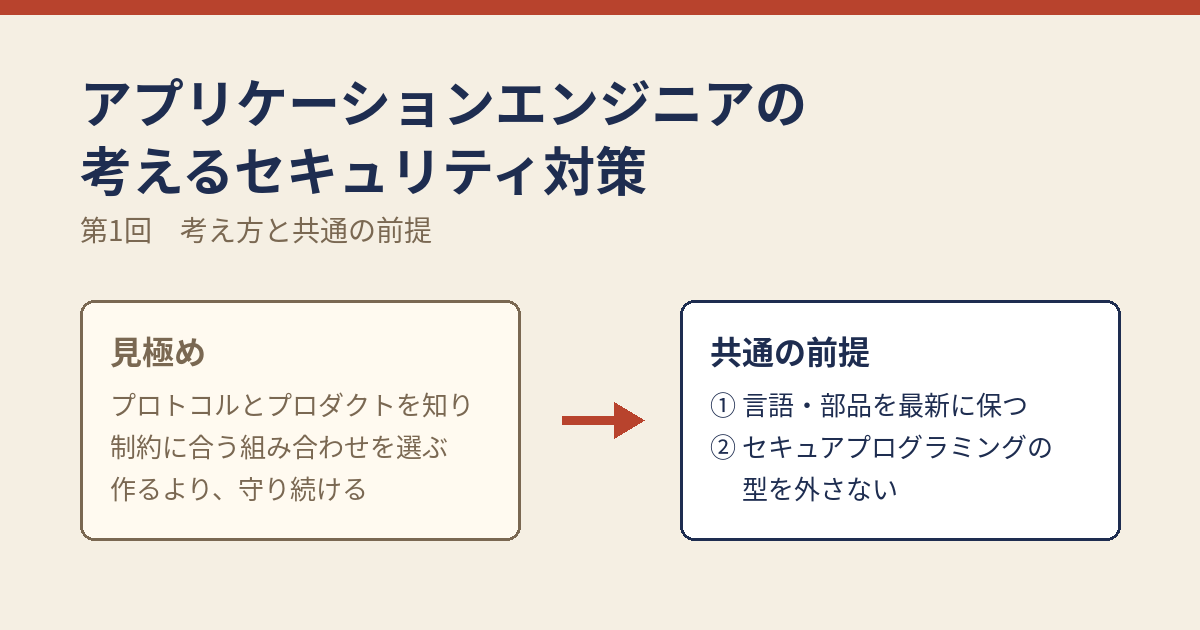
セキュリティにおいてアプリケーションエンジニアにできることは多くなく、知ることが2つと、見極めることが1つです。
1つ目は、手段(プロトコル)を知ることです。何のための仕組みで、どんなメリットとデメリットがあるのかを理解します。
2つ目は、プロトコルを実装するプロダクトを知ることです。自前で運用するOSS、マネージドサービス、SaaSといった選択肢それぞれの特徴と、「そのプロダクトをどこまで信頼できるか」「どこまで責任を持ってくれるか」を把握します。
3つ目は、自分が作るシステムにどれが適合するかを見極め、組み合わせ方を決めることです。この見極めには、技術以外の条件もたくさん絡みます。
- 機能要件と非機能要件(どこまでのセキュリティ水準を約束するか)
- 費用や期間といった制約
- システムを構築する開発言語やフレームワークとの親和性
- 組織やシステム全体での技術の統一感
- 維持・保守を担う要員の確保
また、侵入をゼロにはできない前提に立ち、権限を必要最小限に絞ったり、守りを何層かに分けたりしておく視点も欠かせません。
特別な防御技術を発明するのではなく、与えられた制約の中で無理なく維持し続けられる組み合わせを組んでおく。それが、設計する立場としての私たちの仕事のほぼすべてなのだと思います。
どの層にも共通する2つの前提
ただし、どれだけ良い組み合わせを選んでも、選んだ部品を古いまま放置したり、誤った使い方をしたりすれば守りは崩れます。どの層にも共通する技術面の前提を2つ整理しておきます。
共通の前提①: 言語・フレームワーク・部品を最新の状態に保つ
最新の状態に保つことは基本でありながら、現場で崩れやすいところです。
サポート期限とパッチ適用の現実
まず確認すべきなのは、利用している言語ランタイムやフレームワークがサポート期限(EOL)を迎えていないバージョンか、そしてセキュリティパッチが提供されたときにすぐ適用できる状態にあるか、という点です。
「安定して動いているから触らないでおこう」という判断で何世代もバージョンを放置すると、いざ深刻な脆弱性が見つかったときに、自分たちが使っている古いバージョンには修正パッチすら提供されない、という事態に陥ります。そうなると、WAFなどで一時的にしのぎながら何世代分もの改修を急ぐか、改修が終わるまでサービスを長期停止するか、最悪の場合はそのままサービスを終了するか、という厳しい選択を迫られます。この秋の重大な脆弱性をめぐる騒動でも、実際にそうした対応に追い込まれたサービスが見られました。
言語やフレームワークのバージョンアップは、「余裕があるときにやる改善」ではなく、最初から保守計画と予算に組み込んでおかなければならない維持コストそのものです。
取り込んだ部品のサプライチェーン管理
もう1つ忘れてはいけないのが、自分たちで書いたコードよりも、パッケージマネージャー(npm、PyPI、Mavenなど)経由で取り込んだOSSライブラリや外部SDKのほうが、コード量としては圧倒的に多いという現実です。
どれか1つの部品に脆弱性が見つかれば、システム全体を危険にさらすことがあります。実務では次の仕組みを整えておく必要があります。
- ロックファイルを使って依存パッケージのバージョンを固定し、意図しない更新を防ぐ。そのうえで、DependabotやRenovateなどを使って計画的に更新する
- 新しいライブラリを取り込む際、保守が継続しているかを確認する(何年も更新が止まっている部品や、有名なパッケージに名前を似せた偽物や、AIが誤って提示した実在しないパッケージ名を攻撃者が先回りして公開したものに注意する)
- 正規のパッケージでも、乗っ取られて悪意あるバージョンが公開される事例が起きているため、緊急のセキュリティ修正を除き、通常の更新では公開直後のバージョンをすぐに取り込まず、数日ほど期間を置いてから採用する
- 自分たちのシステムがどの部品のどのバージョンを使っているか、間接的に依存している部品も含めてソフトウェア部品表(SBOM)として把握しておく
- 依存ライブラリの脆弱性検査を自動化し、公的機関やベンダーが出す脆弱性情報(JPCERT/CC、IPA、JVN、米CISAの悪用確認済みカタログであるKEVなど)と日常的に照合できる状態を作る
開発言語・エコシステムごとの勘所
最新状態の管理とあわせて、採用する言語やエコシステムごとに「歴史的に事故が起きやすいポイント」も知っておく必要があります。
- Java: サポートが終了した古いフレームワーク(Struts 1など)やAPサーバーの放置が命取りになります。信頼できないデータのデシリアライズや、かつてのLog4Shell(Log4j 2の脆弱性)のように「直接意識していなかった、間接的に取り込まれたログライブラリ」に重大な脆弱性が潜むケースへの備えが欠かせません
- JavaScript / TypeScript(Node.js・フロントエンド): npmエコシステムは依存の階層が非常に深く、悪意あるコードが紛れ込むサプライチェーン攻撃の標的になりやすいという特徴があります。プロトタイプベースという言語の特性に起因するプロトタイプ汚染のほか、近年はサーバーサイドレンダリングやサーバーコンポーネント境界のように、フレームワーク側が担う通信・描画機構の脆弱性にも素早い追従が求められます
- Python:
pickleや安全でないYAML読み込み(yaml.safe_load等を使わない読み込み)に外部データを渡すと任意のコードを実行される危険があります。外部から入手した機械学習モデルのファイル(pickle形式のもの)を読み込む場合も同様です - モバイル(Swift / Kotlin / Flutter / React Native): iOSやAndroidのOSアップデートやストアの審査要件に追従し続ける必要があります。アプリ本体のコードだけでなく、広告やアクセス解析のために組み込んだサードパーティSDKや、ネイティブコードとの橋渡し部分を放置すると穴になりやすい領域です
共通の前提②: セキュアプログラミングの「型」を外さない
セキュアプログラミングとは「職人のように巧妙なエスケープ処理や暗号処理を書くこと」ではありません。フレームワークやOSが標準で備えている防御機能を正しく使い、開発の都合で勝手に無効化しないことが基本です。そのうえで、認可のようにフレームワークが肩代わりしてくれない部分を、決まった型どおりに漏れなく書くことが求められます。
共通の「型」として押さえておくべき項目を、6つに整理します。
1. 外部からの入力を一切信用しない
画面フォームに入力された文字列だけでなく、URLのパラメーター、HTTPヘッダー、Cookie、外部連携APIから返ってきたレスポンス、さらにはシステムに組み込んだ生成AIの出力に至るまで、自分の処理の外側から入ってくるデータはすべて「細工されているかもしれないもの」として扱います。処理の入り口で、型・形式・長さ・許容される値の範囲を必ず検証します。検証は画面側の入力チェックだけで済ませず、サーバー側で必ず行います。URLパラメーターやディープリンクを直接扱うクライアント処理でも同じです。「危険な値を弾く」のではなく「許可する値だけを通す」考え方を基本にします。
2. 「命令」と「データ」を混ぜない・出力先に応じて無害化する
インジェクション系の脆弱性は、外から入ってきた「データ」を、システムへの「命令」として解釈させてしまうことで起きます。また、外部入力によって処理の宛先やファイルのパスを操られる脆弱性も、同じく「データを信用しすぎた」ことが原因です。
- SQL / NoSQLインジェクション: データベースへの問い合わせは、必ずパラメーター化されたクエリ(プレースホルダー)を使います。ORMを使っていても、複雑な検索条件などで生のSQL文字列を結合している箇所は穴になります。並び替えの列名のようにプレースホルダーを使えない部分は、許可する値の一覧と照合します。NoSQLでも、リクエストのJSONオブジェクトをそのまま検索条件に渡すと演算子を注入されることがあるため、型の検証が欠かせません
- クロスサイトスクリプティング(XSS): 画面への出力はフレームワークの自動エスケープ機能に任せ、
innerHTMLやdangerouslySetInnerHTMLのように生のHTMLを直接流し込む機能を安易に使わないようにします。どうしてもHTMLを表示する必要がある場合は、実績のあるサニタイズ用ライブラリを通します - OSコマンドインジェクション: 外部からの入力はシェルコマンドに渡さないようにします。外部コマンドを呼ぶ必要がある場合も、シェルを経由せず、引数を分けて渡す方法を使います
- サーバーサイドリクエストフォージェリ(SSRF): 外部から指定されたURLへサーバー自身が通信しにいく処理では、社内ネットワークやクラウドのメタデータ領域(認証情報が取れる特殊な宛先)へアクセスさせられる攻撃を防ぐため、接続先を許可した宛先だけに厳しく制限します
- パストラバーサル: ファイル名や保存先のパスに外部入力を使う場合、
../などの文字列によって本来アクセスさせてはいけないファイルを読み書きされないよう、パスを固定・検証します
3. 認証・認可・状態管理を「画面任せ」「自前実装」にしない
画面側でボタンを非表示にしたり入力欄をグレーアウトしたりするのは使いやすさのための配慮で、セキュリティではありません。攻撃者は画面を飛ばして裏側の処理を直接呼び出します。
したがって、処理の入り口ごとに毎回「この利用者が、この対象データに対して、この操作をしてよいか」を判定する必要があります。また、受け取ったJSONなどのデータをそのままデータベースのモデルに一括で流し込み、本来は利用者が書き換えられないはずの「管理者フラグ」や「ロール」まで書き換えられてしまう不備も、よくある落とし穴です。
ログイン状態を保持するセッションの管理も、自前で作らずフレームワーク標準の仕組みを使います。初期設定で無効なフレームワークもあるため、ログイン時のセッションID再発行やCookieの属性(HttpOnly、Secure、SameSite)が有効になっているかは必ず設定で確認します。
パスワードの保存と、トークン等に使う乱数の生成も、自前のロジックで代用しません。パスワードは、Argon2idやbcryptのようなパスワード保存専用のハッシュ関数で保存します。SHA-256のような汎用のハッシュ関数では不十分です。乱数は、Math.random() のような通常の乱数ではなく、暗号用途に安全な乱数生成器(crypto.getRandomValues()、Javaの SecureRandom、Pythonの secrets など)を使います。
4. 余計なデータを返さない・ログに出さない
処理の結果を返すときは、画面の表示に本当に必要な項目だけに絞ります。データベースから取得したレコードを丸ごと返してしまうと、画面には表示していなくても、通信の中を見れば他の利用者の情報や内部の管理項目が丸見えになります。
エラーが起きたときも同じです。スタックトレースやSQL文、ミドルウェアのバージョンといった内部情報をそのまま利用者側に返すと、攻撃者にシステムの構造を教えることになります。利用者には統一された汎用的なメッセージを返し、詳細はサーバー側のログにだけ記録します。ただし、そのログの中にもパスワードやトークン、APIキー、生の個人情報をそのまま出力しないよう注意が必要です(本番環境でデバッグログやフレームワークのデバッグモードを切り忘れないことも含みます)。
5. 秘密情報をコードから分離する
外部サービスのAPIキー、データベースの接続パスワード、暗号鍵といった秘密情報を、ソースコードやリポジトリで管理する設定ファイルに直書きしてはいけません。Gitリポジトリに一度でもコミットしてしまえば、あとから行を消しても履歴に残り続けます。万が一コミットしてしまった場合は、履歴を消すことより先に、その鍵を無効化して再発行する必要があります。サーバー側の秘密情報はコードとは切り離し、環境変数やクラウドのシークレット管理サービスから実行時に渡す構成を徹底します。
一方、ブラウザやスマホアプリには、そもそも秘密情報を持たせてはいけません。クライアント側から参照する値は、ビルド時に環境変数として渡していても配信物の中にそのまま埋め込まれ、誰でも取り出せるからです。秘密情報が必要な処理は、サーバー側に置きます。
6. 標準の防御機能を無効化せず検査を仕組みにする
開発中に「エラーが出て疎通確認しづらいから」という理由で、CSRF対策やTLS証明書の検証、CSPなどを一時的に無効にしたり、CORSの許可設定をすべてのオリジンに開放したりして、そのまま本番に出してしまう事故は後を絶ちません。標準の防御機能は「外さない」が原則です。
そして、これらを人間の注意力だけで守り切るのは無理があります。ソースコードの静的解析、依存パッケージの脆弱性検査、秘密情報の混入検査をCIパイプラインに組み込み、機械的に弾く仕組みを作ります。秘密情報は、コミット前のチェックやリポジトリ側のプッシュ保護機能もあわせて使います。
開発に生成AIを使う場合も同じです。AIは認可チェックが抜けたコードや一昔前の非推奨な書き方を平然と出してくるので、人間が書いたコードと同じ基準でレビューし、機械的な検査を通します。
おわりに
今回は、プロトコルとプロダクトを知って組み合わせを見極めることと、技術を最新状態に保ちセキュアプログラミングの型を外さないことを整理しました。複雑な話は何ひとつありません。
皆さんが当たり前のように気にされている内容ばかりだと思います。ただ、私自身、ここに挙げたすべてを毎回確実にチェックできていたかと振り返ると、自信がありません。
世の中で起きているセキュリティ事故の多くは、誰も見たことがない高度な攻撃ではなく、こうした地味な対応のどこかが抜けていたところから起きています。結局のところ、当たり前のことを当たり前に維持し続けられる設計にできるかどうかが、いちばんの分かれ目なのだと思います。
次回は、クライアントやサーバーといった個別の技術要素に入る前に、もうひとつの前提となる「利用者のリテラシーと、事業者のガバナンス」について整理してみます。どれだけシステム側を固めても、使う人と提供する組織の判断が抜けていれば守りは成立しないからです。
理解の浅い部分もあります。「ここは認識が違う」「この視点も入れておいたほうがいい」といったご意見があれば、ぜひ教えてください。
関連記事
このブログで、今回の各節と関わりのある記事です。
- サービスレベル設計として捉える非機能の考え方
- セキュリティ要求は、待ってくれない
- 脆弱性対応と、本能のバグ
- クラウド入門 - 知っておくと良い心構え - Part1(責任共有モデル)
- 認証認可連載2022(OAuth 2.0・OpenID Connect)
- 【理論編】HTTPS通信の中身を見て、どのようにしてセキュアな通信が確立されるかを理解する(TLS)
- package.json dependencies メンテの仕方 最短ルート(依存パッケージの更新)
- 初めてのセキュリティ情報収集(mjckeck4)(脆弱性情報の収集)
- 【もう鍵なくさない】GCPのSecret ManagerとBerglasで幸せになる(シークレット管理)
- いっそ閉鎖しようか…と悩んだ研究データベースを、Claude Opus と数時間で作り直した話(生成AIと脆弱性)