- 武田大輝
- 約 8,300 文字
目次
はじめに
AWS Well-Architected Framework は、AWS 上のシステムを設計・運用するときの考え方とベストプラクティスを、AWS が体系的にまとめたものです。運用上の優秀性、セキュリティ、信頼性、パフォーマンス効率、コスト最適化、サステナビリティの 6 本の柱に 57 の質問があり、質問ごとに数件ずつ、合わせて約 300 件のベストプラクティスがあります。
このフレームワークに照らしてワークロードを評価するのが、Well-Architected Framework Review(WAFR)です。質問に 1 問ずつ答えながら、どのベストプラクティスを実装していて、どれが足りないかを確かめ、リスクの高い項目を洗い出して改善計画を立てます。従来は、担当者が設計書や構成を確認しながら、AWS Well-Architected Tool のコンソールで質問に 1 問ずつ回答し、レビューを記録する進め方が一般的でした。
Agent Toolkit for AWS には、このレビューをコーディングエージェントにやらせる aws-well-architected-review というスキルがあります。従来のやり方では時間がかかりすぎて、レビューをなかなか実施できないという方も多かったと思いますが、このスキルを使えば、ドキュメントや IaC をベースにした確認をエージェントに任せて、手軽にレビューを実施できます。
この記事では、スキルの仕様を整理したうえで、公開されているサンプルアプリケーションに対していくつかのモードでレビューを実施し、その出力を確認します。合わせて、2026 年 10 月にパブリックプレビューとして発表された AWS Well-Architected Agent との違いにも触れます。
Agent Toolkit for AWS とは
Well-Architected Framework Review を実施するスキルaws-well-architected-reviewは単独で配布されているスキルではなく、Agent Toolkit for AWS の一部です。Agent Toolkit for AWS は、AWS が 2026 年 4 月に一般提供を始めた、コーディングエージェント向けのツール群です。ユーザガイド を見ると、このツールキットは 4 つのコンポーネントから構成されていることがわかります。
AWS MCP サーバ
エージェントが AWS にアクセスするための MCP サーバです。AWS ドキュメントの検索(認証不要)や AWS API 呼び出し(要 IAM 認証)などの機能を提供します。エージェントスキル
エージェントが特定の AWS タスクを実行するためのスキルセットです。最適なサービスを選定するスキルから CDK でインフラを構築してデプロイするスキルまでさまざまなスキルが含まれます。プラグイン
Claude Code や Codex などのコーディングエージェント用のインストールパッケージで、AWS MCP サーバの設定とスキルをまとめたものです。ルールファイル
MCP サーバの使用やスキルの検出などをエージェントに指示するためのルールです。プロジェクトレベルのルールファイル(例.CLAUDE.md、AGENTS.md)に追加し、プロジェクトに合わせてカスタマイズすることが推奨されています。
2026 年 10 月時点で、AWS が GitHub のリポジトリ で公開しているプラグインは次の 5 つです。
| プラグイン | 含まれるスキル |
|---|---|
| aws-core | AWS 全般(サービスの選定、IaC、サーバレス、コンテナ、データベース、可観測性、コスト管理など)を扱うスキル |
| aws-agents | Amazon Bedrock と AgentCore による AI エージェントの構築を扱うスキル |
| aws-data-analytics | S3 Tables、AWS Glue、Athena によるデータレイク、分析、ETL を扱うスキル |
| aws-agents-for-devsecops | AWS DevOps Agent と AWS Security Agent によるインシデント調査、コードレビュー、脆弱性診断を扱うスキル |
| aws-startup-advisor | スタートアップ向けの構成、コスト、セキュリティの助言と、他クラウドからの移行を扱うスキル |
aws-well-architected-review は aws-core に入っている 25 本のスキルのうちの 1 つです。
sample-well-architected-skills-and-steering にも Well-Architected レビューのスキル(wa-review など)がありますが、現在は非推奨です。後継が aws-core の aws-well-architected-review であることは、このリポジトリの README にも書かれています。
スキルの仕様
モード
モードは 4 つで、どれを使うかはスキルが依頼の文脈から判断します。判断できないときは、4 つの選択肢を示してユーザに指示を仰ぎます。
| モード | 対象の柱 | 評価の単位 | 出力 |
|---|---|---|---|
| full | 6 本すべて | ベストプラクティス(307 件) | カバレッジ監査、構成図、柱ごとのスコア、57 問の評価表、全ベストプラクティスの判定一覧、リスクレベル別の指摘、改善計画 |
| pillar-scoped | 指定した柱だけ | ベストプラクティス(指定した柱に属するもの) | 指定した柱の質問ごとのスコア、ベストプラクティスの判定一覧、指摘 |
| quick | 6 本すべて | 質問(57 問) | 柱ごとのスコアと所見、57 問の評価表、指摘 |
| score | 6 本すべて | 質問(57 問) | 柱ごとのスコアと指摘一覧だけ |
モードとは別に Well-Architected Lens も使えます。レンズは Serverless Lens や SaaS Lens のように特定の領域に向けて AWS が公開している追加の質問で、指定すると通常の 57 問に加えてレンズの質問も評価します(指定しなければ通常の 57 問だけになります)。
ワークロードの重要度
ワークロードの重要度は、そのシステムの停止が事業へ与える影響の大きさを表す値で、critical、high、standard、low の 4 段階があります。スキルはレビューを始める前に、ワークロードの名前や対象のディレクトリと一緒に重要度をユーザに尋ねます。コードからは推測できない値のため、非対話モードで起動する場合はプロンプトで指定しておくとよいでしょう。
重要度は判定の厳しさを変えます。たとえば critical ならマルチリージョンの DR やカオステストを期待して評価する一方で、low や standard ならよりシンプルな構成を許容すると定めています。
レビューの対象
レビューの対象となるものは、スキルのリファレンスファイルである references/discovery-procedure.md に列挙されています。IaC(CDK、CloudFormation、Terraform、SAM など)と CI/CD のパイプライン定義(GitHub Actions、CodePipeline など)は読む決まりで、その中でも監視(CloudWatch のアラームやダッシュボード)とデプロイ方式(CodeDeploy や ECS のデプロイ設定)は明示的に確認対象に挙がっています。アプリケーションコードについては、エントリポイント、サービス間通信のパターン(同期・非同期、リトライ、タイムアウト、サーキットブレーカー)、データアクセス、エラー処理、認証認可、オブザーバビリティの計装を見ます。設計書は必須の対象には入っていませんが、判定の根拠として使用してよいことになっています。
実際のクラウド環境の状態は見ません。AWS の API を呼ぶような手順はなく、レビューで使ってよい権限も wellarchitected:Get* と wellarchitected:List* までと書かれています。コードからは分からないことは「Cannot Determine」として、何を確認すれば判定できるかを添える決まりになっています。
レポートの構成
レポートの構成はモードによって変わります。full モードはテンプレートでセクションの順序が固定されていて、カバレッジ監査、エグゼクティブサマリ、構成図(PlantUML)、柱ごとのスコア表、57 問の評価表、全ベストプラクティスの判定一覧、リスクレベル別の指摘、柱をまたぐトレードオフ、改善計画(アイゼンハワーマトリックスによる分類と、それを期間別の作業に展開した計画)、次のアクションの順に並びます。quick モードと pillar-scoped モードはこのテンプレートをモードに合わせて調整し、score モードはテンプレートを使わず、スコア表と指摘一覧だけの形式で出力します。
判定とリスクレベル
ベストプラクティスごとの判定は 5 値(Implemented、Partially Implemented、Not Implemented、Not Applicable、Cannot Determine)のいずれかで表現されます。
リスクレベルは、影響(Minor/Moderate/Severe)と発生可能性(Low/Medium/High)の組み合わせで決めます。リファレンスファイル references/risk-assessment.md の対応表を、行を影響、列を発生可能性にして並べると次のようになります。
| 影響\発生可能性 | Low | Medium | High |
|---|---|---|---|
| Severe | High | High | Critical |
| Moderate | Medium | Medium | High |
| Minor | Low | Low | Medium |
改善計画
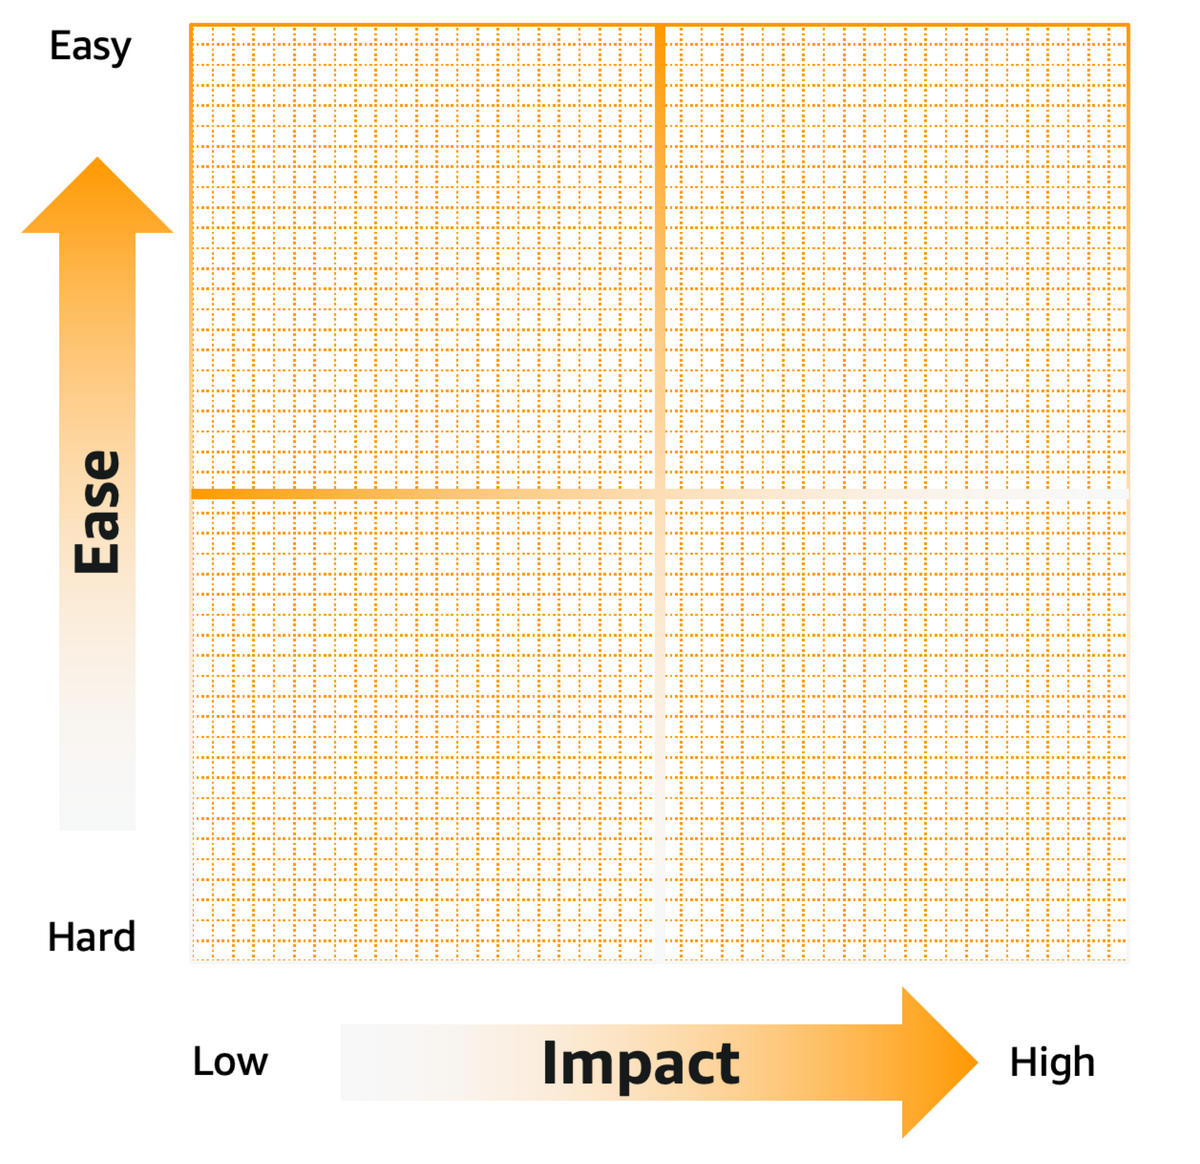
改善計画はアイゼンハワーマトリックス(図は AWS Well-Architected Tool ユーザーガイド から引用。CC BY-SA 4.0)で整理します。重要性と工数の 2 軸で、Do First(重要で工数が小さい)、Plan(重要で工数が大きい)、Delegate(重要でなく工数が小さい)、Defer(重要でなく工数が大きい)の 4 象限に指摘を振り分けます。Do First と Plan に入った指摘には、期限と完了の判定条件をはっきりさせた目標と、誰が担当するかの候補が付きます。
公開サンプルで動かす
試しに、公開されているサンプルアプリケーション(aws-containers/retail-store-sample-app)を使って 3 つのモードでレビューを実施してみます。AWS のコンテナチームが、コンテナ基盤のデモ用に整備している小売サイトのアプリケーションで、構成図(同リポジトリから引用。MIT-0)は次のとおりです。
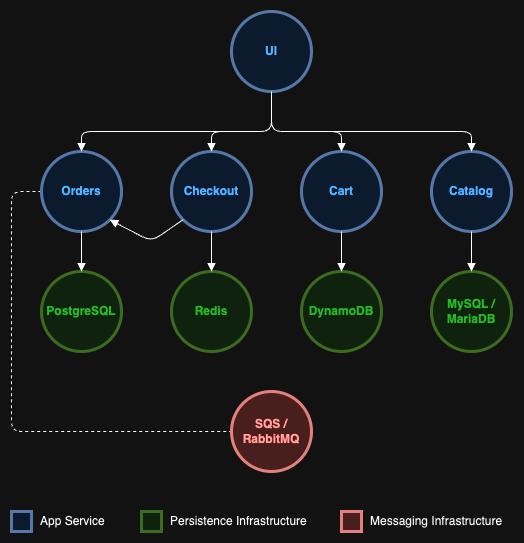
UI と 4 つのバックエンドサービス(Orders、Checkout、Cart、Catalog)に分かれていて、それぞれが用途に合ったデータストアを持ちます。リポジトリには ECS、EKS、App Runner の 3 通りの Terraform があり、今回はこのうち ECS 構成(terraform/ecs/default)を対象にしました。ECS 構成では、各サービスが Fargate のタスクとして動き、UI だけがパブリックサブネットの ALB の後ろに置かれます。データストアは、Orders が Aurora PostgreSQL、Catalog が Aurora MySQL と OpenSearch、Cart が DynamoDB、Checkout が ElastiCache(Redis)で、Orders と Checkout の間のメッセージングには Amazon MQ(RabbitMQ)を使います。
プロンプトは 3 つとも同じ形で、モード名だけ変えています。ワークロードの重要度は standard を指定しました。
/aws-core:aws-well-architected-review score モードでレビューしてください。 |
3 つのモードは、それぞれ Claude Code の非対話モードで別々に起動し、コンテキストを共有しないようにしています。それぞれの実行にかかった時間と費用、レポートの総合スコアと指摘の件数は次のとおりです。
| モード | 所要時間 | コスト | スコア | 指摘 | レポート |
|---|---|---|---|---|---|
| score | 5 分 33 秒 | 約 2.0 ドル | 2.7/5 | 26 件 (High 6、Medium 11、Low 9) |
score.md |
| quick | 5 分 38 秒 | 約 3.4 ドル | 2.0/5 | 24 件 (High 5、Medium 11、Low 8) |
quick.md |
| full | 18 分 19 秒 | 約 7.8 ドル | 2.5/5 | 32 件 (Critical 1、High 4、Medium 15、Low 12) |
full.md |
score モード
レポートの抜粋(全文は こちら から)
## WA Score: retail-store-ecs |
スコア表と、1 件 1 行の指摘一覧だけのレポートです。指摘の根拠には、ファイルパスと行番号が並びます。たとえば High の 1 件は、Java のコントローラにある /utility/panic(GET 1 回でプロセスを終了させるエンドポイント)と、Terraform で UI が公開 ALB の後ろに 1 タスクだけ置かれていることを突き合わせ、「外部の誰でも 1 リクエストでサイト全体を停止できる」と指摘しています。レポートでは次のような 1 行です(長いので一部を略しています)。
| # | Pillar | Risk Level | Finding | Evidence | |
/utility/panic は、このサンプルがコンテナ基盤の障害対応をデモするために意図して入れている機能です。スキルにはその意図を判断する材料がないので、公開経路にある危険なエンドポイントとして判定しています。本番を想定したレビューとしては妥当な判定です。
quick モード
レポートの抜粋(全文は こちら から)
## Pillar Scorecard |
57 問の評価表と、柱ごとのスコア、強み、ギャップが付くレポートです。57 問のうち 14 問は Cannot Determine で、組織構造や組織文化、インシデント対応のように、コードを読んでも分からない質問がそのまま「分からない」として残っています。
score モードと同じく、/utility/panic を High の筆頭に挙げています。
### H-1 認証のない管理・カオス用エンドポイントが公開経路から到達できる(Security) |
一方で、同じレポートの信頼性の柱では、これらのエンドポイントを「カオス用フック」として強みにも数えています。障害を注入して回復性を試すしくみそのものは、Well-Architected でも推奨されているものです。問題は、そのしくみが公開経路から認証なしで呼べることのほうで、quick はその両面を書き分けています。
full モード
レポートの抜粋(全文は こちら から)
## Full BP Ledger (MANDATORY) |
307 件すべてのベストプラクティスの判定一覧を含むレポートです。Cannot Determine は 62 件で、quick モードの 14 問から増えました。質問単位では 1 問だったものが、ベストプラクティス単位では数件に分かれるからです。
3 つのモードで Critical を出したのは full だけでした。score と quick が指摘した /utility/panic に加えて、UI の /proxy を経由すると Orders サービスの API から全注文の氏名、メールアドレス、住所が取れることまでたどっています。
### C-1. 公開経路から未認証で全注文の PII 取得とプロセス停止が可能【Critical】 |
3 つを比較して
上位の指摘は 3 つのモードでほぼ同一でした。ALB が HTTP のみで WAF がない、全サービスが 1 タスクで Auto Scaling がない、アラームと通知が 1 つもない、の 3 つは、どのモードでも High に並んでいます。公開経路の /utility/panic も 3 つのモードすべてが挙げていて、違いはリスクレベルでした。
| モード | 公開エンドポイントの判定 |
|---|---|
| score | High |
| quick | High |
| full | Critical |
full モードは /utility/* に加えて /proxy も調べ、この 2 つを合わせると、認証なしで個人情報の取得とサービスの停止の両方ができることに気付いたため、Critical と判定したのではないかと考えられます。各モード 1 回ずつの今回の実行では、ベストプラクティスを 1 件ずつ判定する full モードのほうが、質問単位の score モードや quick モードより深くコードを追っているようです。
レポートの内容は実行ごとに変わり得ます。実際に、同じ条件で quick モードを流し直すと、カオス機能を信頼性の強みに挙げながら、それが公開経路から呼べることには気付かず、/utility/panic を指摘しないことがありました。判定は LLM がコードのどこを読み、どうつなぐかに左右されるので、結果は非決定論的です。この性質を理解したうえで、複数回実行して結果を突き合わせるといった使い方が必要です。
AWS Well-Architected Agent との棲み分け
2026 年 10 月、AWS は AWS Well-Architected Agent をパブリックプレビューとして発表しました。Well-Architected Framework に照らしてワークロードをレビューする点はこのスキルと同じですが、レビュー対象が異なります。スキルが見るのはリポジトリのコードで、Agent が主に見るのは AWS 環境で稼働中のリソースです。
Agent は、利用者が用意した読み取り専用の IAM ロールで対象のアカウントを毎週スキャンし、推奨事項を自動で更新します。その際、Trusted Advisor や Compute Optimizer といった既存のサービスの検出結果も取り込み、登録した事業目標に沿って優先順位を付けます。これとは別に、IaC のプロジェクト(CDK、Terraform)を S3 に置いて、テンプレートを分析するアーキテクチャレビューを任意のタイミングで実行できます。プロファイルの作成からアーキテクチャレビューの実行までの手順は、Classmethod さんの記事「AWS Well-Architected Agent が登場したので触ってみた」にまとまっています。
対象の柱は、コスト最適化、セキュリティ、回復性、パフォーマンスの 4 つで、運用上の優秀性とサステナビリティは現在のところ含まれません。
| 観点 | aws-well-architected-review スキル | AWS Well-Architected Agent |
|---|---|---|
| 動作場所 | コーディングエージェントローカル | AWS のマネージドサービス |
| レビュー対象 | リポジトリ内の IaC、アプリケーションコード、設計書 | 稼働中のアカウントのリソース(IaC は別途アップロード) |
| 対象の柱 | 6 本すべて | コスト最適化、セキュリティ、回復性、パフォーマンスの 4 本 |
| AWS アカウントへのアクセス | 原則なし(権限は wellarchitected:Get* と wellarchitected:List* まで) |
利用者が作成した読み取り専用の IAM ロールでアクセス |
| 実行タイミング | 任意 | 週次の自動更新(アーキテクチャレビューは任意) |
| 出力 | Markdown 形式のレポート | 管理コンソール または wellarchitected の API |
| 前提条件 | aws-core プラグインを入れたコーディングエージェント | Business+ 以上の AWS サポートプラン |
実環境を見られるかどうかで、判定可能な質問が変わります。サンプルの各サービスは 1 vCPU、2 GB の固定サイズのタスクで動いていますが、その値が実際の負荷に対して多いのか少ないのかは、IaC を読んでも分かりません。スキルには AWS の API を呼ぶ手順がないので、この質問は判定できないまま残ります。Agent は Compute Optimizer のサイズ判定を取り込むので、こうした過不足を判定できます。逆に full モードの Critical のように、Java のコントローラにある未認証のエンドポイントと、Terraform で UI が公開 ALB の後ろに 1 タスクだけ置かれていることを突き合わせた指摘は、アプリケーションコードを読まなければ出てきません。
デプロイ前はスキルでコードをレビューし、デプロイ後は Agent で稼働中の環境をレビューする、という分担になりそうです。
おわりに
Agent Toolkit for AWS の aws-well-architected-review スキルを、公開サンプルに対して 3 つのモードで動かしてみました。手軽に試せるので、まずは score モードか quick モードで動かしてみて全体をつかんでみるのが良いでしょう。非対話モードで動くので、CI に組み込んで定期的にレビューを実施し、Critical や High の指摘を棚卸しする使い方もできます。結果は実行ごとに変わるので、1 回の結果だけで「問題なし」と判断しないことと、コードから判定できない Cannot Determine の項目は人が判断することだけ、頭に置いておくとよいと思います。