- 武田大輝
- 約 4,700 文字
目次
秋のブログ週間2026 の3本目です。
はじめに
読書の秋ですね。みなさんは技術書をどのように読んでいますか。
私は技術書が好きです。気になった書籍はお金を惜しまず、すぐに購入すると決めています。しかしながら、技術書を読む時間というのはなかなかどうして確保できないもので、積読本を数えたら枚挙に暇がありません。だからこそ、読む速さも、読んだ内容が身につく速さも上げたいと常々思っています。
最近は、生成 AI を活用した読書法をいろいろ試しています。その中でも音声会話機能を使った読書の体験が良かったので、紹介したいと思います。
原点は『本を読む本』
私の読書法の原点は、M.J.アドラーと C.V.ドーレンの『本を読む本』(外山滋比古、槇未知子訳、講談社学術文庫、1997年)です。原著は1940年の刊行ですが、技術書に限らず本を読むときに私が意識していることの多くは、この本の影響を受けています。
この本は、読書を4つのレベルに分けて説明しています。
初級読書
書かれている文字や文章を読んで意味が理解できる。「この文は何を言っているのか」が分かるレベルで、小学校で習う読みの習得がこれにあたる。点検読書
限られた時間の中で、本の内容をできる限り把握する。表題、序文、目次、索引などを系統立てて拾い読みし「その本は何について書かれたものか」「どういう種類の本か」が分かる。分析読書
時間をかけて1冊を徹底的に読み、本を自分のものにする。余白に書き込みながら読み「全体として何についての本か」「何がどのように詳しく述べられているか」「全体として真実か、あるいはどの部分が真実か」「どんな意義があるか」の4つの問いに答えられる。シントピカル読書
1つの主題について、複数の本を関連付けて読み比べる。「その主題について、それぞれの本は何を言っているか」を突き合わせ、どの本にも書かれていない自分なりの見方を組み立てられる。
この4つのレベルを身につけると、どの本にどのくらい時間をかけて、どのレベルまで読むかを、書籍ごとに決められます。目次だけ見て点検読書で済ませる本もあれば、腰を据えて分析読書まで持ち込む本もある、という読み分けです。
この読書法を紙の書籍だけで実践していたころは、それなりに時間がかかりました。分からない用語は都度調べ、気付いたことがあれば本を置いてメモをとり、複数の本を読み比べるときは机に何冊も広げていました。読み終えたあとに読書記録を作るのも一仕事です。ふせんのメモを見返しながら、章ごとに要点と自分の意見を書き起こすつもりでいるのですが、面倒になって次の本に手が伸び、記録が残らない本のほうが多かったです。
生成 AI が使えるようになって、このあたりは劇的に省力化できるようになりました。用語や訳語はその場で聞けば説明が返り、メモを整理して読書記録として残してくれます。この読書法そのものは80年前のものですが、その考え方は今も変わらず、生成 AI 時代でも効果的です。むしろ、面倒だった部分が減ったぶん実践しやすくなったので、『本を読む本』をまだ読んでいない人には、ぜひお勧めしたい 1 冊です。
紙書籍 or 電子書籍
永遠のテーマだと思います。個人的には、理屈抜きで紙の書籍そのものが好きなのですが、読書の利便性を考慮すると電子書籍に軍配が上がるでしょう。お金に糸目をつけず紙と電子の両方を買うこともあります。
特に生成 AI のコンテキストとして書籍の情報を与える場合は、紙ではなく電子の形式が望ましいでしょう。訳語が気になった箇所の原文をその場で引いてもらう、質問への答えがどの章のどの記述にもとづくかを確かめる、というような使い方ができます。ただし、生成 AI のインプットとして電子データを利用する場合は、著作権法や利用規約に違反しないよう注意が必要です。
電子書籍には、購入者以外が開けないように暗号化され専用アプリケーションでしか読めない DRM 付きのもの(Kindle など)と、PDF や EPUB のファイルをそのまま受け取れる DRM フリーのものがあります。生成 AI にファイルとして渡すことができるのは後者だけです。DRM を外して複製するのは、私的使用のためであったとしても著作権法で認められていません。技術書は、O’Reilly Japan、技術評論社(Gihyo Digital Publishing)、翔泳社(SEshop)、達人出版会のように、出版社の直販で DRM フリーのものを購入できることが多いです。ただし、DRM フリーは著作権フリーではありません。個人利用に限る、再配布しない、といった規約は当然付いていますし、生成 AI のインプットにすることを利用規約で認めていない場合もあるので、販売元の規約を読んでおく必要があります。
生成 AI への入力を規約で明示的に禁止している例として、O’Reilly の学習プラットフォーム(O’Reilly Learning Platform)があります。Membership Agreement をみると、コンテンツを AI への入力やプロンプトとして渡すことと、AI の学習に使うことを、著作権者の書面による許可なしには認めていません。
DRM 付きの電子書籍を画面キャプチャで PDF 化するソフト「0秒読書」(ソースネクスト、2026年2月発売)に対して、出版業界が抗議している といった事例もあります。発売元は著作権侵害に当たらないとしていますが、出版側は海賊版への悪用を懸念しています。自分で買った本を自分のために複製するなら私的使用の範囲に入りうる、という整理もある一方で、キャプチャ自体を規約で禁じている電子書籍サービスもあり、見解は割れています。
現時点では、DRM フリーのものを、学習データへの利用をオプトアウトしたうえで、個人の学習に閉じた範囲かつ利用規約の範囲内で使うのが良いでしょう。各自の責任で慎重に判断してください。
生成 AI と一緒に読むしくみ
準備するものは3つです。書籍をコンテキストとして読ませること、システムプロンプトを設定すること、音声会話モードをオンにすることです。私は Claude を利用していますが、特定のプロダクトに限った機能ではないので、手元の生成 AI に置き換えて読んでください。
書籍をコンテキストとして読ませる
PDF 形式の書籍をコンテキストとして登録しておき、会話のたびに参照させます。Claude ならプロジェクトのコンテキスト、ChatGPT ならプロジェクトのソースなどが、登録場所にあたります。私は書籍ごとにプロジェクトを作っています。
システムプロンプトを設定する
生成 AI の振る舞いをシステムプロンプトとして最初に決めておきます。Claude や ChatGPT ならプロジェクトの指示として指定する内容です。私が使っているシステムプロンプトの要点は次のとおりです。
システムプロンプトのサンプル
## 役割 |
音声モードをオンにする
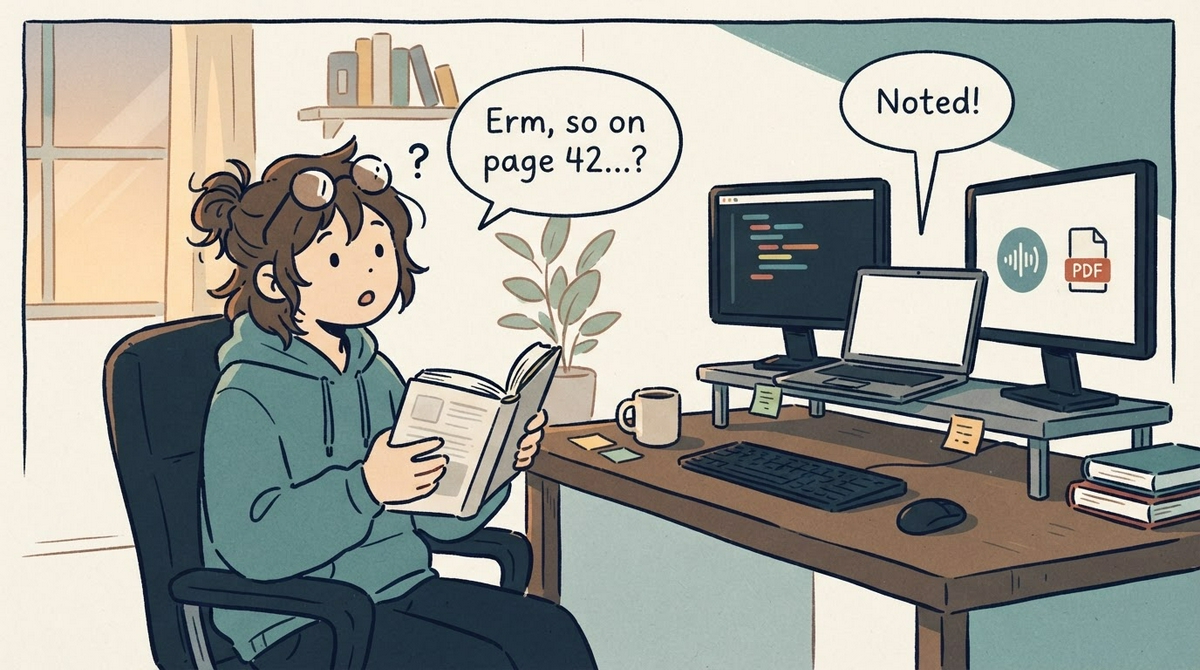
本から手を離さずに話せることが、この読書法の要です。Claude や ChatGPT には音声モード(音声会話機能)があり、Voice to Voice でリアルタイムに会話ができます。このあとのセクションで実際の会話の例を紹介しますが、これが読書中の体験としてとても良いものでした。
全体的な流れ
全体的な読み方の流れはこうです。
- 読書中は音声モードを常にオンにする
- 章を読み始める前にその章の要点を話してもらう
- 本を読み、気になった箇所でとにかくつぶやく
- 感想はメモとして、疑問は質問として、生成 AI が振り分けてメモをとりながら回答してくれる
- 会話を切りたいときは「以上」や「黙って」と言って読書に戻る
- 章を読み終えたら、その章の総括をひとことつぶやく
- 全部読み終えたら、メモを章ごと、カテゴリごとに整理して出力させる
つぶやきの実例
ある技術書を読んでいたときのやりとりをいくつか載せます。載せるのは記事用に整えたものです。実際の発言はこの何倍もラフで、回数もずっと多く、1冊で 130 件ほどのメモと 50 件ほどの Q&A が残りました。多かったのは、感想をつぶやいて一言で記録してもらうやりとりです。
自分:グリーンフィールド開発とブラウンフィールド開発って言葉、初めて聞いた。白紙から作る新規開発と、既存コードの制約の中でやる開発のことね
Claude:メモしました。1章・グリーンフィールドとブラウンフィールドを、新たな発見として記録します。
返事は一言で、読書の流れが止まりません。こうして「発見」として記録した用語は、読み終えたあとの整理で一覧にしてもらいます。この書籍で初めて知った知識が何だったかを、あとから見返せます。
訳書を読んでいて日本語訳に引っかかったときは、本を置かずに原文を確かめます。
自分:「キャッシュはシステム内の稼働部品のようなもの」って表現があるけど、稼働部品って原文ではどう書かれてる?
Claude:原文では「moving part」ですね。”A cache is another moving part in your system that can fail, go stale, or consume resources.” 機械は可動部が多いほど故障箇所が増える、という含みがあるので、「稼働部品」より「可動部品」のほうが原語のニュアンスに近いです。
これは原著を生成 AI のコンテキストに持たせているからこそできることです。翻訳書を徹底的に理解したい場合は、原著を参照させると理解が深まります。
分からない用語も、その場で聞きます。
自分:パレートの法則に従えば、ハッピーパスはコード全体の20%に過ぎない、って書いてあるけど、パレートの法則ってなんだっけ?
Claude:結果の80%は原因の20%から生まれる、という経験則です。80対20の法則とも呼ばれます。経済学者のヴィルフレド・パレートが富の偏りを見つけたことが由来です。
そして、会話を切るときはこうです。
自分:以上、黙って。
Claude:了解です。
生成 AI がつい喋りすぎてしまうときは、すぐに遮って読書に戻ります。
どのやりとりも、読書の集中を切らさずに、読みながらこなせます。感想は一言で受け取ってもらい、質問には短く答えてもらい、長くなりそうなら切る。この調子で 1 冊を読み通しました。
おわりに
この読み方は今までにない読書体験で手応えがありました。なぜ良いと感じたのか言語化してみようと思います。
1 つ目は、読書の集中が途切れないことです。音声会話を使わずに読んでいたころは、用語を調べるために本を置き、メモを書くために本を置き、そのたびに読書が中断していました。声のやりとりで済むなら本を置かずに済みます。分からない用語は聞けば返ってきて、感想は言えば記録されるので、常に読書に集中できます。
2 つ目は、途中でメモを取らなくても、最後に整理されたメモが残ることです。読んでいる最中は読むことに集中し、整理は生成 AI に任せます。読み終えたあとには、どの章でどんな質問をしたか、何を初めて知ったか、どこに引っかかったかが、章ごと、種別ごとにそろって手元に残ります。読んだ直後に自分の疑問と学びを一通り見返せるので、振り返りの質が上がりました。
3 つ目は、おかしいと思った点を、その場で壁打ちできることです。一人で読んでいると、引っかかる箇所があっても「そういうものか」でスルーしがちです。リアルタイムで応答してくれる相手がいると「ここは変だ」と口に出せて、一緒に確かめ、会話のように続けられます。一般論をもとに賛成してくれることもあれば、解釈が違うと指摘されることもあります。
ぜひ試してみてください。